


Python collections.deque是序列类型吗?

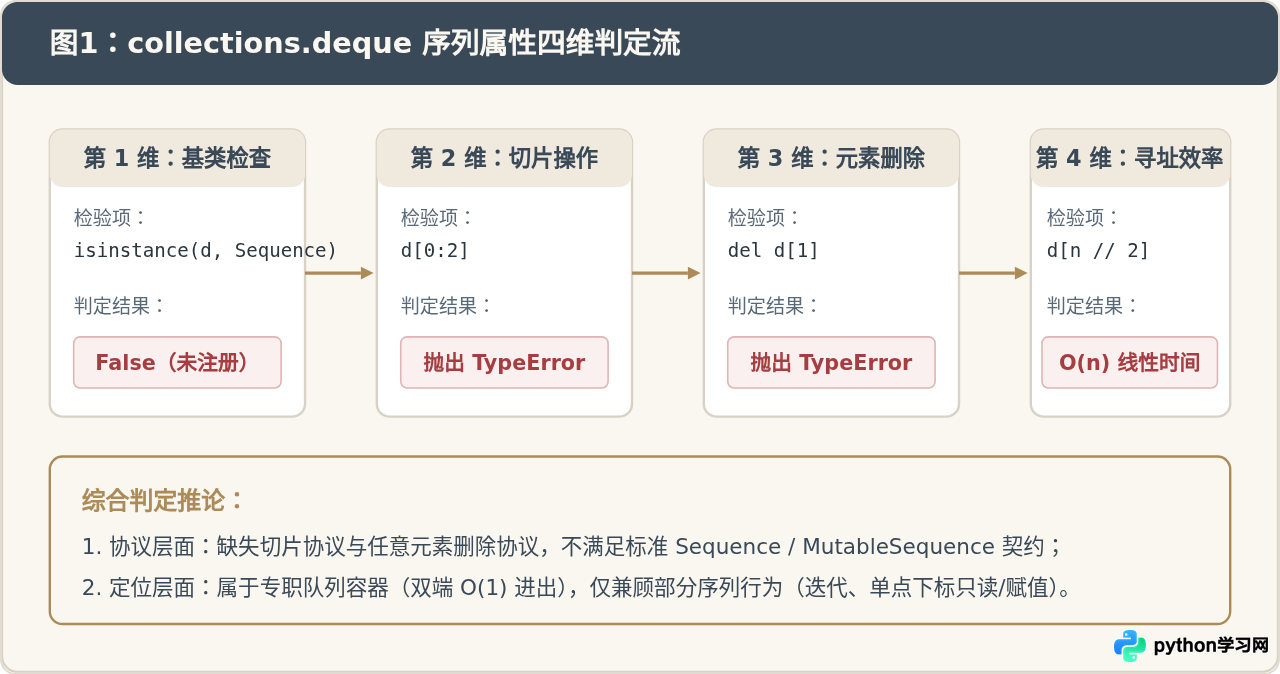
核心结论:在 Python 官方抽象基类(collections.abc.Sequence)的严格判定体系下,collections.deque 不是序列类型;但在日常使用的广义鸭子类型(Duck Typing)视角下,它支持索引读取、迭代与长度统计,具备典型的序列行为特征。这种“表象像序列、官方却不给认证”的现象,根源在于它不支持切片、不支持任意位置删除,且中间索引访问开销高昂。
一、使用代码验证:官方抽象基类体系下的真实身份
判断一个对象在 Python 中是否属于某种抽象容器类型,最直接且严谨的方式是借助标准库的 collections.abc 模块进行类型比对。
Python 提供了两个核心基类:表示只读序列的 Sequence 与表示可变序列的 MutableSequence(如常见的 list)。我们可以直接在交互环境中测试 deque 的归属:
from collections import deque
from collections.abc import Sequence, MutableSequence

d = deque([10, 20, 30])

# 检验是否属于通用序列(Sequence)
print("isinstance Sequence:", isinstance(d, Sequence))        # 示例输出: False
print("issubclass Sequence:", issubclass(deque, Sequence))    # 示例输出: False

# 检验是否属于可变序列(MutableSequence)
print("isinstance MutableSequence:", isinstance(d, MutableSequence))      # 示例输出: False
print("issubclass MutableSequence:", issubclass(deque, MutableSequence))  # 示例输出: False
检验结果均为 False。作为对比,标准的 list 类型在上述检验中均会输出 True,而 tuple 则是 Sequence 的子类。这明确证实:Python 标准库并未将 deque 注册为官方序列类型。
二、为什么没有成为序列?被官方剥离的两大核心契约
很多开发者会产生疑惑:既然 deque 支持 len(d),也支持用下标读取元素 d[0] 或修改元素 d[0] = 99,为什么不能算作序列?这主要由于它缺失了序列类型的两项关键操作契约:
1. 不支持切片语法(Slicing)
在 Python 的标准定义中,序列对象(无论是只读的 tuple、str 还是可变的 list)都必须完整支持切片操作 [start:stop:step]。然而如果对 deque 执行切片,解释器会立即抛出异常:
from collections import deque

d = deque(["alpha", "beta", "gamma", "delta"])

try:
    sub = d[1:3]
except TypeError as err:
    print("错误提示:", err)
# 示例输出: 错误提示: sequence index must be integer, not 'slice'异常信息非常明确:sequence index must be integer, not 'slice'。Python 解释器在底层 C 实现中直接拒绝了切片对象传入。
2. 不支持任意位置的元素删除(del d[i])
对于可变序列类型(如 list),通过索引直接删除元素 del my_list[i] 是基本能力之一。而在 deque 上执行删除同样会触发类型错误:
from collections import deque

d = deque([100, 200, 300])

try:
    del d[1]
except TypeError as err:
    print("删除错误:", err)
    # 示例输出: 删除错误: sequence deletion not supported
虽然 deque 拥有 .pop() 与 .popleft() 方法用于高效弹出两端元素,且拥有 .remove(value) 用于按值匹配移除首个元素,但它刻意不支持基于下标的 del d[i]。
三、底层架构剖析:为什么 deque 这样设计?
标准库开发者没有为 deque 补齐切片和中间删除功能,并非技术难度所致,而是出于算法时间复杂度与性能契约的深思熟虑。
list 与 deque 在内存布局上存在本质差异:
- list(动态连续数组): 内存中是一块连续分配的指针数组。访问任意索引
list[i]时,直接根据起始地址与偏移量计算,时间复杂度为严格的O(1)。切片也能在内存中进行高效的数据批量拷贝。但其缺点是在头部执行插入或删除(如list.insert(0, x)或list.pop(0))时,后续所有元素都必须在内存中平移,开销为O(n)。 - deque(双向块链表): 底层由一系列固定容量的“块”(Block,默认每个块容纳 62 个元素)通过双向指针串联而成。头部与尾部的入队出队仅操作首尾两个块,耗时稳定为
O(1)。但要读取位于中间的元素d[i],必须沿着链表块逐个跳转寻址,时间复杂度退化为O(n)。
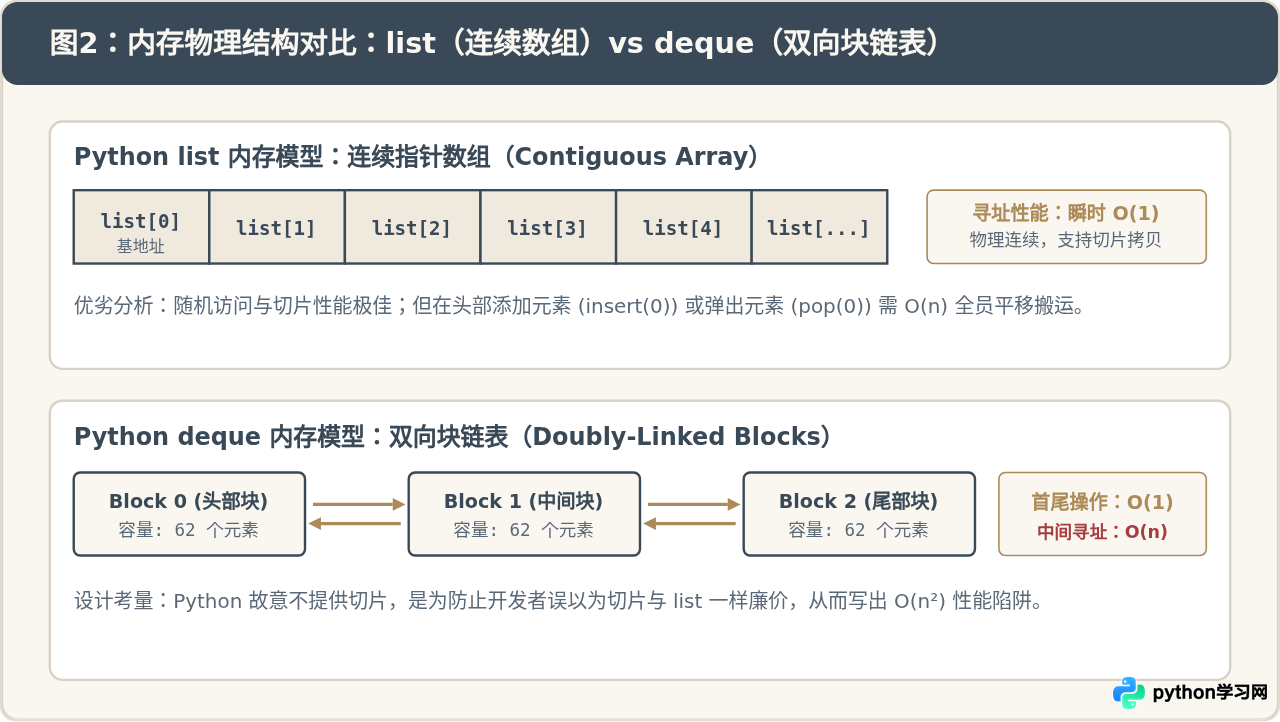
s[a:b] 给使用者的心智模型是极其平滑的轻量表达。如果在链表结构的 deque 上允许随意切片,用户极易写出遍历切片的嵌套代码,导致系统性能断崖式下跌。禁用切片和随意删除,是强迫调用者采用最合理的队列工作模式。
四、容器协议与能力横向对比
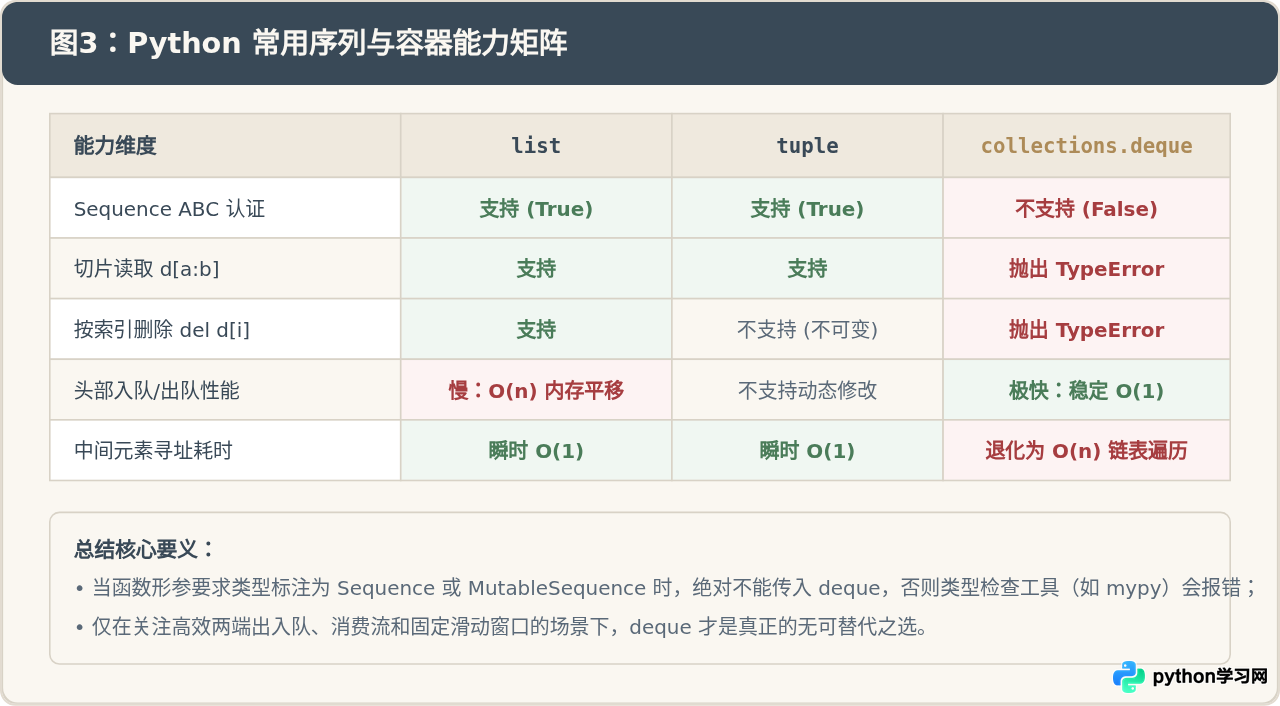
为了让不同容器的特性边界一目了然,下表汇总了 list、tuple 与 collections.deque 在协议实现与常见操作上的支持情况:
| 功能特性 / 协议标准 | list(列表) | tuple(元组) | collections.deque(双端队列) |
|---|---|---|---|
| collections.abc.Sequence | 是 (True) | 是 (True) | 否 (False) |
| collections.abc.MutableSequence | 是 (True) | 否 (不可变) | 否 (False) |
| 单索引读取与修改 (d[i]) | 读取与修改均为 O(1) | 仅支持 O(1) 读取 | 两端 O(1),中间读取/修改退化为 O(n) |
| 切片操作 (d[a:b]) | 支持 | 支持 | 不支持 (TypeError) |
| 元素任意删除 (del d[i]) | 支持 (O(n)) | 不支持 (不可变) | 不支持 (TypeError) |
| 两端添加/弹出元素 | 尾部 O(1);头部 O(n) | 不支持修改 | 头部与尾部均稳定为 O(1) |
| 容量限制 (maxlen) | 无内置限制机制 | 固定长度不可变 | 原生支持固定容量滑动窗口 |
五、实战选型与开发避坑指南
在日常开发与架构设计中,面对序列与队列容器的选择,应遵循以下决策依据:
1. 如何为 deque 截取类似切片的局部子集?
如果业务逻辑中确实需要获取 deque 的前 $k$ 个元素,应通过标准库工具 itertools.islice 代替直接切片,或者在必要时将其转为列表:
from collections import deque
from itertools import islice

d = deque([10, 20, 30, 40, 50])

# 正确做法 1:借助 islice 惰性迭代提取
first_three = list(islice(d, 0, 3))
print("islice 结果:", first_three)  # 示例输出: [10, 20, 30]

# 正确做法 2:一次性转为标准 list 后切片(注意有内存复制开销)
sub_list = list(d)[1:4]
print("list 切片结果:", sub_list)    # 示例输出: [20, 30, 40]
2. 类型注解中的规范写法
编写类型标注时,如果函数只需要按顺序迭代,形参应声明为更宽泛的 Iterable[T] 或 Collection[T],避免写成 Sequence[T]:
from typing import Iterable, Sequence
from collections import deque

# 规范做法:接收任意可迭代对象(list, tuple, deque 均可正常通过 mypy 校验)
def process_items(items: Iterable[int]) -> int:
    return sum(items)

# 局限做法:标注为 Sequence 会导致传入 deque 时触发静态类型报警
def strict_sequence(items: Sequence[int]) -> int:
    return items[0]  # mypy 会提示 deque 不是 Sequence 的有效实参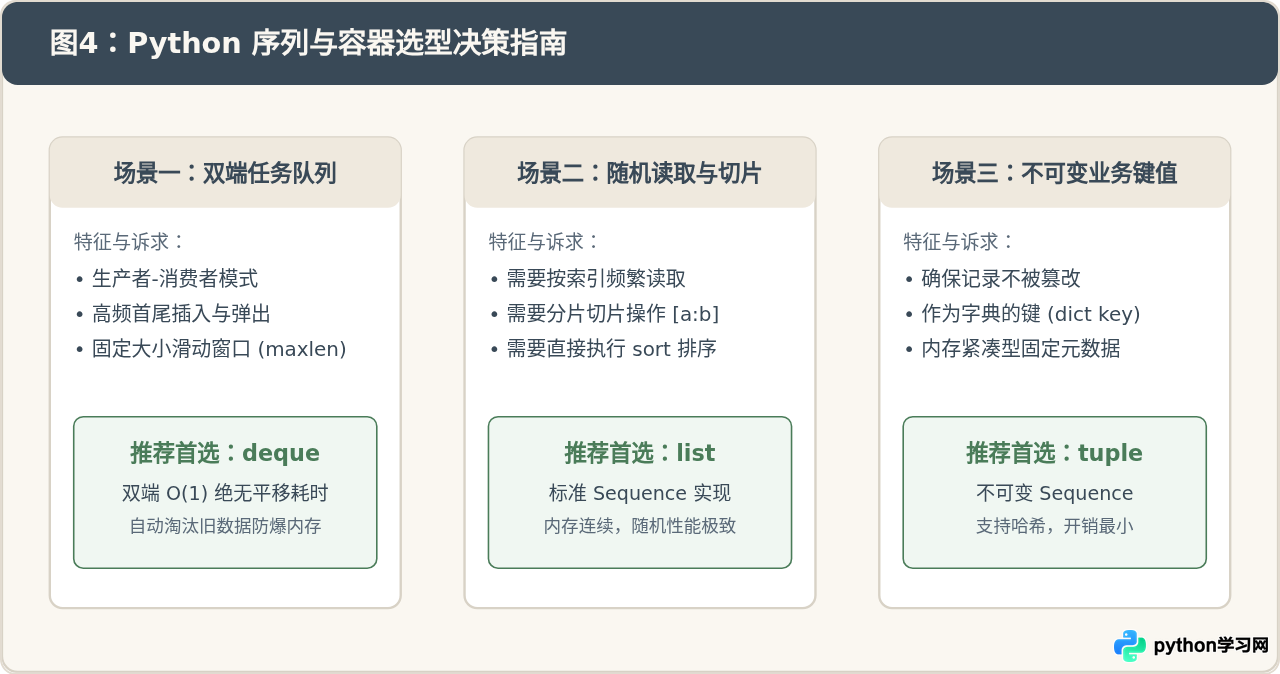
六、全文总结
回到文章开篇的核心问题——Python collections.deque 是序列类型吗?
准确的回答取决于你考察的视角:
- 从 Python 官方类型系统与契约标准来看:不是。 它未注册、也无法通过
collections.abc.Sequence或MutableSequence的子类校验。它明确不支持切片语法,也禁止通过del d[i]剔除指定元素。 - 从数据结构与算法复杂度来看:它是双端队列,不是随机访问序列。 它的块状双向链表结构为两端进出提供了绝对的 $O(1)$ 保障,但在中间寻找元素的复杂度是 $O(n)$。官方正是通过剥离切片接口,守护了 Python 代码的性能可预测性。
- 从日常鸭子类型的调用体验来看:它兼具部分序列语法。 它支持正负整数索引、
len()统计、in包含检测以及直接遍历。
理解这层界限后,在编写涉及切片、快速索引或泛型序列标注的代码时,应坚持使用 list;而在实现先进先出(FIFO)、后进先出(LIFO)或定长滑动缓存时,大胆使用 collections.deque 即可发挥其极致性能。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















