


Python range和bytes属于序列类型吗?
深入解析Python中range和bytes是否属于序列类型,从官方数据模型协议、内置抽象基类判定、底层存储结构与实际操作特性,全面阐述range与bytes的序列本质与设计考量。
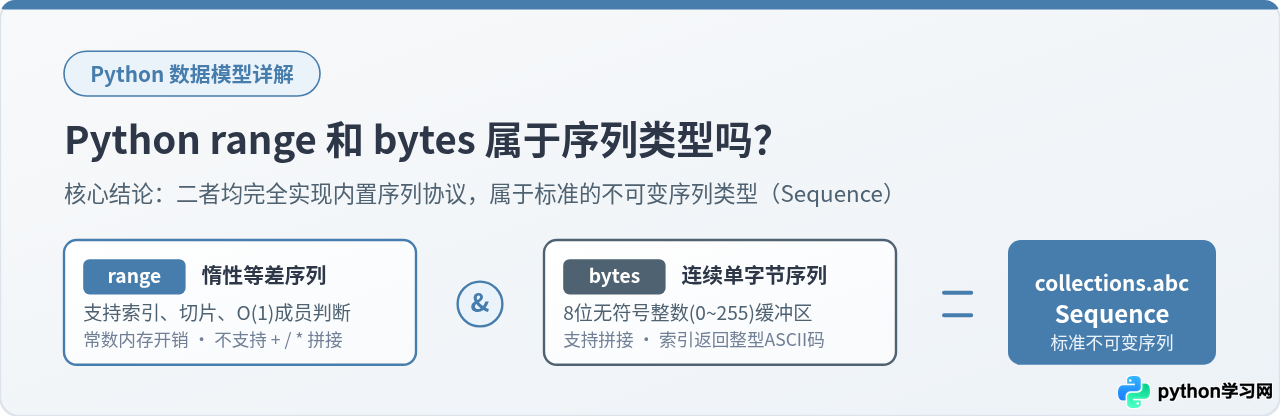
range 和 bytes 都严格属于内置序列类型(Sequence Types)。更准确地说,它们与 tuple、str 共同构成了 Python 标准库中的不可变序列(Immutable Sequences)家族。
在许多初学者乃至有一定开发经验的程序员印象中,range 往往被视作 for 循环专用的“数字生成器”或迭代工具,而 bytes 则常被当成承载网络传输与文件读写的底层二进制缓冲区。这种使用习惯容易让人忽略它们在 Python 数据模型中的真实定位。实际上,只要借助标准库抽象基类 collections.abc.Sequence 进行检验,或者按照 Python 序列协议逐项比对,就会发现它们完全具备序列的所有核心特征。
一、序列类型的判定基准:Python 如何定义“序列”?
在 Python 的面向对象设计中,一个对象是否属于“序列”,并不是由表面名称决定的,而是由它所实现的协议接口(Protocol)决定的。官方文档明确指出:序列是一种包含确定顺序元素的容器,并且能够通过非负整数进行偏移索引访问。
要成为 Python 标准序列,对象必须满足以下两项基本契约,同时具备一系列衍生行为:
- 确定长度(
__len__):能够通过内置函数len(s)获取集合包含的元素总数,且返回值必须是非负有限整数。 - 基于整数的索引访问(
__getitem__):能够接受非负整数0 <= i < len(s)以及负数索引-len(s) <= i < -1,并准确取出对应位置的元素。若索引越界,抛出IndexError。 - 切片支持(Slicing):
__getitem__同时能够接收slice切片对象,提取指定步长和区间的子集,通常返回同类型的子序列。 - 包含与迭代(
__contains__与__iter__):支持x in s成员检查,支持for item in s正向遍历,以及通过reversed(s)实现反向迭代。 - 通用序列方法:提供
s.index(x)定位元素首次出现的索引,以及s.count(x)统计元素出现频次。
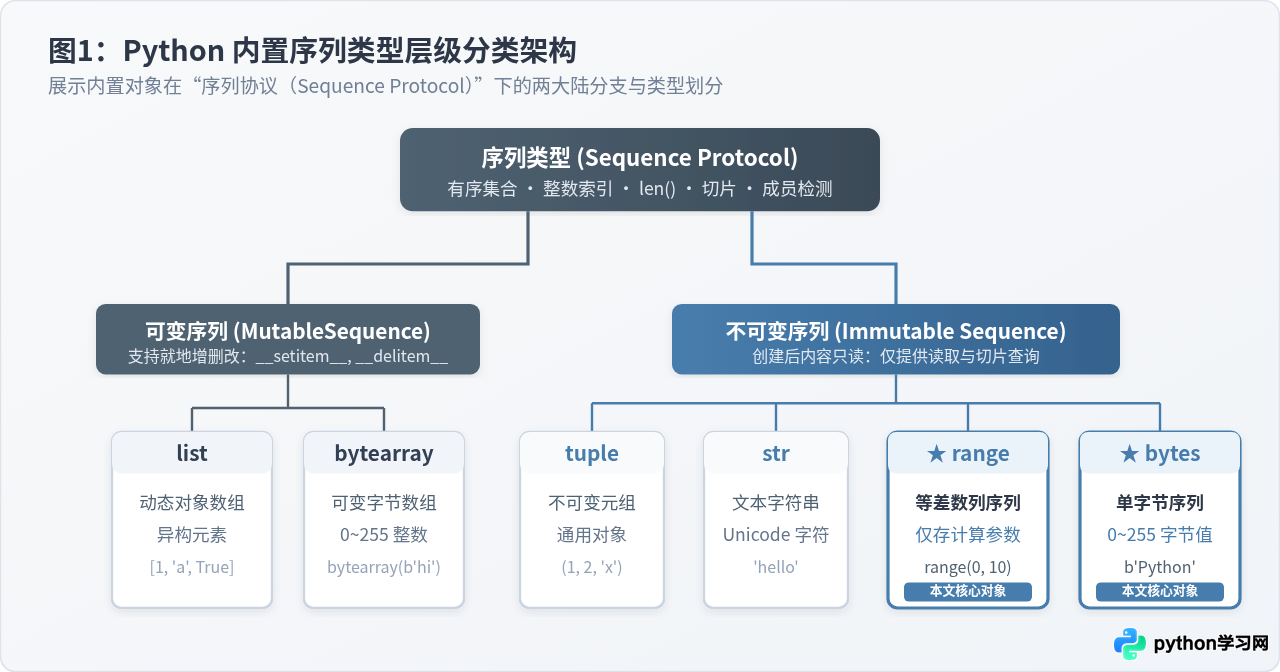
在标准库 collections.abc 模块中,官方抽象基类 Sequence 与 MutableSequence 将序列清晰地划分为两大分支:
- 可变序列(
MutableSequence):除读取外,还实现了__setitem__和__delitem__,允许就地更改、追加与删除元素。典型的内置类型包括列表(list)与可变字节数组(bytearray)。 - 不可变序列(
Sequence):一旦创建,其内部元素序列与长度便完全锁定,仅提供只读查询与切片派生。内置的元组(tuple)、字符串(str)、范围对象(range)和只读字节串(bytes)均属于此类。
我们可以在 Python 解释器中直接运行以下代码进行类型审查:
from collections.abc import Sequence, MutableSequence

# 实例化 range 与 bytes 对象
r = range(0, 10, 2)
b = b"Python"

# 检验 range 是否为 Sequence
print(isinstance(r, Sequence))         # 示例输出: True
print(isinstance(r, MutableSequence))  # 示例输出: False

# 检验 bytes 是否为 Sequence
print(isinstance(b, Sequence))         # 示例输出: True
print(isinstance(b, MutableSequence))  # 示例输出: False
运行结果确凿无疑:range 和 bytes 都毫无争议地通过了 Sequence 判定,同时排除了 MutableSequence。
二、推导与验证:序列协议的行为检测流程
抽象基类的判定背后,依赖的是底层具体行为的完备性。为了让读者透彻理解判定过程,我们可以通过一个标准推导流程来检验任意对象是否胜任序列角色:
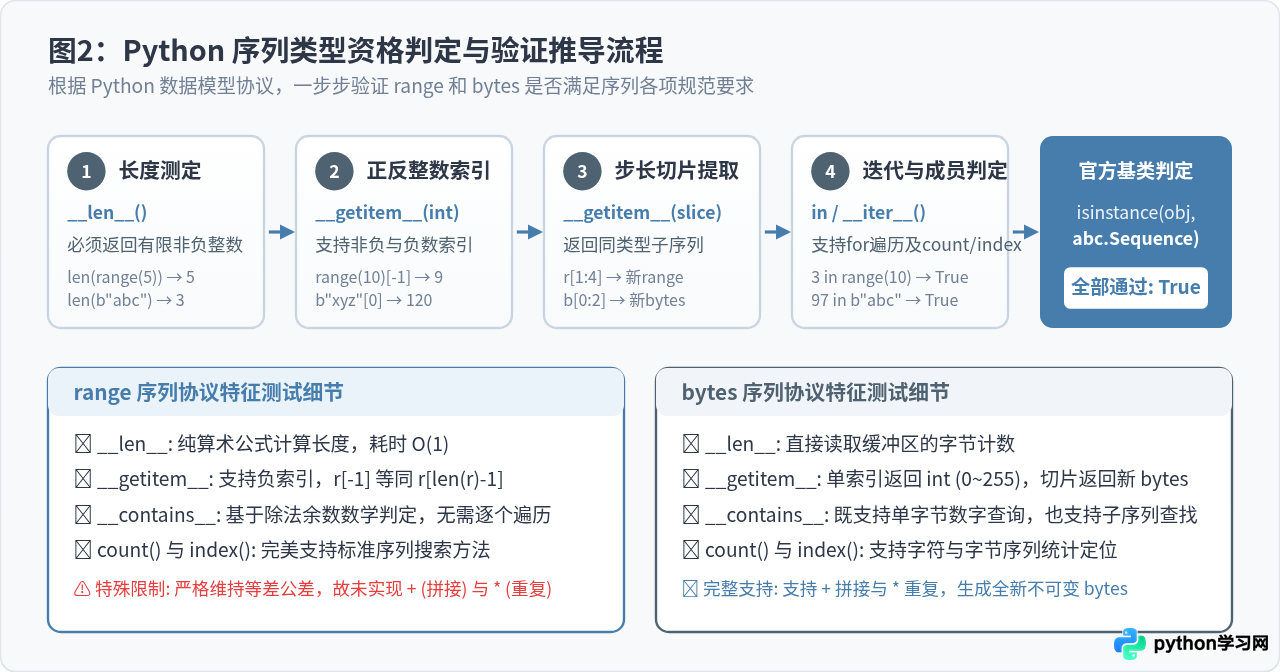
按照上述推导步骤,我们分别在 range 和 bytes 上进行具体代码验证:
# --- 1. 验证 range 的序列行为 ---
r = range(10, 50, 5)  # 序列元素: 10, 15, 20, 25, 30, 35, 40, 45

# 步骤 1: 测定长度
print(len(r))            # 示例输出: 8

# 步骤 2: 正负整数索引
print(r[0], r[2], r[-1])   # 示例输出: 10 20 45

# 步骤 3: 切片提取(返回新的 range 序列)
sub_r = r[1:5]
print(sub_r)             # 示例输出: range(15, 35, 5)
print(list(sub_r))       # 示例输出: [15, 20, 25, 30]

# 步骤 4: 成员检测与序列搜索
print(25 in r)           # 示例输出: True
print(r.index(25))       # 示例输出: 3
print(r.count(25))       # 示例输出: 1

# --- 2. 验证 bytes 的序列行为 ---
b = b"Python"

# 步骤 1: 测定长度
print(len(b))            # 示例输出: 6

# 步骤 2: 正负整数索引(注意返回的是对应的整型字节值 0~255)
print(b[0], b[-1])        # 示例输出: 80 110 ('P' 和 'n' 的 ASCII 码)

# 步骤 3: 切片提取(返回新的 bytes 序列)
print(b[0:2])            # 示例输出: b'Py'

# 步骤 4: 成员检测与序列搜索
print(b"th" in b)        # 示例输出: True
print(80 in b)           # 示例输出: True (同样支持整型单字节值查找)
print(b.index(b"t"))     # 示例输出: 2
三、深入解析 range:常数级内存开销的惰性算术序列
既然 range 属于序列,为什么它常常被人误以为只是一个生成器或迭代器?这源于它极为特殊的底层实现模型。
1. 为什么 range 是序列而不是迭代器(Iterator)?
在 Python 中,“迭代器(Iterator)”与“序列(Sequence)”有着根本性的界限:
- 迭代器是一次性消耗品:只能通过
next()向前单向读取,不支持获取长度len(),不支持随机索引it[3],也不支持切片it[1:5]。一旦遍历完毕,迭代器就彻底枯竭。 - range 是真正的可重入容器序列:你可以对同一个
range对象遍历无数次,也可以在任何时刻以 $O(1)$ 的时间复杂度直接读取r[100],或者反复计算len(r)。
2. 惰性计算与常数级内存占用
传统的 list 或 tuple 在内存中实打实地保存着每一个元素的指针或数值。如果要容纳一千万个整数,list 需要开辟数百兆字节的连续内存。
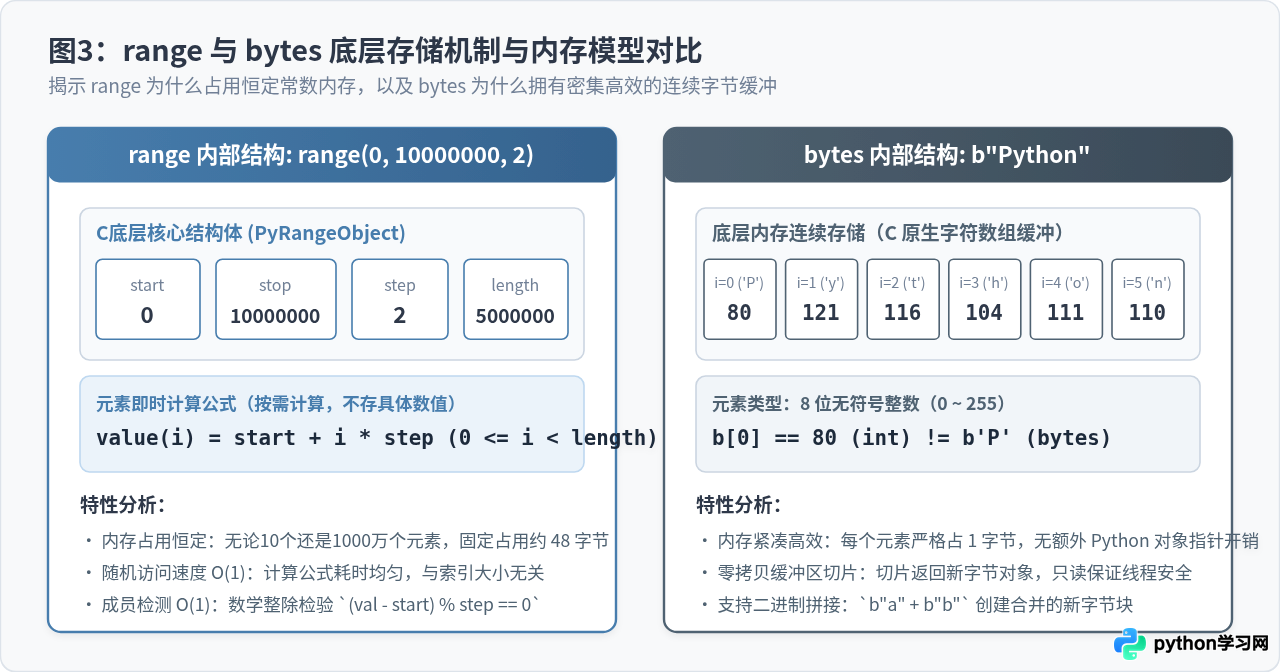
而 range 采用的是惰性算术级数模型(Arithmetic Progression)。不管你的范围是 range(10) 还是 range(1000000000),它在 CPython 底层结构体(PyRangeObject)中仅存储 4 个属性值:start、stop、step 和预先算好的 length。无论数据跨度有多大,其内存开销固定只有约 48 字节。
当你执行
1000000000 in range(0, 2000000000, 2) 时,Python 绝不会从 0 遍历到 10 亿!它直接利用等差数列公差进行算术判断:只要检查目标值是否在 start 与 stop 之间,且 (val - start) % step == 0。因此其运算速度是瞬时完成的。
3. 特殊限制:为什么 range 不支持 + 拼接与 * 重复?
细心的读者可能会发现,标准序列常见的拼接运算(s1 + s2)与重复运算(s * n),在 range 上却会报错:
range(3) + range(3, 6)
# 报错: TypeError: unsupported operand type(s) for +: 'range' and 'range'
原因解释:这是 Python 语言设计上的有意取舍。range 的核心类型不变式(Type Invariant)是“必须能表示为一个具有固定起始点与恒定步长的等差数列”。如果允许拼接,两个任意的 range(例如 range(0, 3) 与 range(10, 20, 2))合并后的集合在绝大多数情况下根本无法用单一等差数列表示。如果拼接返回 list,就打破了操作的类型一致性;如果直接禁止,则能完全保证 range 内部结构的简洁与自洽。Python 官方文档在序列协议章节中明确标注了这一合理例外。
四、深入解析 bytes:定长连续存储的不可变单字节序列
bytes 是 Python 3 中用于处理二进制数据的最核心类型。从定义上看,它是一个元素取值受限在 0 到 255 之间的 8 位无符号整数不可变序列。
1. 为什么索引 bytes 会返回 int 而不是 bytes?
这是刚接触二进制处理的开发者最常踩的坑。对比字符串(str)与字节串(bytes):
s = "Python"
print(s[0], type(s[0]))    # 示例输出: 'P' <class 'str'>

b = b"Python"
print(b[0], type(b[0]))    # 示例输出: 80 <class 'int'>
在 Python 中,单字符字符串 "P" 依然是长度为 1 的 str 序列。然而在机器底层,计算机并没有所谓的“字符”,只有字节数值(Byte Value)。因此,bytes 的元素本质就是 0 到 255 之间的无符号整数,其单索引 b[i] 直接返回该位置的整数值。
如果你的业务逻辑确实需要获取一个长度为 1 的 bytes 子对象,正确做法是利用切片:
print(b[0:1], type(b[0:1])) # 示例输出: b'P' <class 'bytes'>2. 与 bytearray 的孪生关系
bytes 与 bytearray 的关系,正如 tuple 与 list 的关系:
bytes是不可变的,底层内存缓冲区在创建完成后便设为只读,哈希固定(可作为字典键或集合元素)。bytearray是可变的(实现了MutableSequence),允许通过索引直接修改单个字节数值:ba[0] = 65,适合在音视频处理或高频网络包组装中避免频繁申请新内存。
五、全景对照:Python 内置主要序列类型能力矩阵
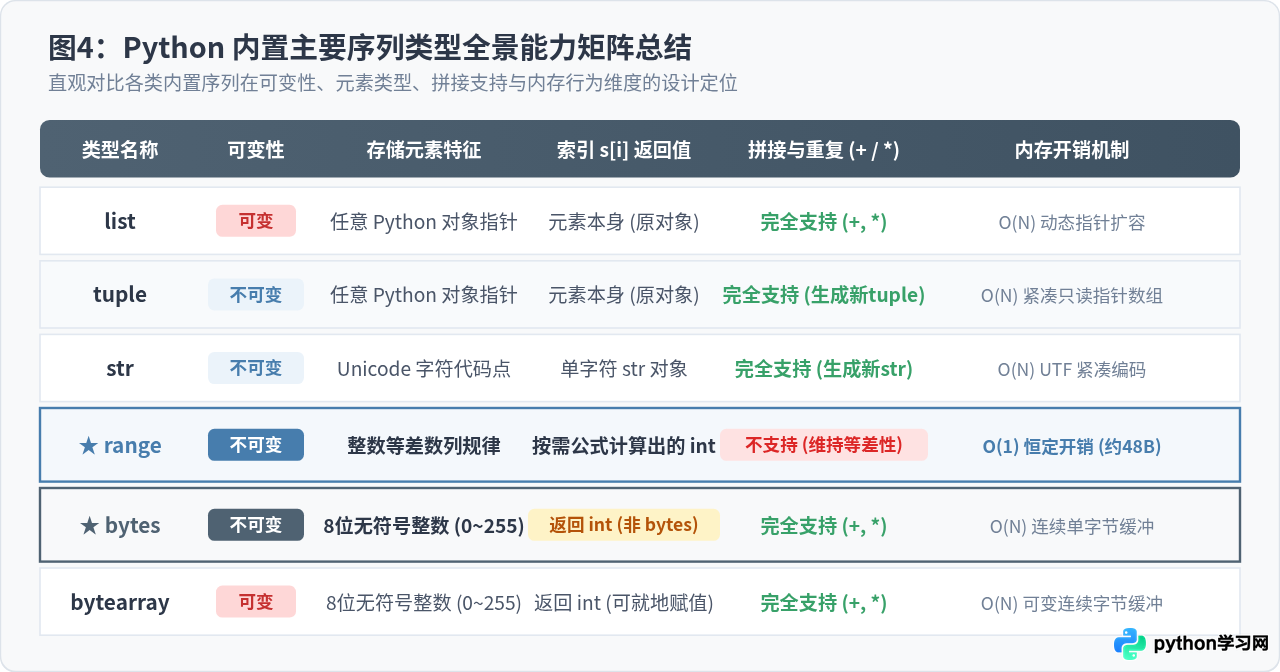
为了帮助读者建立结构化的系统认知,下表将 Python 常见的内置序列类型进行了全维度横向比对:
| 类型名称 | 可变性 | 内部存储元素 | 单索引 s[i] 返回类型 | 切片 s[i:j] 返回类型 | 支持 + / * 运算 | 典型内存占用特征 |
|---|---|---|---|---|---|---|
| list | 可变 | 任意 Python 对象指针 | 元素原对象 | 新 list | 支持 | $O(N)$ 动态扩容数组 |
| tuple | 不可变 | 任意 Python 对象指针 | 元素原对象 | 新 tuple | 支持 | $O(N)$ 紧凑定长数组 |
| str | 不可变 | Unicode 字符代码点 | 长度为 1 的 str | 新 str | 支持 | $O(N)$ 紧凑字符编码 |
| range | 不可变 | 有界等差整数规律 | 即时计算出的 int | 新 range | 不支持 | $O(1)$ 常数级固定开销 |
| bytes | 不可变 | 8 位无符号整数 (0~255) | int (数值 0~255) | 新 bytes | 支持 | $O(N)$ 连续字节缓冲区 |
| bytearray | 可变 | 8 位无符号整数 (0~255) | int (支持就地赋值) | 新 bytearray | 支持 | $O(N)$ 可变连续缓冲区 |
六、常见认知误区与实战避坑指南
误区 1:误以为 range 只能用于 for 循环一次性遍历
不少开发者在需要多次复用数字区间时,习惯性地写出 nums = list(range(1000))。如果仅仅是进行多次索引读取、成员判断或循环,完全没有必要转换为 list。直接保留 range 对象不仅能节省数十 KB 的堆内存,还能获得极快的多轮查询性能。
误区 2:使用 bytes 索引进行字符比对导致逻辑错误
b = b"hello"
# 错误写法:试图拿 bytes 字符与整数比对,恒为 False
if b[0] == b"h":
    print("匹配成功")  # 永远不会执行

# 正确写法 1: 与整型 ASCII 值比对
if b[0] == ord("h"):  # 104 == 104
    print("写法1匹配成功")

# 正确写法 2: 使用切片比对
if b[0:1] == b"h":
    print("写法2匹配成功")
误区 3:需要拼接多个 range 时不知所措
当业务确实需要将两个或多个区间衔接遍历时,由于 range 本身不支持 + 操作,推荐使用标准库 itertools.chain,它能在保持 $O(1)$ 惰性特性的前提下实现无缝连续遍历:
import itertools

r1 = range(0, 5)
r2 = range(10, 15)

# 无需转化为 list 耗费额外内存,保持惰性迭代
combined = itertools.chain(r1, r2)
for item in combined:
    print(item, end=" ")
# 示例输出: 0 1 2 3 4 10 11 12 13 14
总结
回到标题提出的问题:Python range 和 bytes 属于序列类型吗?
答案是完全属于。二者不仅在概念上属于有序序列,在官方类型系统中也完整继承与实现了 collections.abc.Sequence 的全部接口契约。range 代表了以算术公式为核心的常数内存不可变序列,而 bytes 则代表了以底层紧凑数组为核心的二进制单字节不可变序列。厘清它们作为序列的本质,不仅有助于我们更深入地理解 Python 的数据模型,还能在实际编程中写出内存更轻量、性能更出色的优质代码。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















