


Python Playwright实现无头模式快速访问指定页面

在自动化测试、网页监控与数据采集中,使用无头模式(Headless Mode)可以在不弹出图形界面的前提下后台运行浏览器内核。借助 Python 版 Playwright,我们能够以极简的代码启动无头浏览器,并通过等待时机优化与静态资源拦截,让页面访问速度达到极致。
一、核心运行逻辑与分层架构
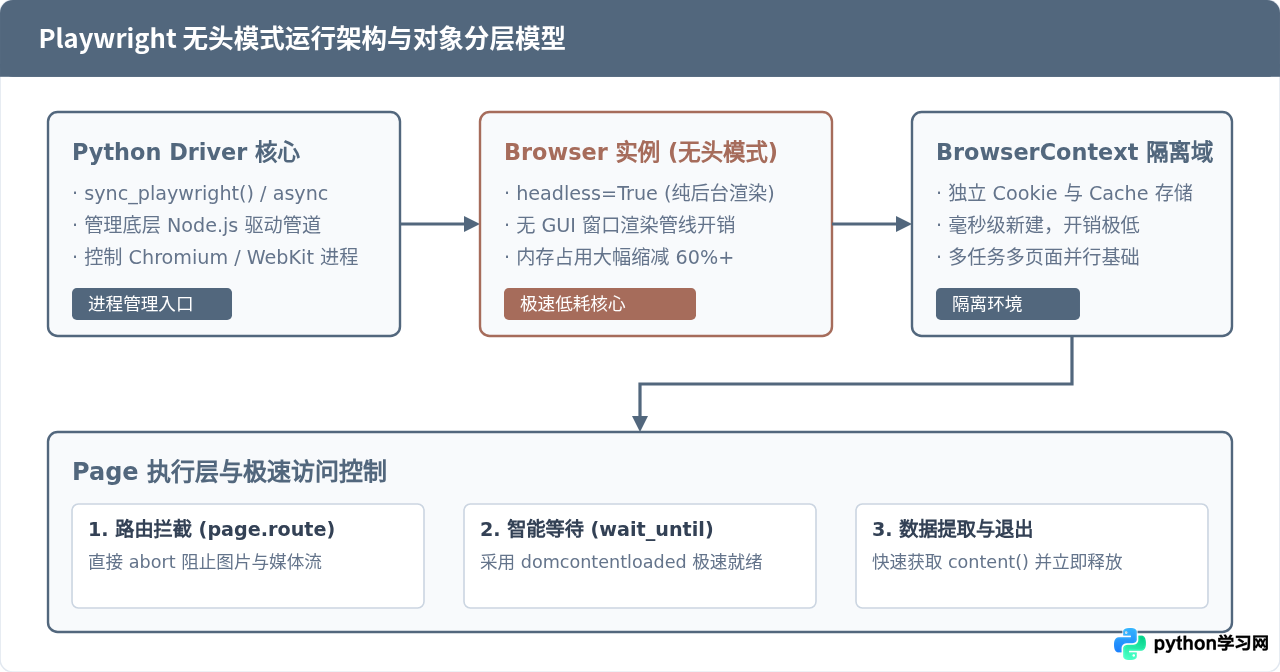
使用 Playwright 访问页面的核心链路可以划分为四个关键层次:Driver 驱动层、Browser 实例层、BrowserContext 上下文层以及具体的 Page 页面层。
在无头模式下,Playwright 启动底层 Chromium、WebKit 或 Firefox 时不会挂载任何窗口系统管线(Windowing Subsystem),这意味着操作系统省去了复杂的窗口渲染、图层合成以及 GPU 显存拷贝开销。此时的性能瓶颈主要集中在网络传输与页面 DOM 构建阶段。
二、环境准备与无头访问标准实现
在使用之前,请确保已经通过 pip 安装了 Playwright,并下载了轻量化的浏览器二进制包:
pip install playwright
playwright install chromium
在 Python 脚本中,Playwright 默认以 headless=True 启动浏览器内核。为了实现“快速访问”,我们应当在启动参数中加入优化标志,并利用上下文管理器确保运行完毕后安全关闭进程。
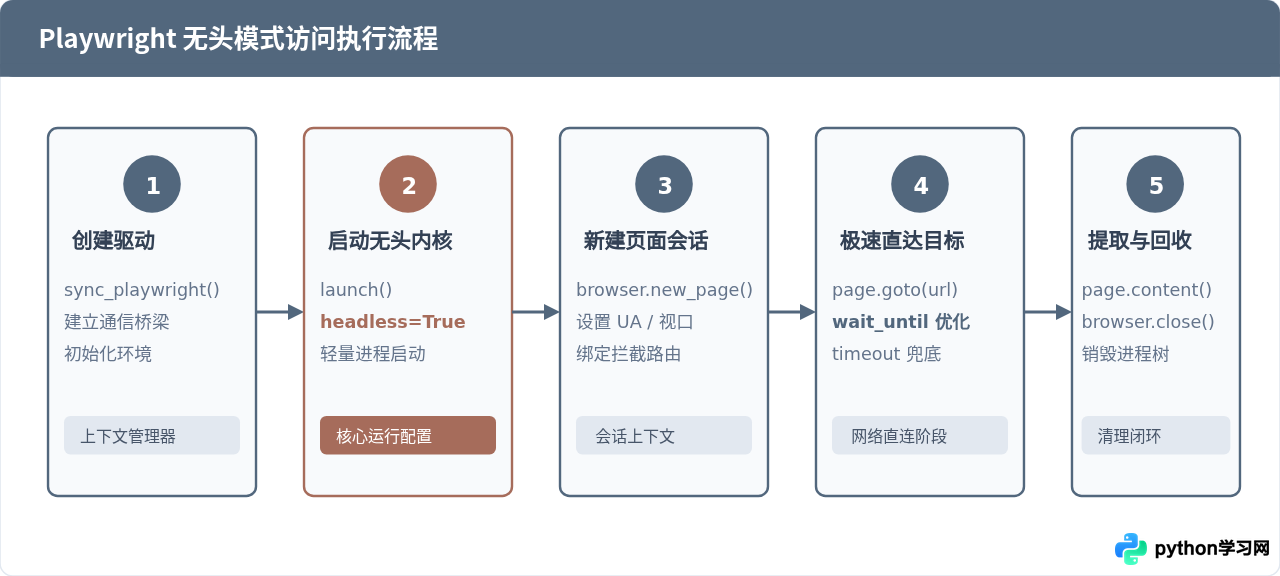
1. 同步方式(Sync API)标准示例
同步模式适合简单的脚本执行和线性作业流,代码直观且容易排查:
from playwright.sync_api import sync_playwright

def visit_page_fast(target_url: str):
    with sync_playwright() as p:
        # 显式声明 headless=True
        browser = p.chromium.launch(
            headless=True,
            args=["--no-sandbox", "--disable-gpu", "--disable-dev-shm-usage"]
        )
        context = browser.new_context()
        page = context.new_page()

        # 发起访问,设置 wait_until 为 domcontentloaded
        response = page.goto(target_url, wait_until="domcontentloaded", timeout=15000)

        print(f"目标页面 HTTP 状态码: {response.status if response else '未知'}")
        print(f"页面标题: {page.title()}")

        # 获取渲染后的 HTML 源码
        html = page.content()
        browser.close()
        return html

if __name__ == "__main__":
    visit_page_fast("https://example.com")
2. 异步方式(Async API)高并发示例
如果需要在后台快速批量轮询或并发抓取数十个页面,推荐使用基于 asyncio 的异步 API:
import asyncio
from playwright.async_api import async_playwright

async def async_visit_page(target_url: str):
    async with async_playwright() as p:
        browser = await p.chromium.launch(headless=True)
        context = await browser.new_context()
        page = await context.new_page()

        await page.goto(target_url, wait_until="domcontentloaded", timeout=15000)
        title = await page.title()
        print(f"异步访问完成: {title}")

        await browser.close()

if __name__ == "__main__":
    asyncio.run(async_visit_page("https://example.com"))
三、提速核心:等待策略调优与静态路由拦截
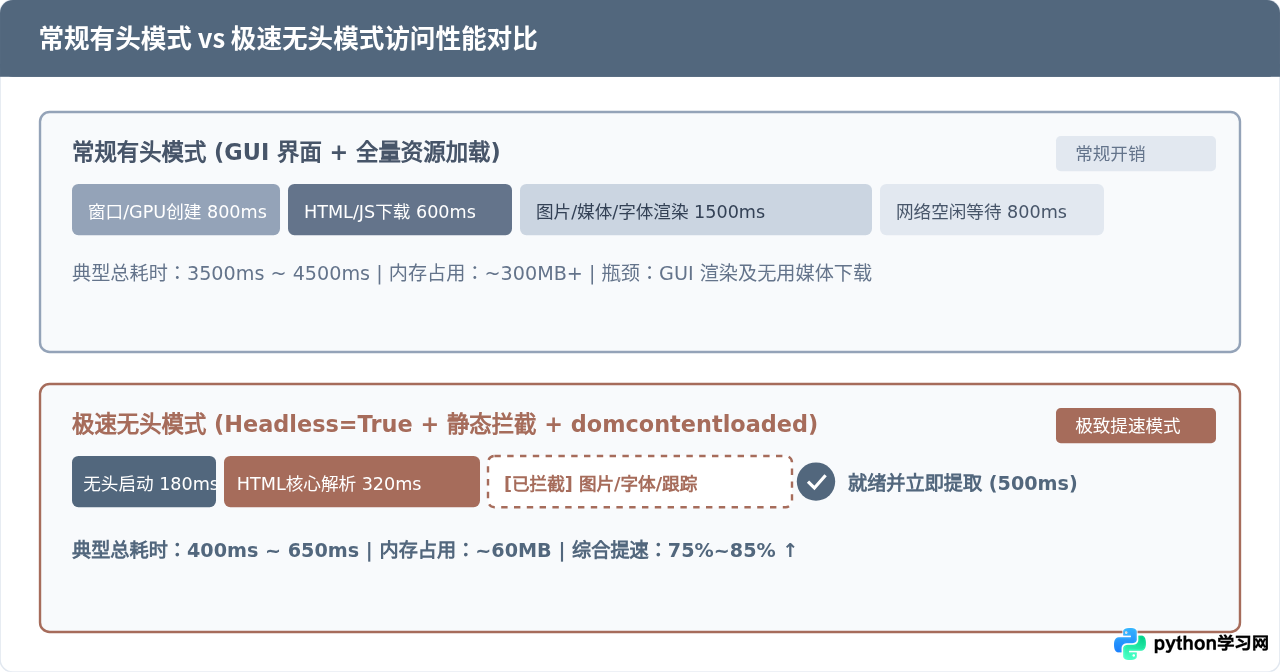
许多刚接触 Playwright 的开发者常常抱怨“无头模式依然很慢”,其根本原因在于默认的等待策略与全量静态资源下载。
在默认情况下,page.goto(url) 会一直等待直到浏览器的 load 事件触发。对于现代包含大量异步追踪探针、高清轮播图、字体包的复杂页面,load 事件往往需要数秒甚至十几秒。更有甚者,误将等待条件设为 networkidle,导致脚本因长轮询或心跳包陷入长时间挂起。
通过路由拦截(Route Abort)过滤非必要流量
在绝大多数网页采集和快速访问任务中,我们只需要页面的核心 HTML 和文本信息,图片(image)、媒体视频(media)、自定义字体(font)以及广告打点脚本对结果毫无帮助,反而占据了 80% 以上的带宽。可以通过 page.route 拦截并丢弃这些请求:
def intercept_unneeded_resources(route):
    # 根据资源类型进行阻断
    if route.request.resource_type in ["image", "media", "font"]:
        route.abort()
    else:
        route.continue_()

# 在 goto 之前绑定拦截规则
page.route("**/*", intercept_unneeded_resources)
page.goto("https://target-domain.com", wait_until="domcontentloaded")stylesheet 可能导致特定的元素定位器失效。因此建议常规情况下只过滤 image、media 与 font,保持样式与必要脚本正常执行。
四、关键细节与避坑指南
- 合理配置超时时间(Timeout):默认的全局超时时间为 30 秒。在快速访问场景下,若目标服务器由于不可控原因卡死,30 秒会导致整个工作流严重受阻。建议将
page.goto(url, timeout=10000)控制在 10 秒以内,并用try-except捕获PlaywrightTimeoutError。 - 补充拟真 User-Agent:Chromium 无头模式默认的请求头包含
HeadlessChrome标识,容易被部分 Web 应用防火墙(WAF)拦截或降频。在browser.new_context()时显式传入常规桌面版user_agent可大幅提升连通率。 - 严防僵尸进程:在服务化运行环境中,若异常未被妥善处理直接导致程序崩溃退出,Chromium 宿主子进程可能残留并持续吞噬主机内存。务必采用
with上下文管理器或在finally块中调用browser.close()。
五、总结与调优配置全景
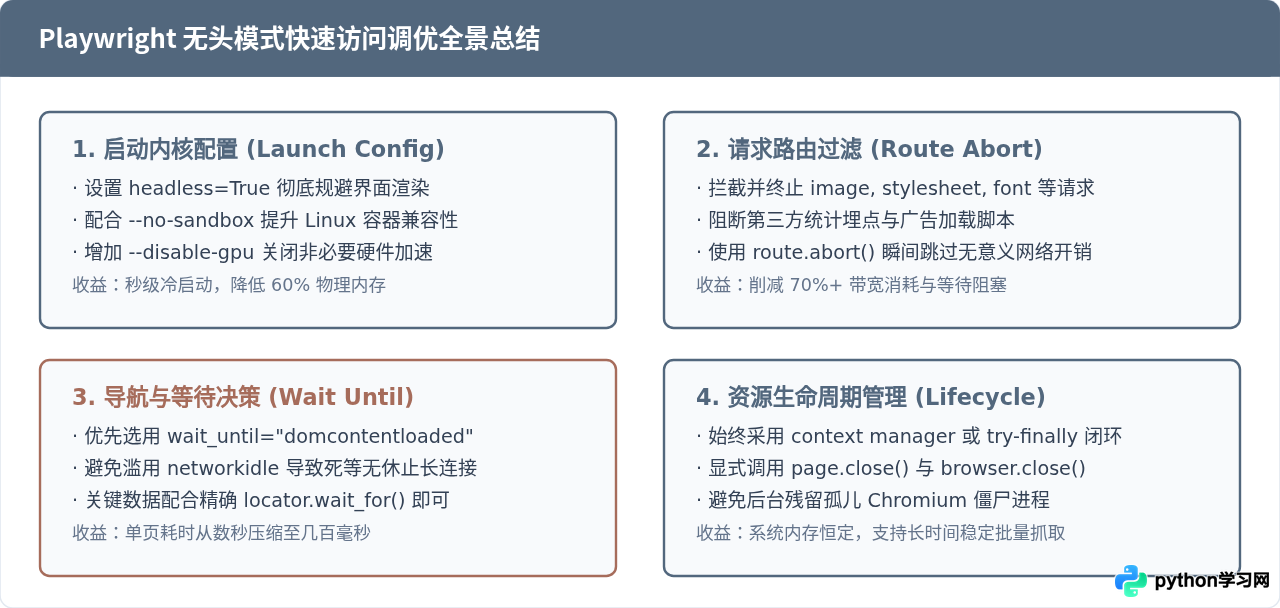
要实现 Python Playwright 无头模式下的极致访问速度,关键并不在于单一点的修改,而是将启动参数、环境上下文、路由网络层与生命周期管理串联成一个紧凑的闭环体系。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















