


Python 列表切片越界会报错吗?解析切片安全机制

在 Python 中,通过索引访问单个列表元素时若超出有效下标,解释器会立即抛出 IndexError: list index out of range。但在使用列表切片(如 a[2:100] 或 a[-50:2])时,即使切片范围完全超出了列表的最大长度或负向下标边界,Python 也绝对不会报错。相反,它会自动执行边界截断(Clamp)与区间规整,安全地返回所覆盖范围内的有效子列表或空列表 []。本文将具体剖析切片越界时的真实输出表现、底层 CPython 解释器的安全处理逻辑以及日常开发中的关键注意点。
一、直观对比:单元素索引与切片访问的行为差异
很多初学者容易将“索引定位”与“切片截取”混为一谈,但 Python 在语言规范上为二者制定了截然不同的安全策略:
- 单元素索引(Indexing):定位单个确定的存储单元。如果索引超出
[-len(lst), len(lst)-1]范围,属于明确的非法寻址,Python 选择“严格模式”,抛出IndexError阻止潜在的未知逻辑错误。 - 列表切片(Slicing):提取一段连续的子序列。切片关注的是“落在此区间内的元素集合”,超出物理边界的部分被自然视作无元素,因此采用“宽容安全模式”,自动将边界夹取(Clamp)至合法范围。
# 定义一个包含 5 个整数的列表
nums = [10, 20, 30, 40, 50]
# 列表长度为 5,最大有效正索引是 4

# 1. 单元素索引越界:直接报错
try:
    print(nums[10])
except IndexError as e:
    print(f"索引越界触发异常: {type(e).__name__} - {e}")
    # 输出: 索引越界触发异常: IndexError - list index out of range

# 2. 切片越界:安全运行,不报错
print("nums[2:100] ->", nums[2:100])    # 截取到末尾,输出: [30, 40, 50]
print("nums[-100:3] ->", nums[-100:3])  # 从开头开始,输出: [10, 20, 30]
print("nums[10:20]  ->", nums[10:20])   # 区间无元素,输出: []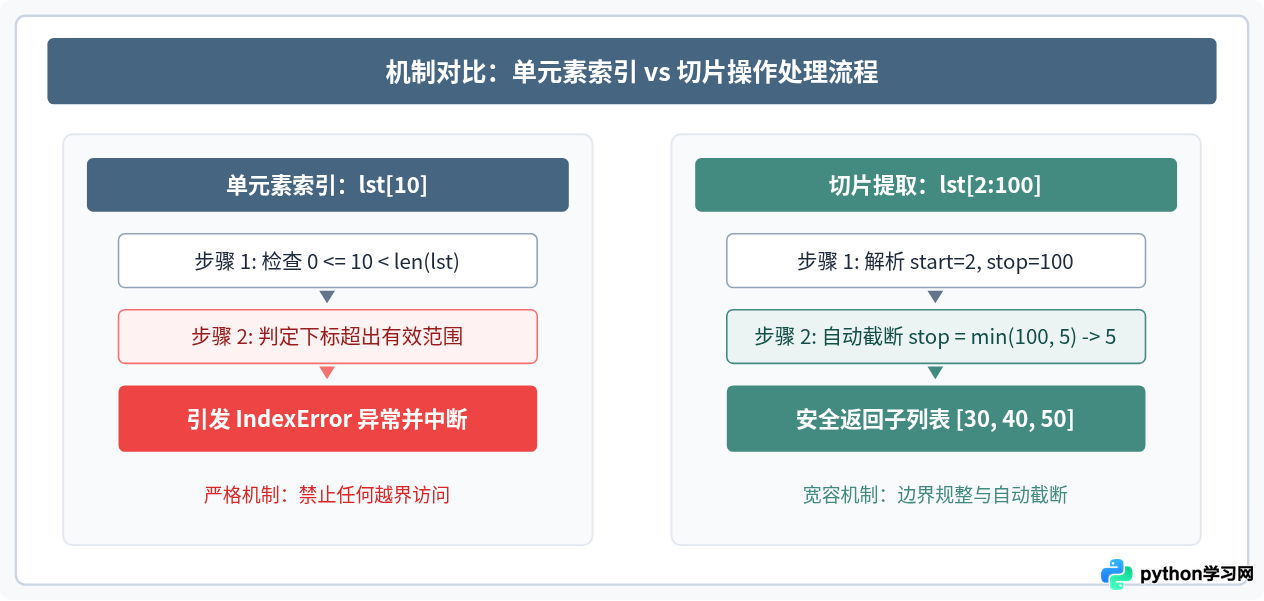
二、底层剖析:CPython 内部的切片规整算法(Clamping)
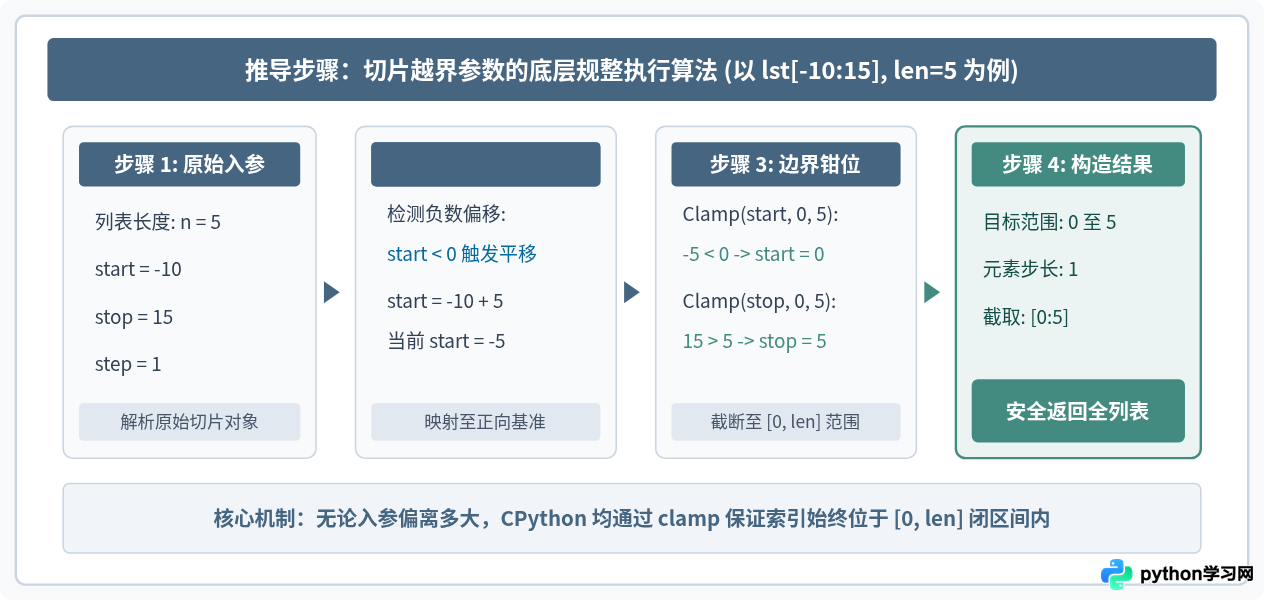
切片之所以不会引发异常,是因为 Python 解释器在执行切片时,内部通过标准化函数对参数进行了重整。以 CPython 源码(如 sliceobject.c 中的 PySlice_GetIndicesEx / PySlice_Unpack)为例,其主要执行过程遵循如下严谨的规整步骤:
- 缺省值填补:正向步长时,若
start缺省则默认为0;若stop缺省则默认为len。 - 负数索引平移:当传入负数时,首先加上列表长度:
start += len,stop += len。 - 区间夹取(Clamp):
- 若规整后的索引仍小于 0,则直接钳位到
0。 - 若规整后的索引大于
len,则直接钳位到len。
- 若规整后的索引仍小于 0,则直接钳位到
- 有效跨度计算:如果最终计算得到的
start >= stop(步长为正时),切片计算得到的有效长度为 0,直接返回空列表[]。
三、心智模型:数轴上的“间隙坐标”与窗口投影
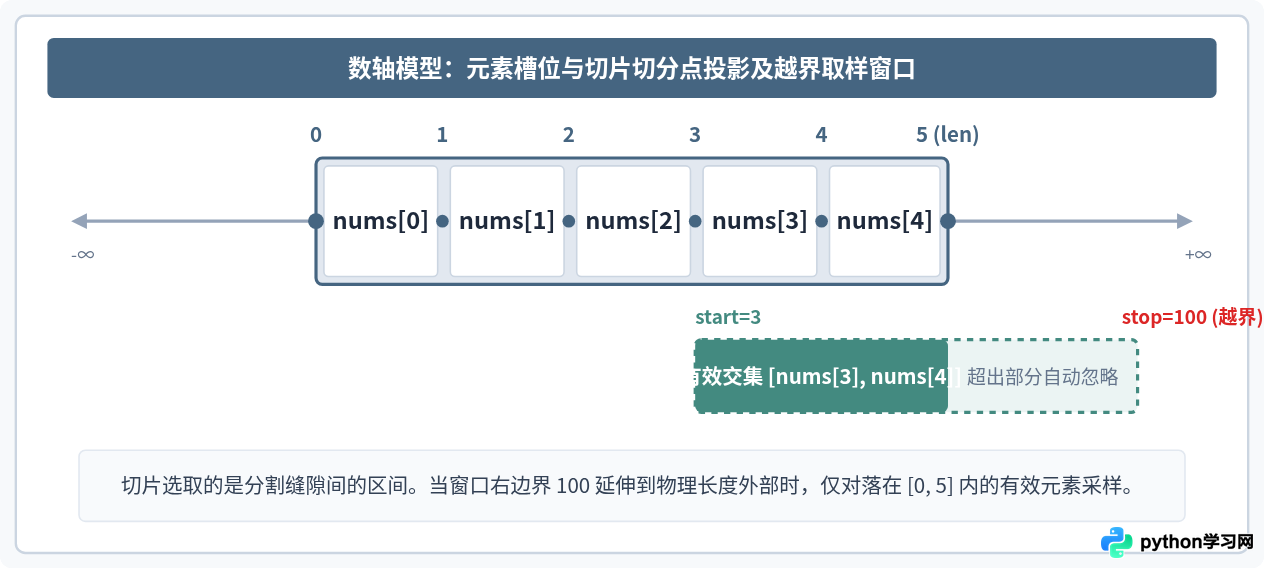
为了深刻理解切片的安全性,最清晰的抽象模型是“栅栏缝隙坐标系”。切片的起始与终止点并不是指向具体的格子(元素),而是指向元素之间的分割缝隙(Boundaries)。
在一个长度为 5 的列表中,元素分别为 e0, e1, e2, e3, e4,分割点从 0 到 5 共有 6 条缝隙。切片表达式 [start:stop] 实际上是在数轴上放置了一个取样窗口:
- 如果取样窗口完全落在
[0, 5]内部,就提取窗口覆盖的元素。 - 如果取样窗口超出了
0的左侧(负无穷方向)或5的右侧(正无穷方向),超出部分对应数轴上的“空白区域”,并不会引起物理内存越界。 - Python 将这个取样窗口与列表的实际有效范围
[0, len]求交集。交集范围内有元素则取出,交集为空则返回空列表[]。
四、典型越界场景解析与代码实践
在实际编码中,切片越界通常表现为以下几种常见形态,理解它们各自的输出结果有助于消除不确定的心理负担:
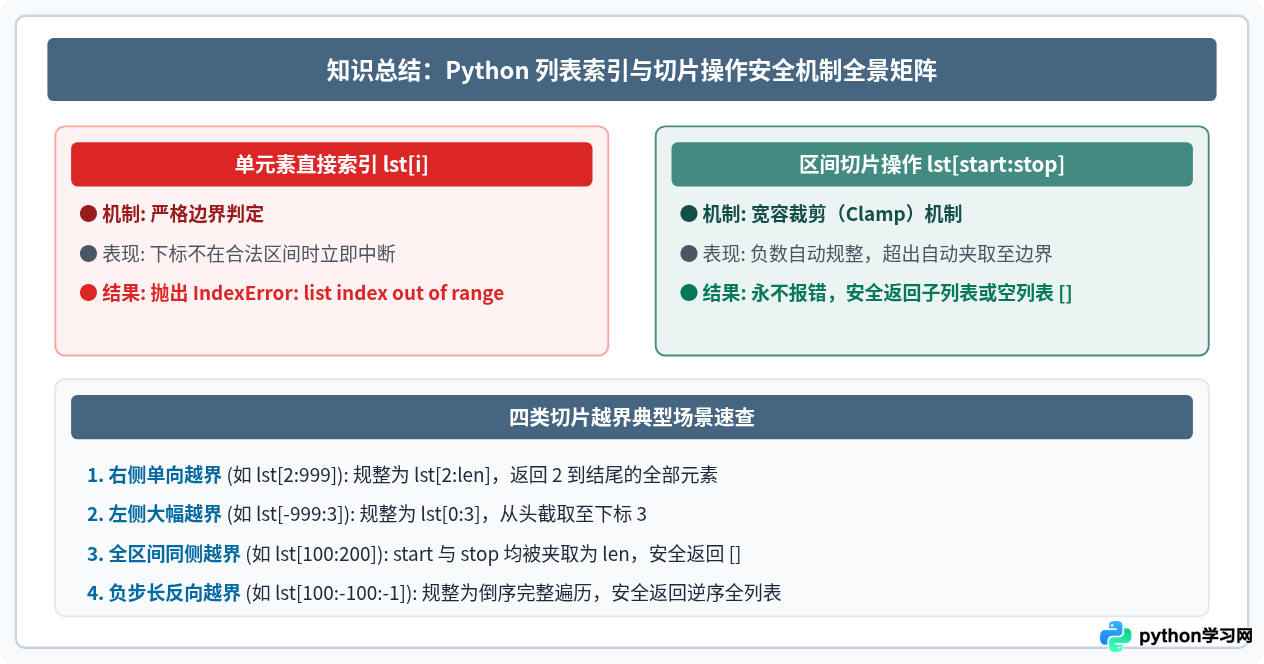
1. 右侧正向下标越界(stop > len)
这是最普遍的场景。例如只想取“从第 2 个元素开始的后续所有元素”,哪怕传了一个非常庞大的数字 1000,解释器也会精准截取到列表末尾为止。
items = ["A", "B", "C"]
print(items[1:999])  # 输出: ['B', 'C'],等效于 items[1:]
2. 左侧负向下标大越界(start < -len)
当负数绝对值远大于列表长度时,例如长度为 3 的列表使用 -100。经过负数平移和 0 钳位后,起始位置会自动锚定在列表的开头位置 0。
items = ["A", "B", "C"]
print(items[-100:2])  # 输出: ['A', 'B'],等效于 items[0:2]
3. 起止边界均在同一侧完全越界(start >= len and stop >= len)
如果切片的起止区间完全落在了有效列表的外部,由于钳位后满足 start == stop == len,两者之间不包含任何元素,因此会稳定返回一个空列表,而绝不会崩溃。
items = ["A", "B", "C"]
print(items[10:20])   # 输出: []
print(items[-20:-10]) # 输出: []
4. 负步长(反向切片)的越界处理
在带负步长(如 step = -1)的反向切片中,规则依然对称成立:超出正向边界的起始点会被夹取为 len - 1,而越过左侧的终止点会被夹取为 -1(即遍历至头部)。
items = [1, 2, 3, 4, 5]
# 从极大索引反向遍历至极小索引
print(items[100:-100:-1]) # 输出: [5, 4, 3, 2, 1]切片不仅用于读取,还可用于赋值修改列表。当执行切片赋值时(如 lst[100:200] = [99]),越界的切片区间被当作位于列表末尾的空切片插入点,数据会被直接追加(extend)在列表尾部,同样不会抛出越界异常。
五、工程思考:切片安全机制的利与弊
| 机制维度 | 优势特性(Benefit) | 潜在隐患(Risk) | 推荐工程实践 |
|---|---|---|---|
| 容错性 | 消除多余的 min(len(lst), end) 防御性代码,代码简洁明了。 |
切片过大掩盖了意料之外的脏数据或计算溢出。 | 在必须校验固定批量长度的业务逻辑中,显式校验 len(lst)。 |
| 滑动窗口 | 在分批处理、分页、截取预览时,天然支持末尾截尾,无需特殊处理最后一页。 | 拼写错误或变量传错时返回空列表 [],程序静默运行但结果非预期。 |
编写单元测试,针对空集和极值进行断言覆盖。 |
| 数据独立性 | 切片始终返回一个全新的列表浅拷贝,切片操作不会破坏原列表。 | 大列表切片会产生额外内存开销。 | 仅需要迭代遍历时,优先考虑 itertools.islice。 |
六、总结
回到最初的核心问题:Python 列表切片越界会报错吗?答案是确定无疑的:不会。
这种设计契合了切片作为“子序列提取与窗口采样”的功能定位:
- 定位不同:索引定位的是单个存储槽,越界属于严重非法引用;切片表达的是连续采样区间,越界属于无重叠采样,返回空集具有数学与工程上的合理性。
- 内部规整:底层 CPython 解释器通过自动平移负数、边界夹取(Clamp 到
[0, len])确保了切片执行的安全无崩。 - 开发平衡:在享受无需编写繁琐防御性边界截断代码的同时,也要警惕切片“静默返回空列表”的特征,在对输入序列长度有严苛契约要求的业务流程中,辅以必要的
len()校验。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















