


Python怎么获取列表(数组)的长度

在 Python 中获取列表(初学者常习惯称之为数组)的长度,最直接且标准的方法是使用内置函数 len()。你只需将列表作为参数传递给 len(你的列表),它就会立即返回该列表中所包含的元素个数。本文将由浅入深讲解 len() 的具体用法、底层运行机制、嵌套与多维列表的处理技巧,以及日常编写代码中最容易混淆的常见误区。
一、核心用法:使用内置函数 len()
Python 提供了全局内置的 len() 函数(英文 length 的缩写),专门用于返回序列或集合类对象的长度。无论是字符串、元组、字典还是列表,都可以通过统一的语法获取其容量大小。
下面是一个最基础的使用示例。我们创建一个包含若干字符串的列表,并打印出该列表的长度:
# 示例 1:获取一维列表的长度
fruits = ["苹果", "香蕉", "橙子", "草莓"]
length = len(fruits)

print("列表中的元素个数为:", length)
从执行结果可以看到,len() 函数返回了一个整数 4,表示列表中正好有 4 个元素。获取长度的整个流程非常直观,其核心操作包含定义列表、传递参数、接收返回结果三个阶段。
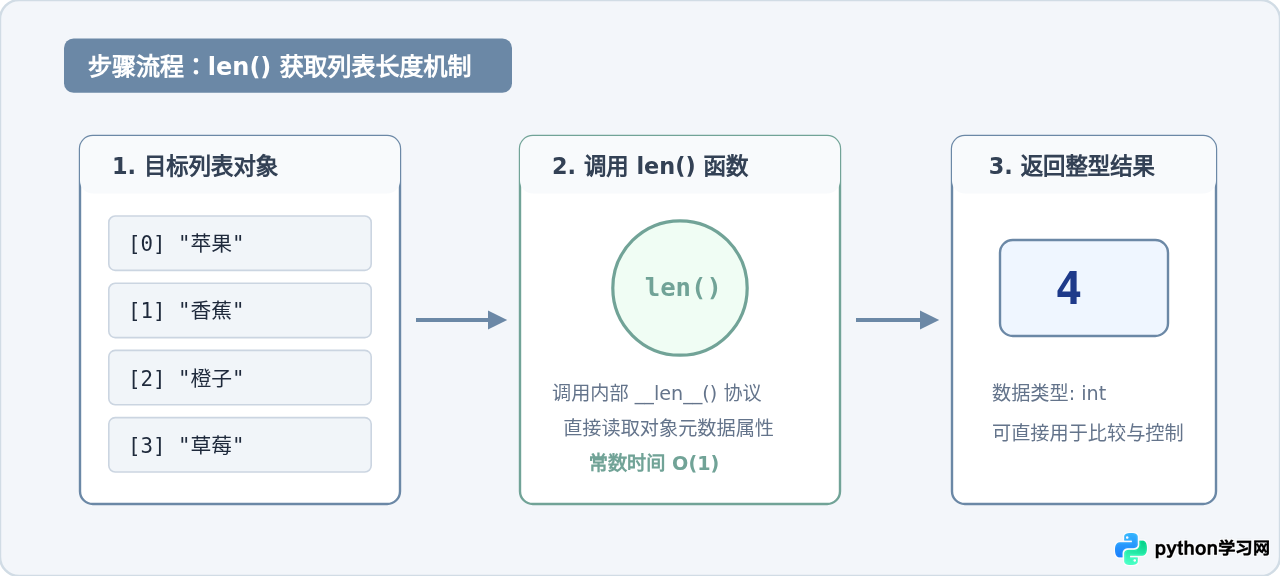
二、深入底层:为什么 len() 的执行速度极其迅速?
很多初学者会产生一个疑问:当列表中存有上千万个元素时,len() 会不会从头到尾挨个数一遍,从而耗费大量时间?
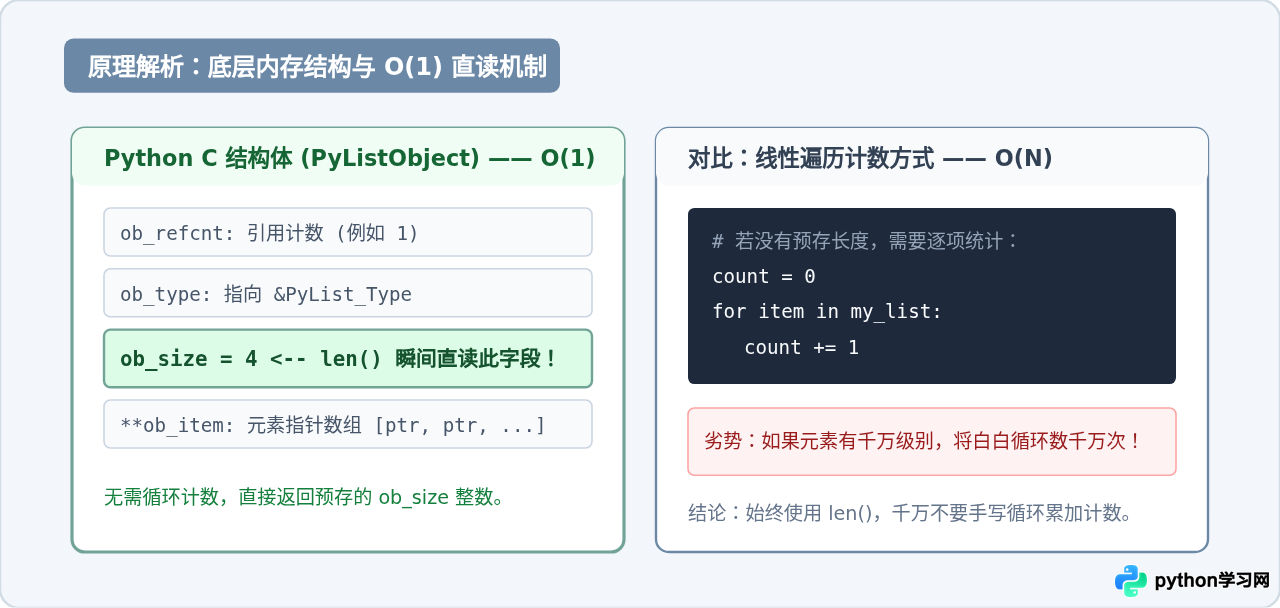
答案是:完全不会。在 Python(特别是官方的 CPython 实现)中,列表对象的底层结构是一个被称为 PyListObject 的 C 语言结构体。在这个结构体中,除了保存元素的指针数组外,还专门维护了一个名为 ob_size 的整数字段。
每当你向列表中 append() 新元素或通过 pop() 删除元素时,Python 解释器在内存中就已经自动同步更新了 ob_size 的数值。因此,当你调用 len(my_list) 时,解释器所做的工作仅仅是从内存中直接读取这个预存的数字,而不需要做任何循环遍历。
- 时间复杂度为 O(1):无论列表有 0 个、10 个还是 10,000,000 个元素,获取长度耗费的时间几乎完全一致,耗时均在几十纳秒级别。
- 空间开销几乎为零:只是读取已有属性,不申请额外堆栈空间。
三、常见实战场景与技巧
1. 空列表的长度与判空最佳实践
当列表中不包含任何元素时,len() 会返回 0:
empty_list = []
print("空列表的长度:", len(empty_list))
if len(my_list) == 0: 可以判断列表是否为空,但根据 PEP 8 官方编码规范,推荐直接利用列表在布尔上下文中的“真值判断”(空列表会自动被视作 False):
if not my_list: (推荐,更优雅高效)if len(my_list) == 0: (虽然正确,但稍显啰嗦)
2. 防止下标越界:长度与最大索引的关系
Python 中的列表索引是从 0 开始计数的。这意味着:
- 如果一个列表的长度为
N(即len(my_list) == N); - 它的有效正向下标范围是
0到N - 1; - 如果直接访问
my_list[len(my_list)],一定会抛出IndexError: list index out of range异常。
colors = ["红", "绿", "蓝"]
n = len(colors) # n 为 3

# 最后一个元素的合法索引是 n - 1,或者使用 Python 特有的负索引 -1
last_item = colors[n - 1]
print("最后一个元素:", last_item)
print("使用负索引同样可得:", colors[-1])
3. 二维列表与多维矩阵的长度获取
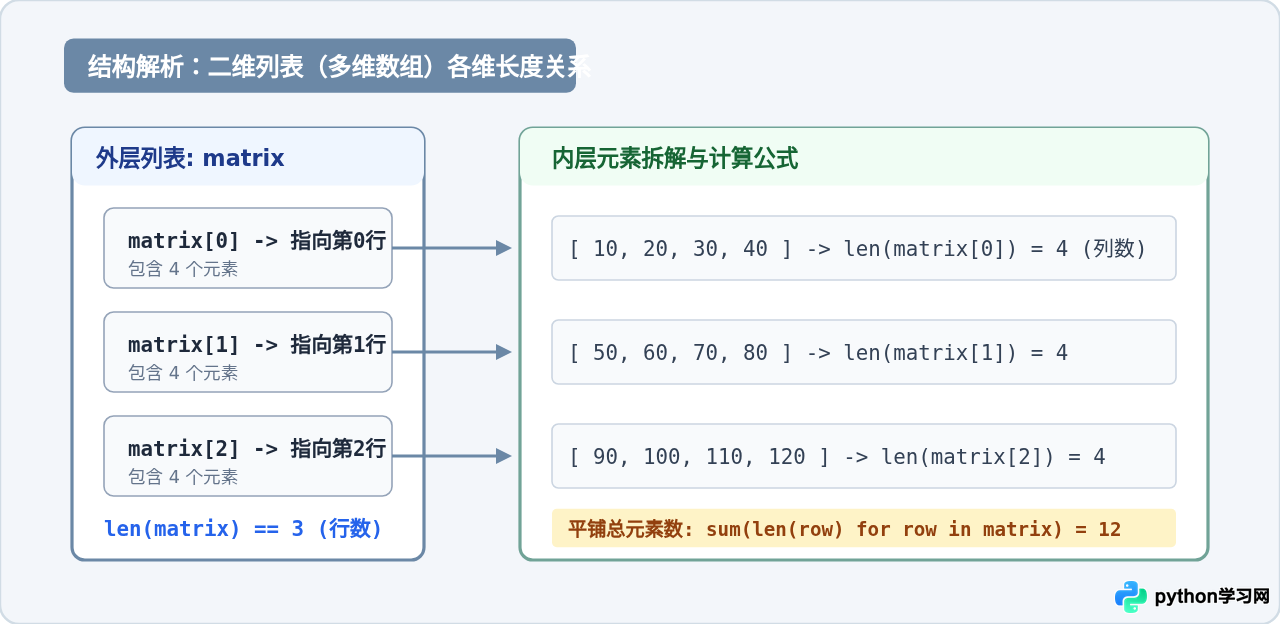
在处理矩阵、表格或图像数据时,我们常常会用到嵌套列表(即列表里面的元素仍然是列表)。这时对整个嵌套列表调用 len(),返回的只是最外层包含的行数(或子列表个数),而不会自动把所有内层元素相加。
# 示例:一个 3 行 4 列的二维列表
matrix = [
    [10, 20, 30, 40],
    [50, 60, 70, 80],
    [90, 100, 110, 120]
]

# 获取外层行数
row_count = len(matrix)

# 获取某一行的列数(以第0行为例)
col_count = len(matrix[0])

# 计算所有内层元素的总个数
total_elements = sum(len(row) for row in matrix)

print("行数 (外层长度):", row_count)
print("列数 (第0行长度):", col_count)
print("矩阵所有元素总数:", total_elements)
行数 (外层长度): 3
列数 (第0行长度): 4
矩阵所有元素总数: 12
四、初学者容易混淆的四个典型误区
误区 1:使用其他语言的属性语法(如 .length 或 .size)
很多有 JavaScript、Java 或 C++ 基础的开发者初学 Python 时,常常习惯性地输入 my_list.length、my_list.length() 或 my_list.size()。在 Python 的内置 list 类型中,这些属性和方法都是不存在的,强行调用会直接触发 AttributeError:
items = [1, 2, 3]

# 错误示范(将引发 AttributeError: 'list' object has no attribute 'length'):
# print(items.length)
# print(items.size())

# 正确写法:
print(len(items)) # 输出 3
误区 2:在遍历列表时过度依赖 range(len(list))
在 C 或 Java 中,常规遍历数组往往需要获取长度并递增下标。但在 Python 中,列表是原生可迭代对象,直接对列表遍历不仅更符合 Pythonic 风格,而且运行速度更快:
names = ["张三", "李四", "王五"]

# 不推荐(虽然能跑,但不够优雅):
for i in range(len(names)):
    print(names[i])

# 推荐写法 1:直接遍历元素本身
for name in names:
    print(name)

# 推荐写法 2:若同时需要下标和元素,使用 enumerate()
for i, name in enumerate(names):
    print(f"索引 {i}: {name}")
误区 3:在循环迭代中修改列表导致逻辑错误
如果在遍历列表的同时增删元素,列表的 len() 会动态变化,这极容易引发遍历跳过项或下标越界的逻辑 bug。若确实需要边遍历边根据条件过滤元素,推荐使用列表推导式或先遍历原列表的切片浅拷贝 my_list[:]。
五、横向对比:列表与真正“数组”(array/NumPy) 的长度获取
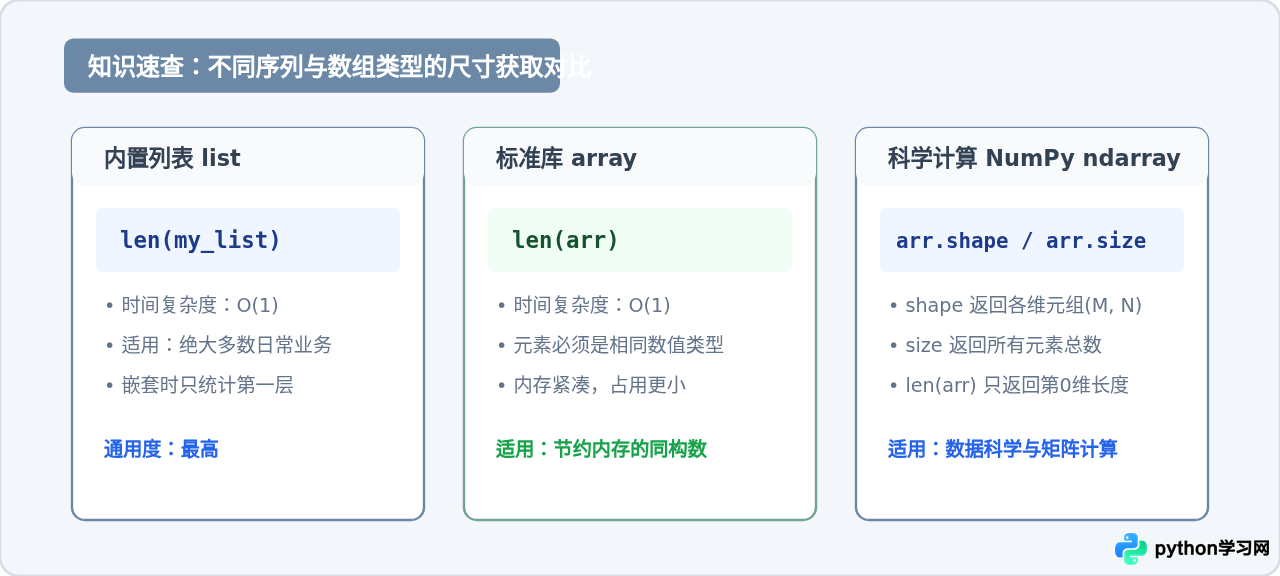
日常讨论中,许多人习惯把 Python 的 list 统称为“数组”,但实际上 Python 标准库中还提供了 array.array,而在科学计算和数据分析领域,最常用的则是第三方库 NumPy 的 ndarray。不同结构在长度和维度的处理上略有不同:
| 数据结构类型 | 所属模块 | 主要获取方式 | 特点与适用场景 |
|---|---|---|---|
内置列表 (list) |
Python 内置 | len(my_list) |
异构序列,支持任意类型对象,最通用 |
标准库数组 (array.array) |
标准库 array |
len(arr) |
同构连续内存,仅支持存储基本数值类型 |
多维矩阵 (numpy.ndarray) |
NumPy 第三方库 |
arr.shape (各维度大小)arr.size (总元素数量)len(arr) (第一维长度)
|
高性能科学计算、向量化操作与深度学习数据处理 |
六、全文总结
掌握 Python 列表长度的获取方法十分简单,牢记以下三条核心结论即可:
- 唯一标准方式:始终使用
len(my_list)获取长度,不要尝试调用.length或.size()。 - 性能极度优异:由于底层直接维护
ob_size字段,len()执行时间复杂度为O(1),无需担心长列表的性能损耗。 - 多维结构分清层级:二维列表中
len(matrix)代表外层行数,若需统计总元素数可使用sum(len(row) for row in matrix);对于大型科学计算矩阵,推荐优先使用 NumPy 的shape和size属性。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















