


Python常用内置函数详解:len、range、enumerate等高频用法
深入详解Python核心高频内置函数len、range与enumerate的工作原理、底层机制、代码示例与进阶组合用法,帮助开发者写出更优雅高效的Pythonic代码。
Python 在启动解释器时会自动加载 builtins 模块,为开发者提供数十个开箱即用的内置函数。在日常编程与数据处理过程中,序列度量、数值迭代与元素遍历是最基础的操作,而 len()、range() 与 enumerate() 正是承载这三类任务最高频的工具。掌握它们的底层工作机制与正确搭配方式,能够帮助开发者写出更紧凑、执行效率更高且内存友好的 Pythonic 代码。本文将逐一拆解这些核心内置函数的原理、参数特性、常见陷阱及协同模式。
一、len() 详解:从常数复杂度到自定义序列支持
len(s) 用于返回对象 s 中的元素数量。参数 s 可以是序列(如 str、list、tuple、bytes)或集合映射(如 dict、set、frozenset)。
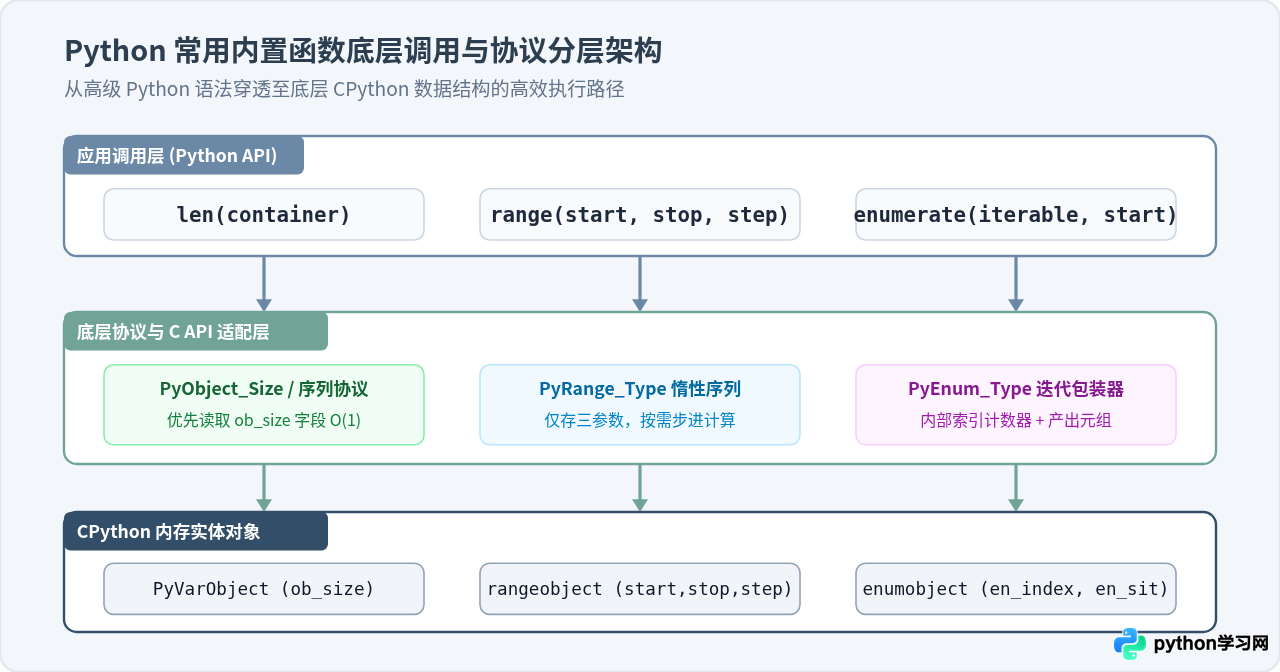
1. 为什么内置容器的 len() 时间复杂度为 O(1)?
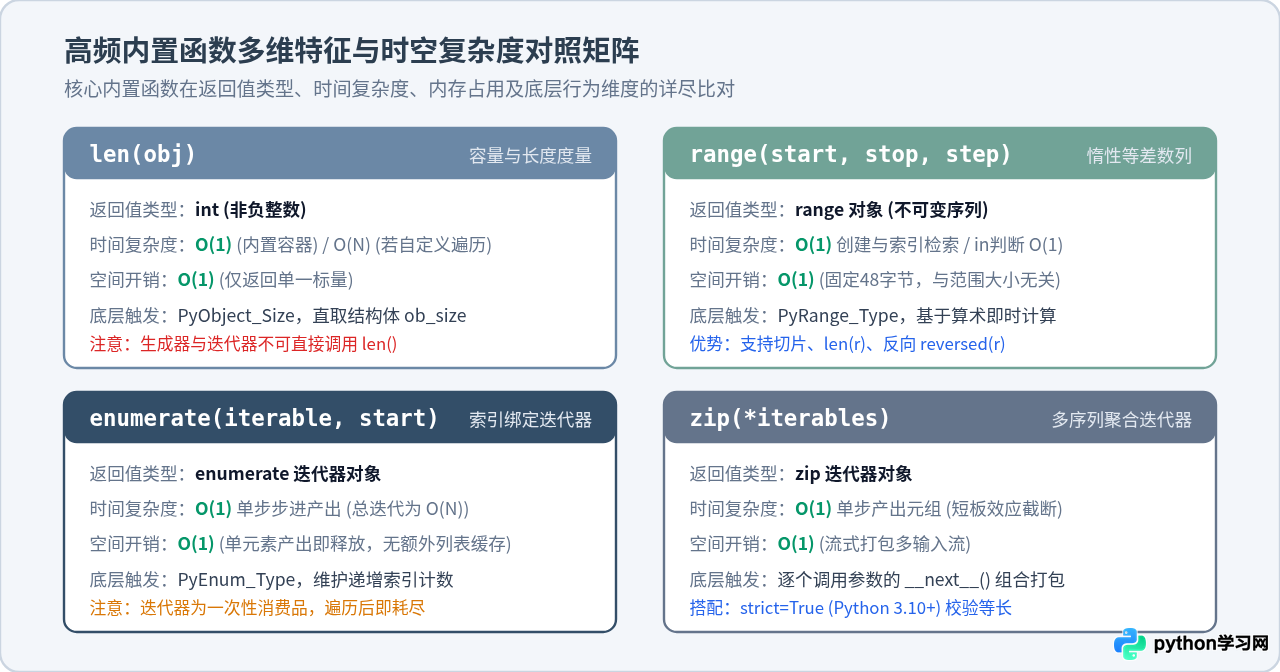
很多初学者误以为 len() 会像 C 语言中的 strlen() 那样遍历容器所有元素来计算总数。实际上,在 CPython 解释器中,列表、元组、字符串和字典等内置对象都派生自包含变长头部的 PyVarObject 结构体。该结构体在内存中直接维护了一个名为 ob_size 的字段。当通过 append()、pop() 等方法改变列表时,CPython 会在修改内容的同时同步更新该计数值。因此,调用 len(list) 只是简单地读取已存在的内存字段,时间复杂度恒定为 O(1),即使列表包含数千万个元素也能瞬间返回。
# len() 基础用法与类型支持
sample_list = ["Python", "Rust", "Go"]
sample_dict = {"name": "Alice", "role": "Dev"}
sample_str = "Antigravity"

print("List 长度:", len(sample_list))
print("Dict 键数量:", len(sample_dict))
print("String 字符数:", len(sample_str))
Dict 键数量: 2
String 字符数: 11
2. 自定义类的 __len__ 协议支持
当开发者自己编写类时,只要在类定义中实现 __len__() 魔术方法,该类的实例就可以直接配合 len() 函数使用。需要注意,根据 Python 数据模型规范,__len__() 必须返回一个大于或等于 0 的整数,否则会抛出 TypeError 或 ValueError。
class TaskQueue:
    def __init__(self):
        self._tasks = []

    def add(self, task_name):
        self._tasks.append(task_name)

    def __len__(self):
        return len(self._tasks)

queue = TaskQueue()
queue.add("数据清洗")
queue.add("特征提取")
print("当前待处理任务数:", len(queue))
二、range() 详解:内存友好的惰性不可变序列
在 Python 2 中,range() 会在内存中直接生成一个完整的列表;而在 Python 3 中,range 被重构为一种不可变序列类型(Immutable Sequence Type)。无论范围是 10 还是 10,000,000,它在内存中所占的空间都是恒定的。
1. 参数形式与步长控制
range() 支持三种重载传参形式:
range(stop):从 0 开始,每次递增 1,生成至stop - 1。range(start, stop):从start开始,每次递增 1,生成至stop - 1。range(start, stop, step):从start开始,按指定step递增或递减,生成至未达到stop的边界。
# 正向步长与逆向步长
forward_seq = list(range(1, 10, 2))
backward_seq = list(range(10, 0, -2))

print("正向奇数序列:", forward_seq)
print("逆向偶数序列:", backward_seq)
逆向偶数序列: [10, 8, 6, 4, 2]
2. 为什么 range 不会撑爆内存?
range 对象只存储 start、stop 和 step 三个整数。当遍历 range 时,迭代器依靠算术逻辑在需要时即时算出当前数值。我们可以使用 sys.getsizeof() 观察其内存消耗:
import sys

r_small = range(10)
r_huge = range(100_000_000)

print("range(10) 占用字节:", sys.getsizeof(r_small))
print("range(1亿) 占用字节:", sys.getsizeof(r_huge))
range(1亿) 占用字节: 48
此外,range 还支持索引访问(如 r[5])与成员检查(如 x in r)。在 Python 中检查一个数是否属于某个 range 时,解释器并非遍历比较,而是通过算术余数直接判定,其时间复杂度同样为 O(1)。
三、enumerate() 详解:告别手动计数的原生迭代器
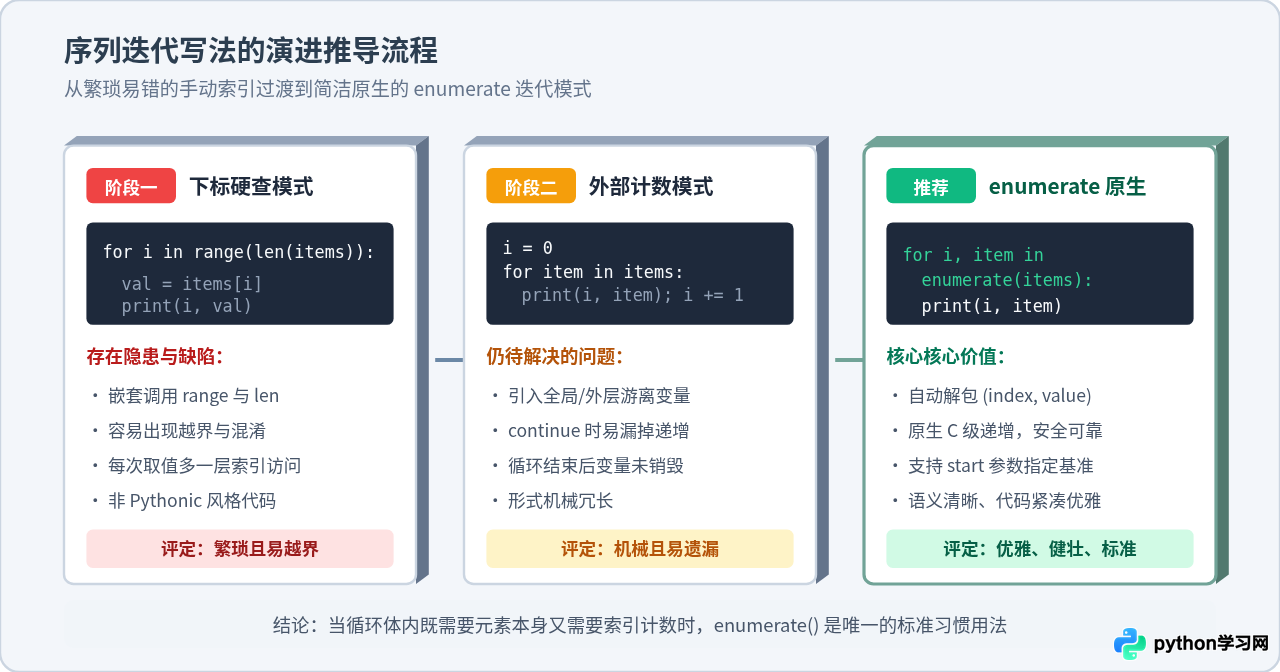
在遍历可迭代对象时,如果既需要访问元素本身,又需要获知当前元素的位置下标,初学者容易写出 for i in range(len(items)) 这样带有 C 语言色彩的结构。enumerate(iterable, start=0) 的出现彻底消除了这种反模式。
1. 基本语法与解包语法
enumerate() 接受一个可迭代对象,并返回一个枚举迭代器。每次迭代时,它产出一个包含两个元素的元组 (index, item)。利用 Python 的序列解包特性,开发者可以在 for 语句头部直接将它们解构为两个变量:
fruits = ["苹果", "香蕉", "橙子"]

# 直接解包获取索引与值
for index, fruit in enumerate(fruits):
    print(f"索引 {index} 对应水果: {fruit}")
索引 1 对应水果: 香蕉
索引 2 对应水果: 橙子
2. 利用 start 参数自定义起始序号
在面对业务报表、终端日志、行号展示等面向非程序员读者的场景时,序号往往需要从 1 开始而非 0。enumerate 提供了可选的 start 参数,避免了在循环体内繁琐地书写 index + 1:
students = ["张伟", "李强", "王芳"]

# 从 1 开始编号输出榜单
for rank, name in enumerate(students, start=1):
    print(f"第 {rank} 名: {name}")
第 2 名: 李强
第 3 名: 王芳
四、进阶组合技:构建高表现力代码的实用模式
在实际开发场景中,单个内置函数往往不足以应对复杂的业务逻辑,将 len、range、enumerate 与其它高频函数协同使用,能够大幅提高代码表达力。
1. enumerate 与 zip 协同处理多列数据
当需要同步遍历多个相关列表,并且同时获知当前条目编号时,可将 zip() 打包的结果交由 enumerate() 解构:
names = ["张三", "李四", "王五"]
scores = [88, 95, 72]

# 同时获取行号与多列对应数据
for line_no, (name, score) in enumerate(zip(names, scores), start=1):
    status = "合格" if score >= 80 else "待重考"
    print(f"[{line_no:02d}] 考生: {name} | 得分: {score} | 状态: {status}")
[02] 考生: 李四 | 得分: 95 | 状态: 合格
[03] 考生: 王五 | 得分: 72 | 状态: 待重考
2. range 与步长分块切片
在批量处理 API 请求或数据库记录时,常需要将长度为 N 的大列表切分为固定大小的 Batch。利用 range(0, len(items), batch_size) 可以极为简洁地完成批次划分:
def chunk_list(data, chunk_size):
    """利用 range 步长实现优雅的列表分块"""
    for i in range(0, len(data), chunk_size):
        yield data[i:i + chunk_size]

records = list(range(1, 11))
for batch_idx, batch in enumerate(chunk_list(records, chunk_size=3), start=1):
    print(f"批次 {batch_idx}: {batch}")
批次 2: [4, 5, 6]
批次 3: [7, 8, 9]
批次 4: [10]
3. reversed() 与 range/enumerate 的逆序搭配
当需要从后向前处理数据且需要原有下标时,直接使用 reversed() 能够保持 O(1) 空间消耗,而无需使用 items[::-1] 生成新的反转切片:
items = ["A", "B", "C", "D"]

# 安全高效地反向倒序遍历 range
for i in reversed(range(len(items))):
    print(f"倒序处理下标 {i}: {items[i]}")
倒序处理下标 2: C
倒序处理下标 1: B
倒序处理下标 0: A
五、常见易错陷阱与异常排查
1. 对生成器调用 len() 导致 TypeError
生成器(Generator)与大部分自定义迭代器是单向流式产出的,在未消耗完毕前根本无法预知总项数,因此没有实现 __len__ 协议。直接传入 len() 会抛出错误:
gen = (x * 2 for x in range(5))
try:
    print(len(gen))
except TypeError as e:
    print("捕获预期异常:", e)
解决途径:如果必须获取生成器的数量,且数据量允许一次性载入内存,应先显式转换为 list(gen) 后再调用 len();若数据量过大,应使用 sum(1 for _ in gen) 在流式迭代中计数。
2. 变量命名污染覆盖内置函数
初学者容易将局部变量命名为 list、len、range 等,导致 Python 优先匹配局部命名空间中的变量,进而掩盖内置函数(Shadowing Built-ins):
# 错误反例演示
len = [10, 20, 30]  # 覆盖了内置的 len 函数
try:
    print(len("test"))
except TypeError as e:
    print("错误原因:", e)
del len  # 恢复全局/内置作用域
防范方法:避免使用任何内置函数名作为变量名;在 IDE 中开启 Linter 静态分析(如 Flake8、Pylint),遇到命名遮蔽时主动重命名为 length、item_list 等具名变量。
3. enumerate 对象的一过性(消耗性)
enumerate() 返回的是迭代器(Iterator),而不是持久列表。一旦被遍历完毕,指针已停留在末尾,再次对其遍历将得不到任何元素:
enum_obj = enumerate(["Alpha", "Beta"])
print("第一次迭代:", list(enum_obj))
print("第二次迭代:", list(enum_obj))  # 此时迭代器已被耗尽
第二次迭代: []
六、总结与速查清单
掌握内置函数的精髓在于顺应 Python 的迭代器协议与底层优化机制:
- 使用
len()读取容器尺寸,其时间复杂度为 O(1),但切勿传给它未实现__len__的生成器; - 使用
range()生成等差数值序列,它是固态占用的惰性不可变序列,适于循环计数与分块步长,无需担心内存耗尽; - 遍历序列且需要下标时,始终优先采用
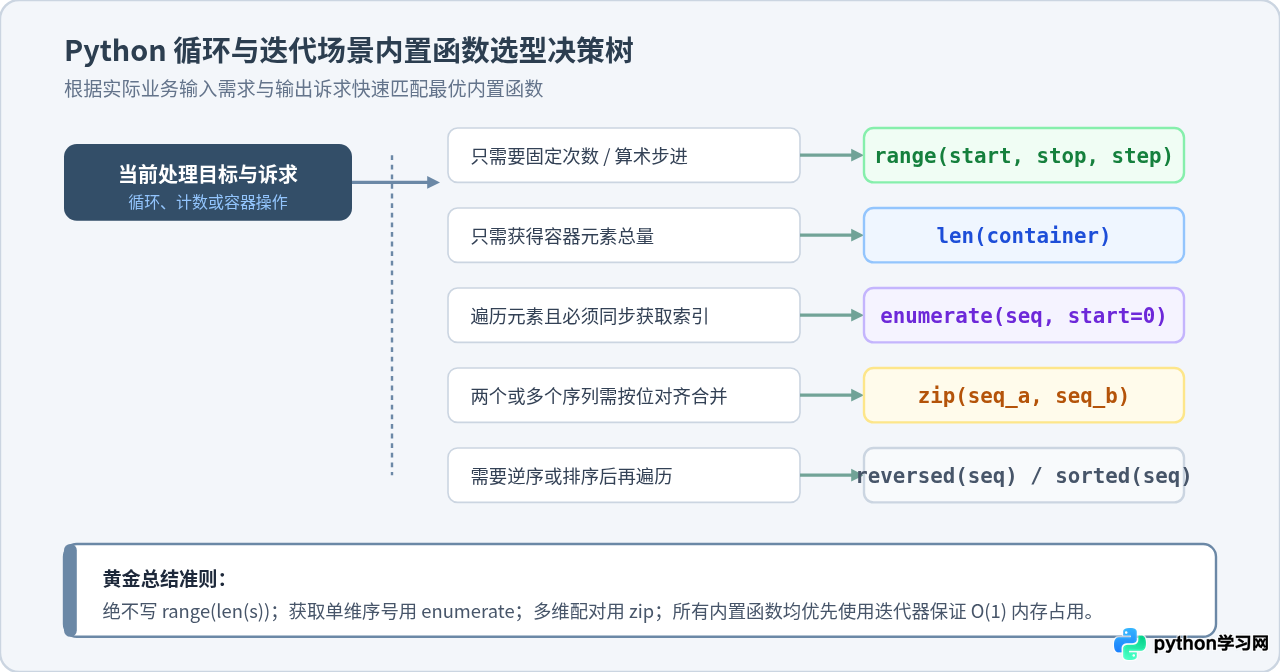
enumerate(seq, start=...),彻底淘汰range(len(seq))与外部手动计数变量; - 需要多列表并行对齐时结合
zip(),需要逆向访问时配合reversed(),保持代码纯粹与高效。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















