


Python数据分析全流程需要用到哪些第三方库

一个标准的 Python 数据分析项目通常分为五个核心阶段:数据获取、数据清洗与整理、探索性数据分析(EDA)、统计建模与机器学习、以及数据可视化与分析报告输出。每个阶段面对的数据形态和计算目标不同,所依赖的第三方库也各有侧重。掌握每个环节的标准库组合,能够帮助我们在面对实际业务需求时,快速搭建轻量、可靠且可维护的分析代码栈。
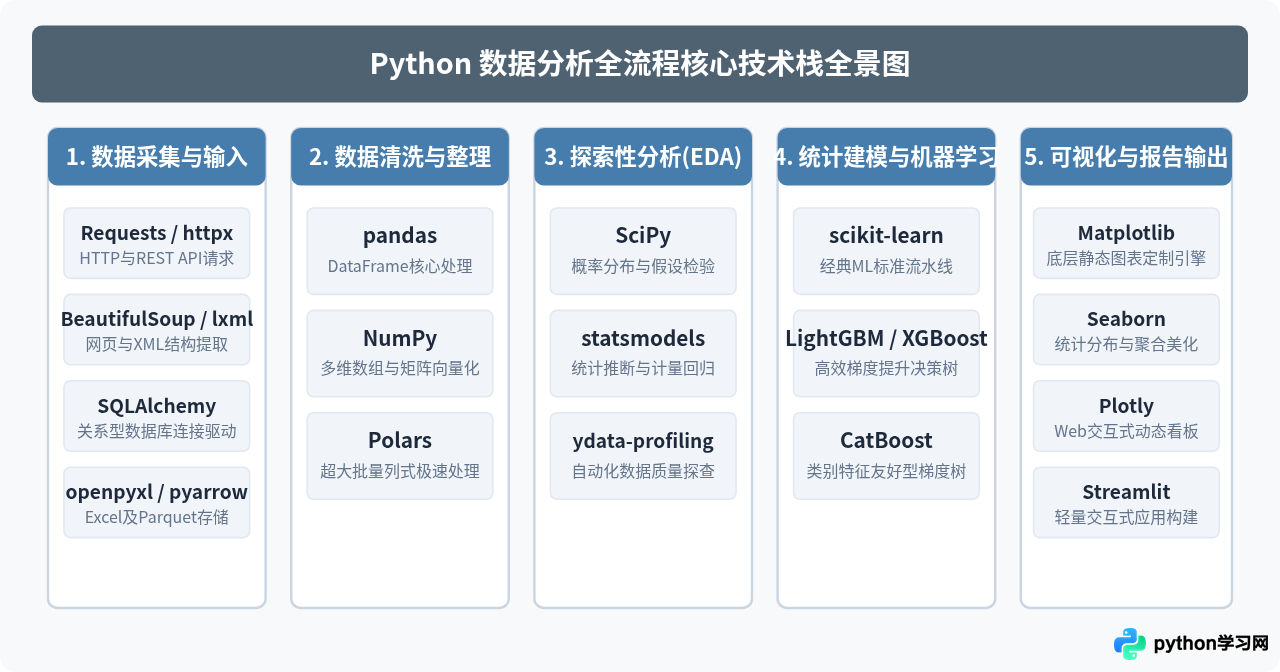
一、数据获取与输入阶段的核心库
真实项目中的数据来源形式多样,常见包括本地扁平文件、企业关系型数据库、第三方开放接口以及无结构化界面的公开网页。针对不同的输入源,需要调用专门的数据接入库。
1. 文件读取基础依赖:openpyxl 与 pyarrow
虽然我们习惯使用 pandas.read_csv() 或 pandas.read_excel(),但 pandas 本身并不包含所有专有文件格式的二进制解析引擎。处理 .xlsx 文件时,必须预装 openpyxl 库;而在处理列式存储文件(如 .parquet、.feather)或跨语言内存交互时,则需要依赖 pyarrow 获得极高的 I/O 吞吐速度。
2. 网络接口与网页爬取:Requests 与 BeautifulSoup4
当数据源为外部 RESTful API 时,requests 或现代化的异步库 httpx 是发送 HTTP GET/POST 请求的标准方案。对于没有提供直接 API 的网页内容,配合 beautifulsoup4 (bs4) 和底层的 lxml 解析引擎,可以迅速解析 HTML 树并提取所需的目标字段。
3. 数据库交互:SQLAlchemy 与数据库驱动
在企业级数据分析中,大量数据直接存储在 MySQL、PostgreSQL 或 SQL Server 中。SQLAlchemy 是 Python 事实上的 SQL 工具包与对象关系映射(ORM)标准。通过它建立统一的数据库连接引擎(Engine),可以无缝对接 pandas 的 read_sql() 和 to_sql() 方法:
import pandas as pd
from sqlalchemy import create_engine

# 示例:连接 PostgreSQL 并直接将查询加载为 DataFrame
engine = create_engine("postgresql+psycopg2://user:password@localhost:5432/analytics_db")
query = "SELECT order_id, user_id, amount, created_at FROM orders WHERE created_at >= '2026-01-01'"
df_orders = pd.read_sql(query, con=engine)
二、数据清洗与整理阶段的核心库
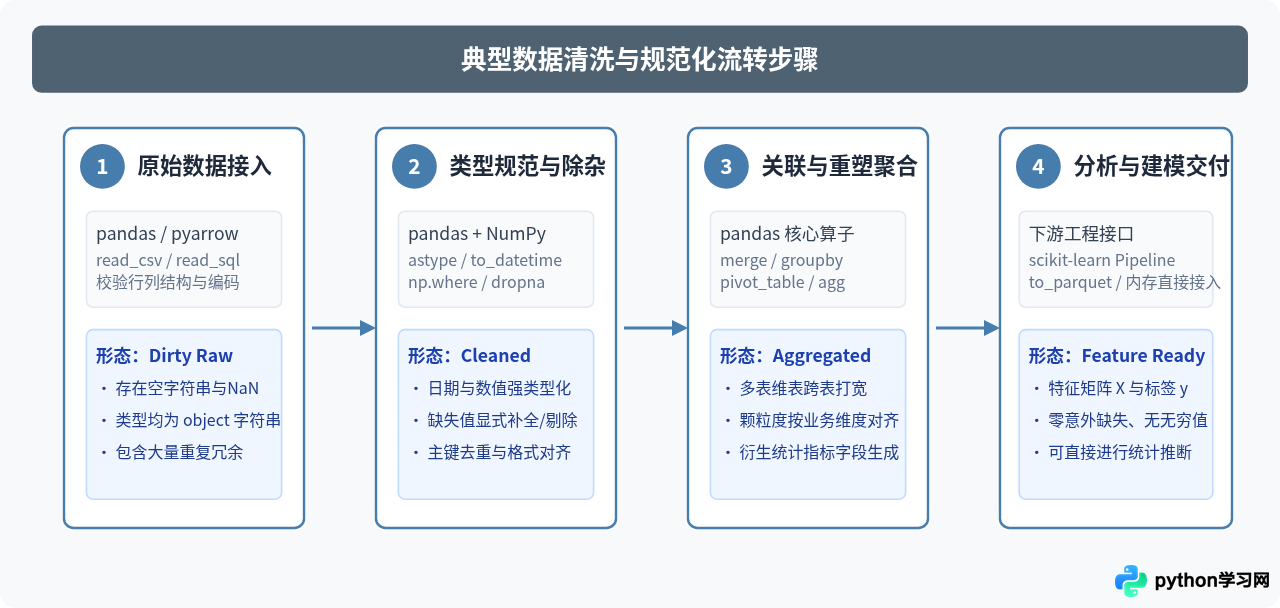
原始数据往往伴随大量缺失值、异常记录、不一致的日期格式和冗余字段。清洗阶段的核心目标是将杂乱无章的原始记录转换成符合“整洁数据(Tidy Data)”规范的二维结构。
1. 表格数据处理事实标准:pandas
pandas 是整个 Python 数据分析生态的基础枢纽。它提供了核心的 DataFrame 与 Series 结构,覆盖了几乎所有常见的数据操作:
- 缺失与重复处理:
dropna()、fillna()、drop_duplicates()等; - 结构重塑与合并:
pivot_table()(透视表)、melt()(逆透视)、merge()(横向关联关联类似 SQL JOIN)与concat()(纵向追加); - 时间序列支持:原生的
pd.to_datetime()、时区转换以及resample()按时间窗口降采样。
2. 底层高性能数值运算:NumPy
NumPy 是 pandas 的基石,提供了底层用 C 语言实现的连续内存连续数组 ndarray。在数据清洗中,NumPy 核心承担以下角色:
- 缺失值标记:通过
np.nan统一标识缺失项; - 向量化条件分支:使用
np.where(condition, x, y)或np.select()代替效率低下的 Python 原生for循环,将百万行数据的分支打标耗时从数秒压缩至数十毫秒; - 数学变换与极值截断:通过
np.log1p()修正偏态分布,或通过np.clip()实现上下限缩尾截断。
3. 海量单机数据选型:Polars
当单表体量从数万行上升到千万行级别(单个 CSV 文件达到数 GB 以上)时,pandas 的单线程瓶颈和高内存占用(通常为磁盘文件体积的 3~5 倍)会导致内存溢出(OOM)。此时,基于 Rust 构建的多线程列式库 Polars 是最佳补充。它拥有类似 Spark 的惰性求值(LazyFrame)与查询优化器,能成倍降低处理延迟并节约内存。
三、探索性分析(EDA)与统计推断库
在进入机器学习模型之前,分析师需要验证变量间的相关性、分布偏态、统计显著性以及数据质量缺陷。
1. 统计计算与科学计算:SciPy
scipy.stats 模块封装了数以百计的连续和离散概率分布,并提供标准的统计检验工具:
- 正态性检验:
shapiro()或normaltest(),用于判断数据是否符合参数检验前提; - 双样本差异比较:
ttest_ind()(独立样本 t 检验)和mannwhitneyu()(非参数 Mann-Whitney U 检验); - 分类关联性检验:
chi2_contingency()(卡方独立性检验)。
2. 计量经济学与严谨统计模型:statsmodels
与侧重于“预测准确率”的机器学习库不同,statsmodels 侧重于“因果推断与参数解释”。例如在普通最小二乘法(OLS)回归中,它不仅给出回归系数,还输出标准误、t 统计量、P 值(P > |t|)以及 95% 置信区间。此外,它在时间序列分析领域(如 ARIMA、SARIMAX、自相关检验 ADF 测试)具有不可替代的专业地位。
四、预测建模与机器学习阶段的核心库
当分析任务由“历史描述”转向“趋势预测与分类判断”时,需要引入机器学习库对数据进行模式提取。
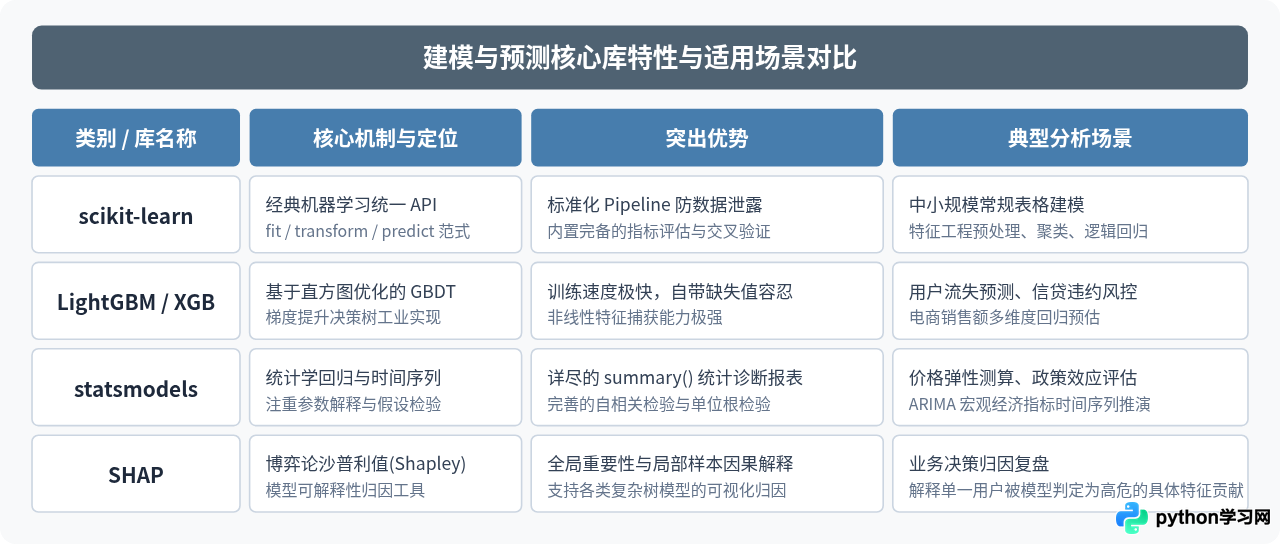
1. 经典机器学习标准库:scikit-learn
scikit-learn 是机器学习工程的通用语言。除了提供逻辑回归、支持向量机(SVM)、随机森林和 K-Means 聚类等经典算法外,其核心价值在于规范了机器学习工程流程:
- 特征工程组件:如
StandardScaler(标准化)、OneHotEncoder(独热编码)与SimpleImputer(补全); - 管道封装:
Pipeline能将数据预处理与模型训练绑定为一个整体,防止训练集与测试集之间产生“数据泄露”; - 调参与验证:
GridSearchCV、StratifiedKFold提供了标准化的超参数搜索与分层交叉验证框架。
2. 工业界表格数据标配:LightGBM 与 XGBoost
在企业真实的结构化表格数据预测中,梯度提升决策树(GBDT)在表现与调优效率上通常优于深度学习网络。LightGBM 凭借高效的直方图算法(Histogram-based)和单边梯度采样(GOSS),在处理数百万行表格时兼具高精度与低显存开销;CatBoost 则对类别特征(Categorical Features)提供了优秀的原生支持,省去了手动高维独热编码的繁琐。
五、数据可视化与分析报告交付库
分析成果最终必须转化为直观的图表或交互工具交付给业务方。Python 针对静态印刷、统计探索与 Web 交互提供了梯度式的可视化库。
1. 像素级底层定制:Matplotlib
Matplotlib 是整个 Python 可视化生态的底层基石。虽然它的默认语法相对繁琐,但通过 fig, ax = plt.subplots() 这一面向对象接口,用户可以对图表的坐标轴刻度、标签位置、图例样式及注释箭头进行毫米级的精确控制,特别适合学术论文与静态报告排版。
2. 快速统计图表:Seaborn
Seaborn 是基于 Matplotlib 封装的高级统计可视化库。它直接接受 pandas DataFrame 作为输入,开箱即用自带优雅的现代配色方案:
- 分布探查:
sns.histplot()(直方图)、sns.kdeplot()(核密度估计图); - 多变量相关性:
sns.heatmap(df.corr(), annot=True),一条语句即可生成带有数值标注的皮尔逊相关系数热力图; - 分类比较:
sns.boxplot()(箱线图)、sns.violinplot()(小提琴图),直观展示不同分组的极值与中位数分布。
3. 现代交互式可视化与 Web 交付:Plotly 与 Streamlit
如果业务方需要在线查看图表细节,静态图片往往难以满足需求:
- Plotly:输出基于 HTML/JavaScript 的矢量交互图,用户可以在浏览器中自由悬浮查看数据点数值、框选局部区域放大、或者切换图例显隐;
- Streamlit:数据分析师无需学习前端 HTML/CSS/JS,只需编写纯 Python 脚本,即可在十几分钟内把 pandas 处理逻辑和 Plotly 交互图表组装成一个带有侧边栏筛选控件、实时下拉菜单的 Web 数据看板应用。
import matplotlib.pyplot as pltplt.rcParams['font.sans-serif'] = ['SimHei', 'PingFang SC', 'Microsoft YaHei']plt.rcParams['axes.unicode_minus'] = False
六、全流程第三方库协同工作流建议
掌握了各个模块的库后,不必在每个项目中全部引入。根据团队硬件环境与分析规模,通常推荐以下两种组合范式:
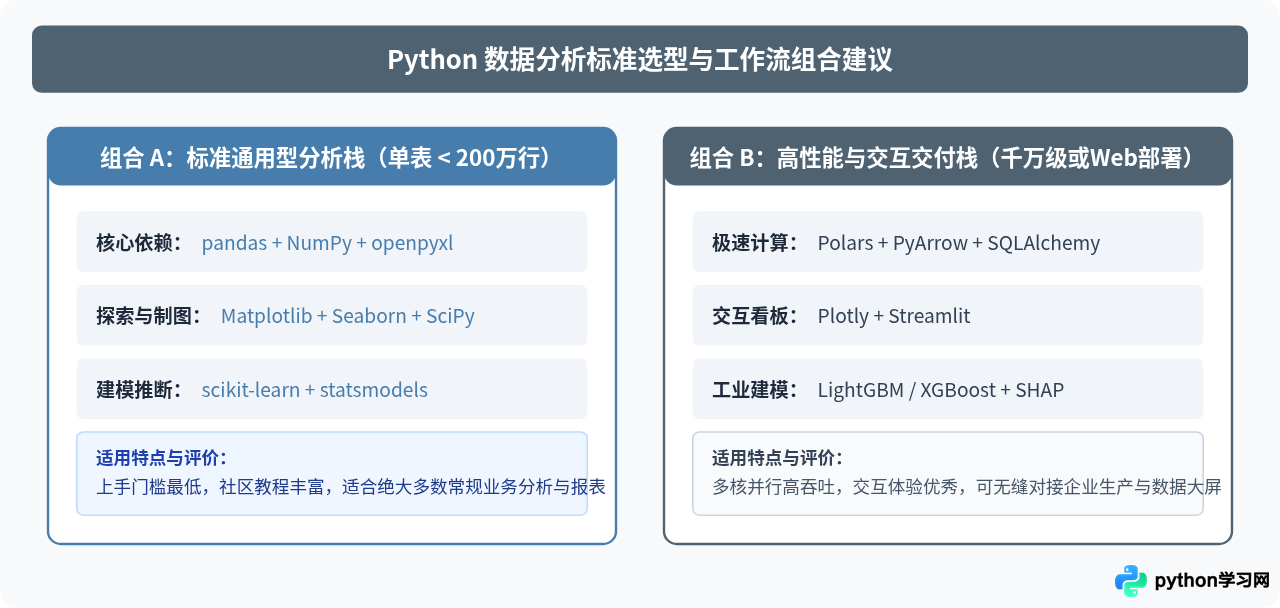
在日常工作流中,先建立一个包含 pandas、NumPy、Matplotlib、Seaborn 与 scikit-learn 的轻量虚拟环境;遇到超大数据集、特殊统计检验或交互交付时,再针对性引入 Polars、statsmodels 或 Streamlit。清晰界定不同库的核心优势,是编写高效、干净、可维护 Python 分析脚本的关键。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















