


Python数据分析必学库:NumPy、Pandas和Matplotlib基础用法

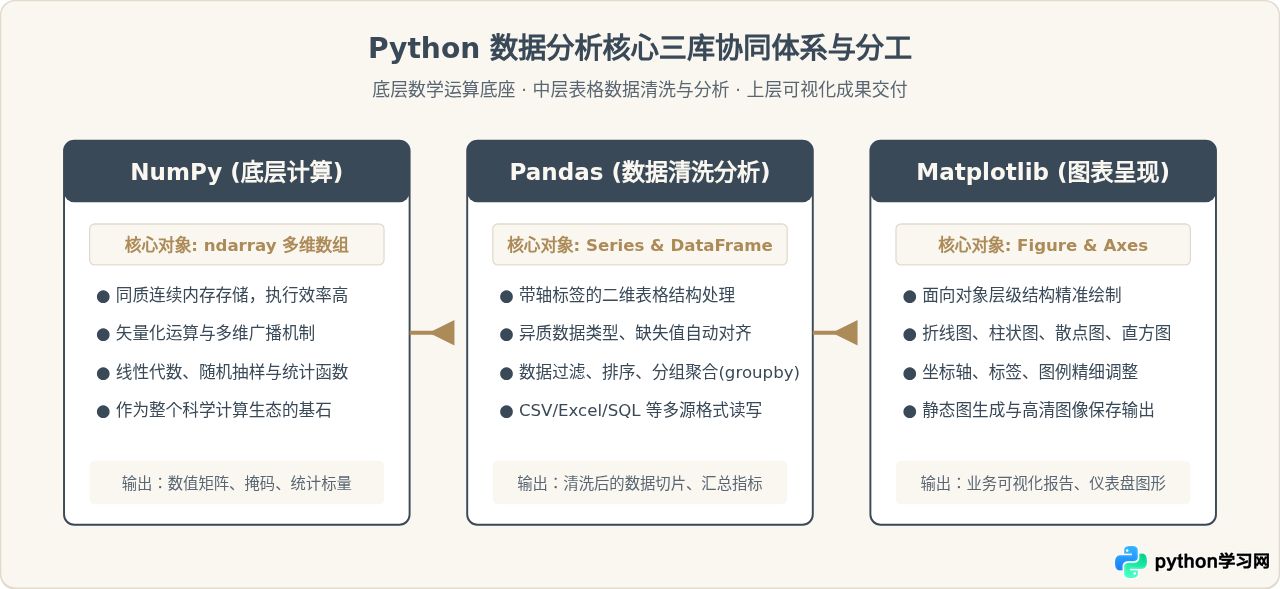
在Python数据分析技术栈中,NumPy、Pandas和Matplotlib构成了一套标准且不可或缺的基础工具链。进行数据处理时,NumPy承担底层高性能数值计算与多维矩阵操作,Pandas在此基础上封装了面向实际业务的表格型数据结构与清洗分析功能,而Matplotlib则负责将处理后的结构化指标转换为直观图表。掌握这三个库的基本用法和数据交接逻辑,是完成任何Python数据分析任务的前提。
一、NumPy 基础用法与核心计算机制
NumPy(Numerical Python)是Python科学计算与数据分析的核心基石。原生Python列表在处理大规模数值运算时效率较低,因为列表存储的是对象的引用指针,各元素在内存中离散分布,且每次运算都需要进行动态类型检查。NumPy引入的 ndarray(N-dimensional Array)是一块连续的同质物理内存,支持由C语言底层直接执行密集向量计算。
1. 数组创建与常用属性
日常使用中,最常见的是将原生嵌套列表转换为 ndarray,或者通过NumPy内置生成函数创建规则数组:
import numpy as np

# 1. 由列表创建一维与二维数组
arr1 = np.array([1, 2, 3, 4, 5])
arr2 = np.array([[10, 20, 30], [40, 50, 60]])

# 2. 内置构造函数生成数值序列
zeros_arr = np.zeros((3, 3))        # 3x3全零浮点矩阵
range_arr = np.arange(0, 10, 2)     # 等差数列 [0, 2, 4, 6, 8]
linear_arr = np.linspace(0, 1, 5)   # 0到1之间均匀切分5个点

# 3. 核心属性查询
print("维度数量 (ndim):", arr2.ndim)      # 示例输出: 2
print("形状结构 (shape):", arr2.shape)    # 示例输出: (2, 3)
print("元素类型 (dtype):", arr2.dtype)    # 示例输出: int64
print("元素总数 (size):", arr2.size)      # 示例输出: 6
2. 维度轴(Axis)与向量广播机制
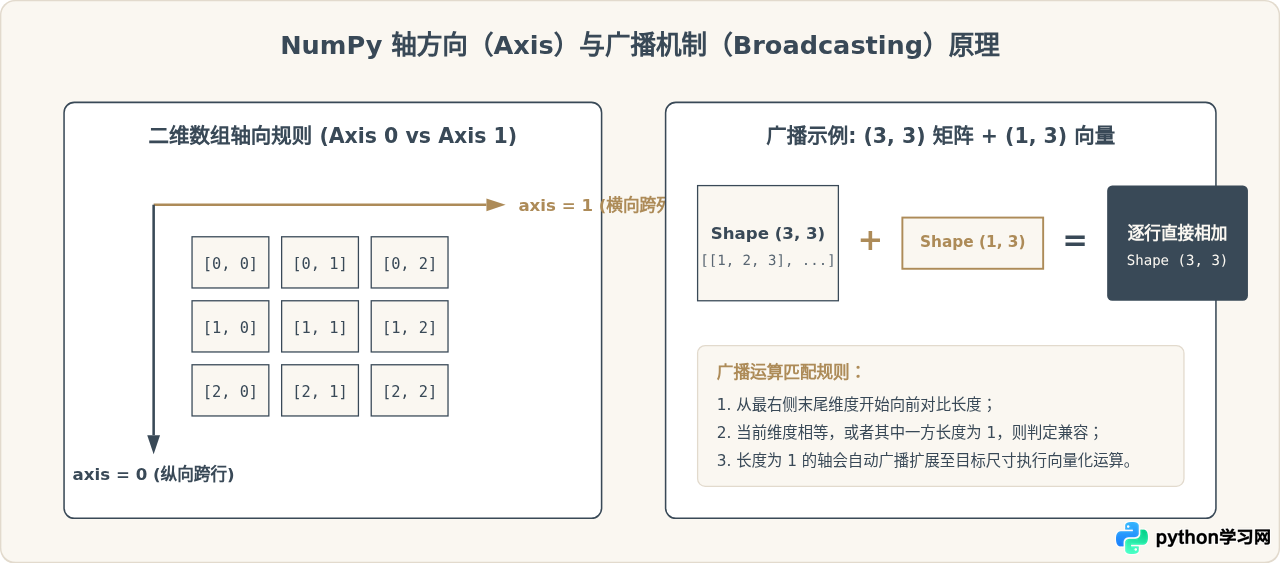
在多维数组运算中,必须清晰理解“轴”(Axis)的概念。对于二维数组,axis=0 代表沿着纵向(行方向向下跨行)计算,常用于对各列分别聚合;axis=1 代表沿着横向(列方向向右跨列)计算,常用于对各行分别聚合。
另一个关键机制是广播(Broadcasting)。当两个形状不同的数组进行算术运算时,若它们的维度从后向前满足“维度尺寸相等”或“其中一个维度尺寸为1”,NumPy会自动在逻辑上将尺寸为1的轴进行平铺复制,从而无需显式循环即可完成运算。
3. 切片索引与布尔掩码操作
NumPy数组支持多维切片与布尔条件筛选,这是进行数值过滤的核心语法:
data = np.array([
    [15, 22, 35],
    [48, 52, 67],
    [71, 88, 93]
])

# 多维切片:行索引 0 到 1(不含2),列索引从第 1 列至末尾
sub_matrix = data[0:2, 1:]
# 示例输出:
# [[22, 35],
#  [52, 67]]

# 布尔掩码索引:提取所有大于 50 的数值
mask = data > 50
filtered_values = data[mask]
# 示例输出: [52, 67, 71, 88, 93]

# 沿轴统计
column_means = data.mean(axis=0)  # 计算各列均值,输出一维数组
row_sums = data.sum(axis=1) # 计算各行总和sub_matrix[0, 0] = 999 进行赋值修改,原始 data 数组对应的位置也会被同步改写。若需要完全独立的内存副本,必须显式调用 data[0:2, 1:].copy()。
二、Pandas 基础用法与结构化数据处理
NumPy解决了底层数值计算效率问题,但实际业务数据通常是异质的(包含字符串、时间戳、浮点数)并且具有列名和行索引。Pandas基于NumPy构建,提供了两种核心数据结构:Series(带索引的一维标记数组)和 DataFrame(带行标签与列标签的二维表格结构)。
1. 数据创建与基础查看
在数据分析项目中,数据通常由外部文件读取,或由Python字典组装构建:
import pandas as pd

# 从字典创建结构化 DataFrame
data_dict = {
    "用户ID": [1001, 1002, 1003, 1004, 1005],
    "城市": ["北京", "上海", "广州", "北京", "深圳"],
    "年龄": [28, np.nan, 35, 42, 29],
    "消费金额": [1200.5, 850.0, 2300.0, 1680.0, 990.5]
}
df = pd.DataFrame(data_dict)

# 查看数据基本概览
print(df.head(3))          # 查看前3行数据
print(df.info())            # 查看各列非空计数与数据类型
print(df.describe())        # 查看数值列的统计指标(均值、标准差、四分位数等)
2. 核心操作:选择、过滤与缺失值处理
进行数据清洗时,最基础的操作是按列选择、条件筛选与处理缺失数据:
# 1. 字段选择与提取
cities = df["城市"]                 # 提取单列,返回 Series
sub_df = df[["用户ID", "消费金额"]]  # 提取多列,返回新的 DataFrame

# 2. 条件过滤(支持 & 与、| 或、~ 非)
beijing_vip = df[(df["城市"] == "北京") & (df["消费金额"] > 1500)]

# 3. 缺失值(NaN)检测与填充
missing_count = df["年龄"].isna().sum()   # 统计缺失行数
df["年龄"] = df["年龄"].fillna(df["年龄"].median())  # 用中位数填充缺失值

# 4. 基于 loc 与 iloc 的标签/位置索引
first_row = df.iloc[0]               # 按整数位置选取第 1 行
val = df.loc[df["用户ID"] == 1003, "消费金额"].values[0]  # 按标签定位数值
3. 分组聚合运算(GroupBy)
数据分析的核心需求之一是对维度进行聚合。Pandas提供了符合“拆分-应用-合并”(Split-Apply-Combine)模式的 groupby() 接口:
# 按城市分组统计消费指标
city_summary = df.groupby("城市").agg(
    用户数=("用户ID", "count"),
    平均消费=("消费金额", "mean"),
    总消费=("消费金额", "sum")
).reset_index()

# 示例输出结构:
#    城市  用户数     平均消费    总消费
# 0  北京    2  1440.25  2880.5
# 1  广州    1  2300.00  2300.0
# 2  上海    1   850.00   850.0
# 3  深圳    1   990.50   990.5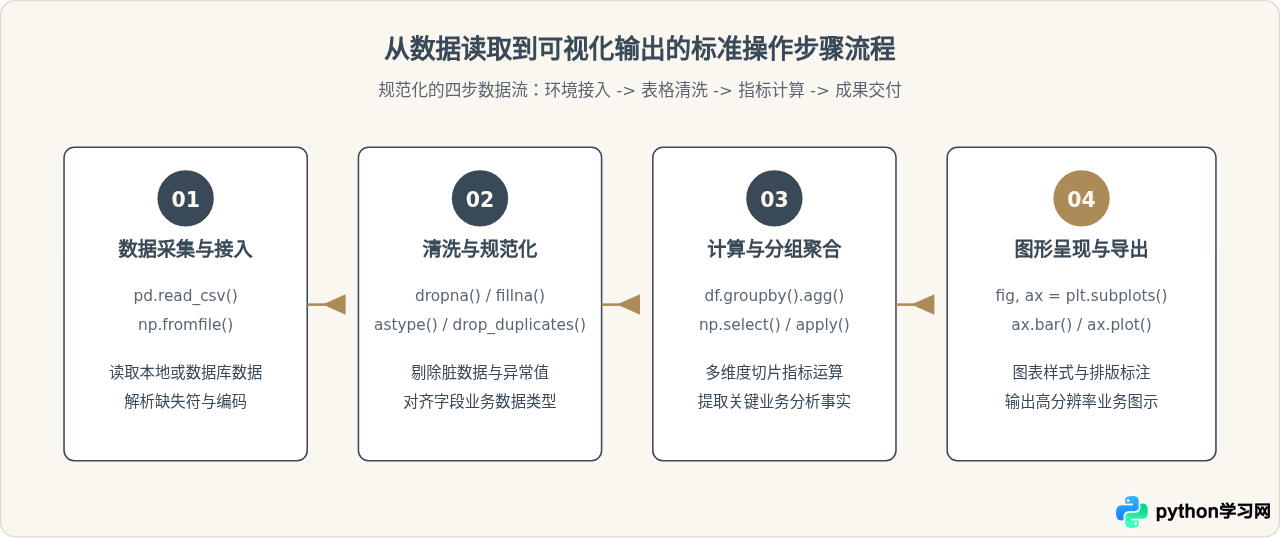
三、Matplotlib 基础用法与面向对象绘图规范
Matplotlib是Python生态中最成熟的绘图库。初学者常直接调用 plt.plot() 这类状态机接口,但在多子图或复杂排版场景下,状态机容易造成坐标系混乱。在工程实践中,推荐使用面向对象接口(Object-Oriented API),即显式创建 Figure(画布)和 Axes(坐标子图)对象。
1. 面向对象绘图的基础骨架
以下为最标准的面向对象绘图范式,展示折线图与柱状图的组合绘制方法:
import matplotlib.pyplot as plt

# 设置中文字体与负号正常显示
plt.rcParams['font.sans-serif'] = ['PingFang SC', 'Microsoft YaHei', 'SimHei']
plt.rcParams['axes.unicode_minus'] = False

# 1. 显式创建画布(fig)与子图坐标系(ax)
fig, ax = plt.subplots(figsize=(8, 4.5), dpi=100)

# 2. 准备数据(通常来自 Pandas 统计结果)
categories = ["第一季度", "第二季度", "第三季度", "第四季度"]
revenue = [120, 150, 180, 220]
target = [100, 140, 170, 200]

# 3. 在指定坐标系上绘制图形
ax.bar(categories, revenue, color="#394957", width=0.5, label="实际营收(万元)")
ax.plot(categories, target, color="#AD8B58", marker="o", linewidth=2.5, label="目标基线(万元)")

# 4. 图表细节装饰与配置
ax.set_title("年度季度营收对比趋势", fontsize=14, fontweight="bold", pad=12)
ax.set_xlabel("统计季度", fontsize=11)
ax.set_ylabel("金额 (万元)", fontsize=11)
ax.grid(True, linestyle="--", alpha=0.5)
ax.legend(loc="upper left")

# 5. 显示或保存图像文件
# plt.savefig("revenue_chart.png", bbox_inches="tight", dpi=300)
plt.show()
2. 常见图表类型与对应调用
- 折线图(
ax.plot):适合观察数值随连续变量(如时间、周期)的变动趋势。 - 柱状图(
ax.bar/ax.barh):适合对比离散分类指标之间的差异与分布。 - 散点图(
ax.scatter):适合探索两个数值变量之间的相关性或集群分布。 - 直方图(
ax.hist):适合观察单变量数值的连续频数分布与偏态特征。
四、三库协同实战案例:销售明细数据分析与出图
为了让读者直观理解三者在实际工作中的协作流程,下面通过一段完整且连续的代码示例,演示从原始数据构建、清洗聚合到图形输出的闭环:
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

# ----------------- 步骤 1: NumPy 辅助生成模拟销售数据 -----------------
np.random.seed(42)
days = 100
dates = pd.date_range(start="2024-01-01", periods=days, freq="D")
sales_base = np.random.normal(loc=5000, scale=800, size=days)
channels = np.random.choice(["线上商城", "线下门店", "企业直销"], size=days)

# ----------------- 步骤 2: Pandas 数据结构化与分组统计 -----------------
df_sales = pd.DataFrame({
    "日期": dates,
    "销售渠道": channels,
    "销售额": sales_base.round(2)
})

# 按渠道计算总销售额与平均单日业绩
channel_perf = df_sales.groupby("销售渠道")["销售额"].agg(["sum", "mean"]).reset_index()

# ----------------- 步骤 3: Matplotlib 成果可视化呈现 -----------------
fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(11, 4.5), dpi=100)

# 子图 1: 各渠道销售总额柱状图
ax1.bar(channel_perf["销售渠道"], channel_perf["sum"] / 10000, color="#394957", width=0.45)
ax1.set_title("各渠道累计销售总额 (万元)", fontsize=12, fontweight="bold")
ax1.set_ylabel("金额 (万元)")
ax1.grid(axis="y", linestyle=":", alpha=0.6)

# 子图 2: 每日整体销售额走势折线图
daily_trend = df_sales.groupby("日期")["销售额"].sum()
ax2.plot(daily_trend.index, daily_trend.values, color="#AD8B58", linewidth=1.5)
ax2.set_title("每日销售额波动走势", fontsize=12, fontweight="bold")
ax2.set_ylabel("金额 (元)")
ax2.grid(True, linestyle=":", alpha=0.6)

fig.autofmt_xdate()
plt.tight_layout()
plt.show()
五、三库核心特征与知识总结
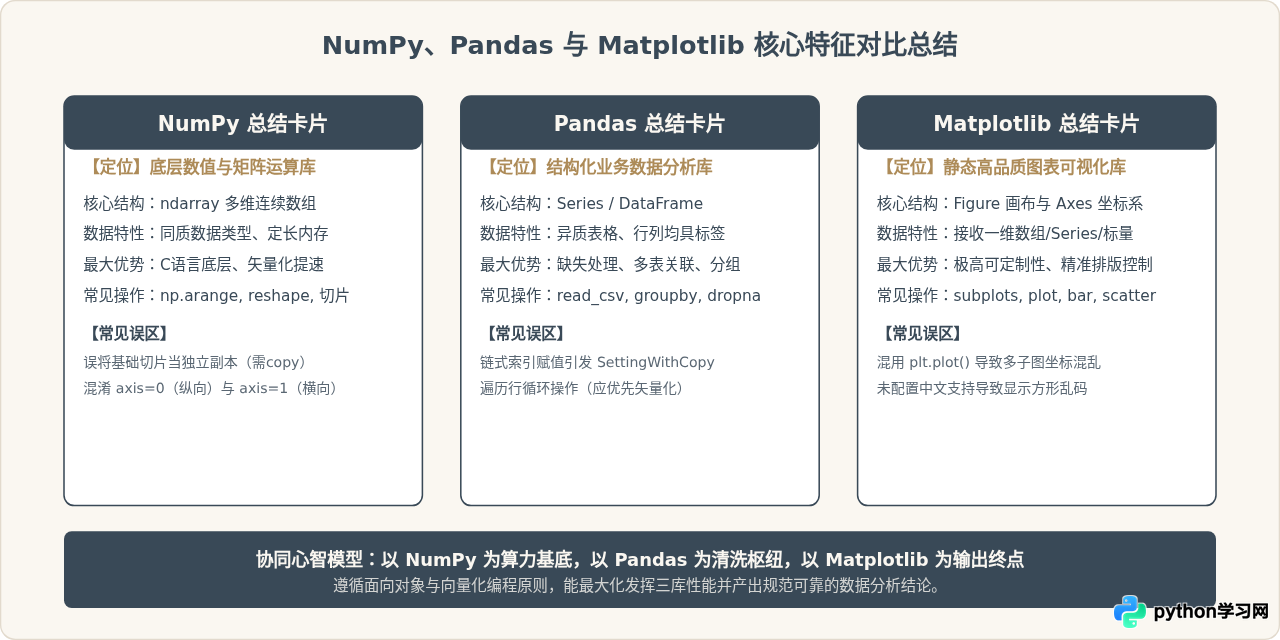
在日常学习与工程开发中,明确各库的适用边界是写出高效、优雅代码的关键。下表与图示全面总结了三个库的核心差异与协作关系:
六、常见使用陷阱与避坑建议
初学者在结合使用这三个库时,常常会遇到以下三个典型问题:
- Pandas 的
SettingWithCopyWarning警告:通常由于“链式索引”(例如df[df["A"] > 0]["B"] = 1)引起。此时Pandas无法确定修改的是视图还是副本。正确做法是使用loc显式指定:df.loc[df["A"] > 0, "B"] = 1。 - 过度使用 Python 原生
for循环:无论是NumPy还是Pandas,在数组或数据框上使用for row in df.iterrows()遍历都会丧失C底层的矢量化加速优势,性能常下降数个数量级。应尽可能使用内置矢量运算或apply()函数。 - Matplotlib 中文字符显示为方块乱码:Matplotlib默认字体列表不包含中文字体。在导入库后,必须配置
plt.rcParams['font.sans-serif'] = ['PingFang SC', 'Microsoft YaHei', 'SimHei'],并同时设置plt.rcParams['axes.unicode_minus'] = False以正确显示负号。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















