


自学Python容易找不到工作吗?避开低效学习的3个关键

自学 Python 确实容易遇到求职困难,但核心症结通常不在于“自学”这一途径本身,而在于学习目标与用人需求脱节:多数自学者长期停留在基础语法与小脚本阶段,缺乏对特定岗位技术栈的聚焦、可验证的工程化交付能力以及对技术机理的排错溯源能力。要有效提升求职成功率,需要把精力从盲目刷题与泛化漫游转向三个关键实践:确立垂直岗位技术锚点、交付符合生产标准的完整工程,以及养成基于源码与文档的深度排错习惯。
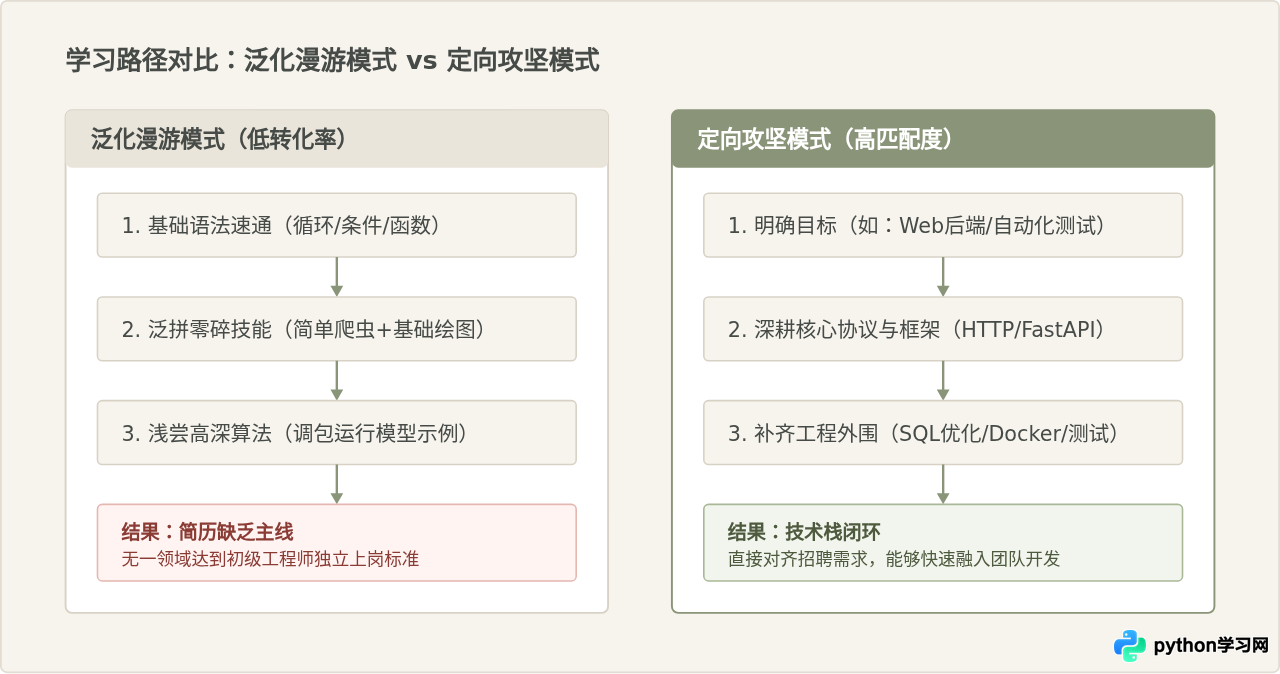
关键一:拒绝无差别的“全能泛读”,以垂直岗位技术栈为锚点
Python 语言的应用领域极为广泛,涵盖自动化运维、Web 后端、爬虫、数据分析、自动化测试以及人工智能等方向。不同岗位对候选人的能力模型要求差异巨大。很多自学者从基础语法学起后,按照流行教程将各个领域依次涉猎一遍:今天写一个简单爬虫,明天调用 Pandas 计算均值,后天运行一个机器学习入门示例。这种看似丰富的履历在企业招聘时往往显得定位模糊,无法满足任何一个专职岗位的深入要求。
认知辨析:“只要把 Python 通用语法学精,面试任何岗位都可以进公司现学现用。”这种说法在理论上有一定道理,扎实的语法基础确实利于后续迁移,但对于初级招聘场景并不成立。企业招聘初级工程师通常需要新人能在极短培训后承接具体业务模块(例如编写数据提取流水线或维护 REST API),如果候选人对目标岗位依赖的核心协议、框架和数据库缺乏实际使用经验,招聘成本将大幅提升。
高效的学习策略是在掌握基础语法后尽早锁定一个细分方向,并围绕该方向构建技术护城河。以 Web 后端开发方向为例,除了语言本身的特性外,学习计划必须紧密覆盖以下配套能力:
- 传输协议与网络基础:理解 HTTP/HTTPS 协议结构、状态码规范、RESTful 接口设计原则与 Cookie/Session/Token 认证机制。
- 主流框架专精:深度掌握至少一款主流框架(如 FastAPI 或 Django),熟练使用路由系统、依赖注入、中间件与序列化组件。
- 数据持久化技术:熟练使用关系型数据库(如 PostgreSQL 或 MySQL),掌握索引原理、事务隔离级别以及 ORM 查询优化技巧。
- 基础工程支持:具备在 Linux 环境下运行调试程序的能力,熟练配置虚拟环境与 Dockerfile 容器化镜像。
关键二:跳出“教程代码搬运”,构建具备工程化交付闭环的项目
自学者简历中普遍存在“项目雷同”与“工程成熟度低”的问题。诸如“图书管理系统”、“简易博客”或“几行代码爬取天气预报”这类案例,大多来自网络教程的直接照搬。这类项目通常只展现了最基础的代码组织,缺乏对实际业务异常、边界状态、数据一致性和部署维护的考量,很难作为求职的有效技术佐证。
认知辨析:“按照视频教程把项目敲出来、跑成功,就算完成了项目经验积累。”参考优质教程确实是起步的合理方式,但如果代码只是原样临摹,没有脱离脚手架的自主设计,求职者就无法向面试官证明自己在面对新需求时的建模能力、技术选型理由以及解决复杂 Bug 的能力。
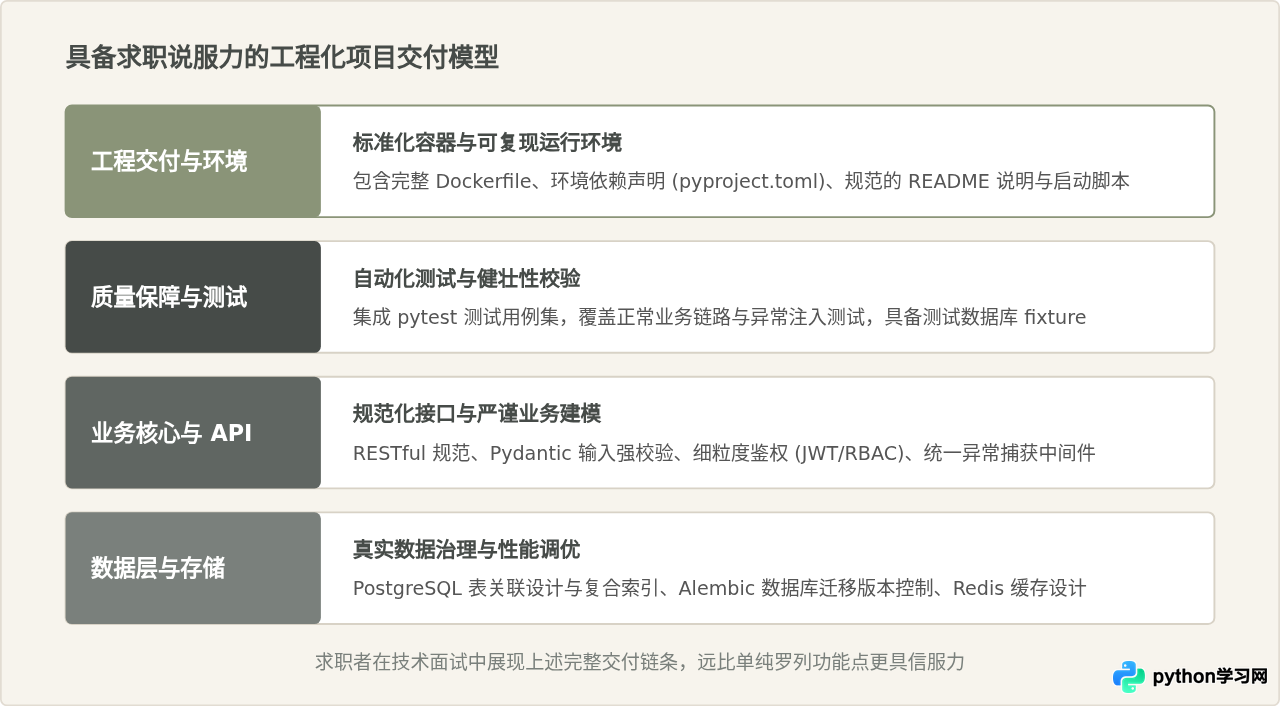
一个具有求职说服力的项目并不一定需要庞大的业务规模,但必须具备完整的“工程化交付素养”。具体应包含以下四个维度:
- 业务逻辑严谨性:实现真实的权限校验、数据验证拦截(如使用 Pydantic 进行严格入参校验)与合理的全局错误响应格式。
- 自动化测试覆盖:项目必须包含清晰的单元测试或集成测试(基于 pytest),对核心业务逻辑、边界值及异常路径进行自动化断言验证。
- 基础设施可复现性:提供清晰的
requirements.txt或pyproject.toml,提供标准的Dockerfile,确保任何人在全新的机器上执行一条命令即可运行该项目。 - 完善的技术文档:具备规范的
README.md,清晰说明系统架构、核心接口规范、本地启动步骤、测试运行方式以及技术选型背后的思考权衡。
关键三:从“能运行即可”转向“知其所以然”,建立深度排错与原理溯源习惯
在面试过程中,许多自学者能够流畅介绍自己写过的功能代码,但面对“深入一步”的追问时往往难以招架。例如:当被问到“这个数据库操作在大并发下会出现什么问题?”、“Python 的垃圾回收什么时候会发生?”或“为什么要用生成器而不是直接返回列表?”时,回答常常含糊其辞。这种只关注“代码跑通”而忽略“底层机理”的学习惯性,是阻碍自学者通过专业技术面试的主要门槛。
认知辨析:“初级程序员主要负责写业务逻辑,底层原理是架构师需要考虑的事情。”这种想法混淆了“设计底层架构”与“理解执行原理”。在真实的团队协作中,哪怕是初级开发编写的一句简单的数据库查询或多线程调用,若对底层机制(如 GIL、连接池耗尽、ORM 产生的 N+1 查询问题)缺乏基础认知,就很容易在生产环境中引入严重性能瓶颈或死锁问题。
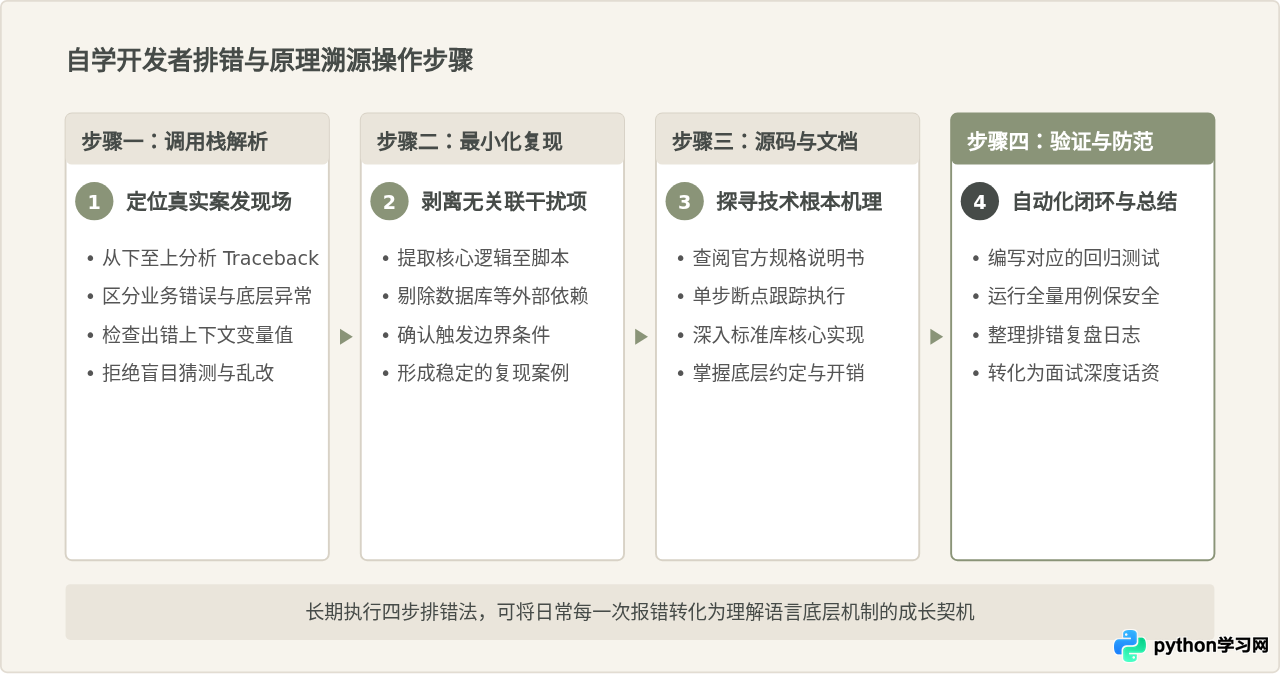
要摆脱这种浅层学习,需要在日常编写代码和排查故障时养成结构化的排错与溯源四步法。当程序发生报错或非预期输出时,不要立刻复制错误信息到搜索框中机械尝试解决方案,而应按照以下步骤定位本质:
- 第一步:解析调用栈轨迹(Traceback)
从下往上仔细阅读报错信息,明确具体异常类型(如KeyError,TypeError,OperationalError),准确识别引发异常的最内层业务代码行号,理清参数在调用栈各层间的传递过程。 - 第二步:剥离依赖,构建最小复现用例(MRE)
将复杂的业务代码抽离,仅保留触发该 Bug 所必需的最简代码片段与测试数据。通过减少干扰变量,快速确认是参数逻辑问题、边界条件遗漏还是第三方库版本差异。 - 第三步:研读官方文档与标准库源码
针对涉及的核心函数或类,查阅官方文档中的参数约束、异常说明和生命周期,必要时在 IDE 中点击查看标准库或第三方库源码实现,理解其内部运行流程。 - 第四步:编写针对性测试并复盘机理
设计一个能够直接触发该异常的单元测试用例,实施修复后确保测试变绿;记录该问题发生的根本原因与防范措施,形成技术沉淀。
求职准备度自查:评估自身是否具备上岗条件
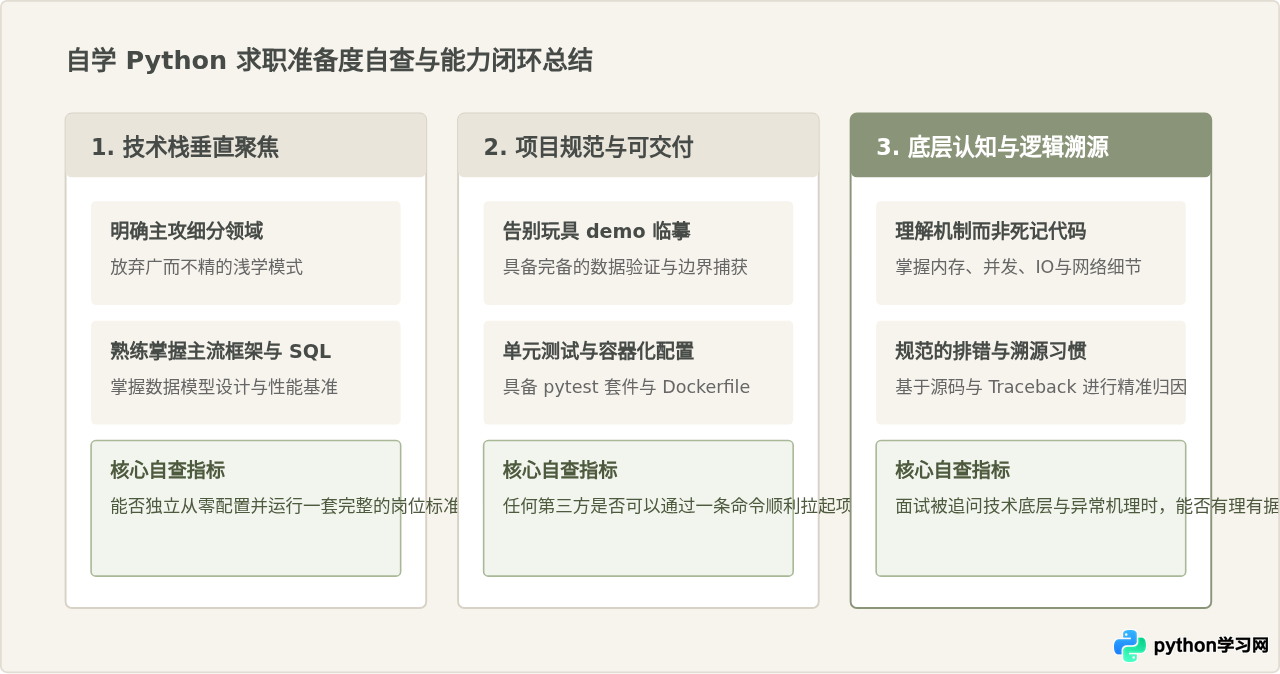
在正式投递简历前,自学者可以对照以下三个维度的清单自测,判断自己当前的技术储备是否足以应对企业招聘的技术考察:
- 技术栈契合度:是否能够清晰回答所选方向(如 Web 开发)核心生态组件的协同关系,例如从客户端发出请求到服务端经过路由、中间件、业务函数、ORM 乃至数据库索引查找的全链路细节。
- 代码与工程规范:GitHub 或 Gitee 上是否有结构规范、注释合理、排版符合 PEP 8、具备完整测试用例和 Docker 配置的开源项目仓库。
- 表达与思考深度:是否能够清晰向他人阐述项目中某项技术选型的理由、曾遇到过的最棘手 Bug 及其背后的根因分析,而不是单纯罗列“实现了哪些功能”。
综上所述,自学 Python 并不必然带来求职壁垒。只要在学习过程中克制住浅尝辄止的泛化诱惑,紧扣具体岗位的实际技能需求,以扎实的工程规范打造具有完整测试与交付能力的项目,并在日常开发中养成深究错误根因与技术机理的良好习惯,自学者同样能够在技术招聘中建立起清晰的竞争优势。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















