


Python项目怎么选择合适的数据库

选择数据库不存在"最好"的答案,只有"最合适"的方案。一个Python项目该用哪种数据库,取决于四件事:数据本身的结构和体量、读写访问的模式、项目的部署环境,以及团队的维护能力。把这几个维度理清楚,选型的范围会迅速缩小。下面从实际出发,帮你建立一套可操作的判断流程。
先弄清楚你的数据长什么样
数据库分为关系型和非关系型两大阵营,而选择的第一步就是看数据结构。
结构固定、表间有关联——比如用户表、订单表、商品表之间存在明确的一对多或多对多关系——这种场景天然适合关系型数据库(RDBMS)。关系型数据库通过外键和事务机制保证数据一致性,SQL查询可以方便地做多表联合。Python生态中最常用的关系型数据库是 SQLite、PostgreSQL 和 MySQL。
结构灵活、字段经常变化——比如爬虫抓取的网页数据,每个页面提取出的字段不完全一样;或者物联网设备上报的 JSON 数据,不同型号的字段差异很大——这时文档型数据库(如 MongoDB)更省事,不需要预先定义表结构,直接存 JSON 文档即可。
简单的键值对或需要极快的读写速度——例如缓存会话、排行榜、消息队列——Redis 这类键值/内存数据库是第一选择。它的数据模型简单,速度极快,但不适合存放需要复杂查询的业务数据。
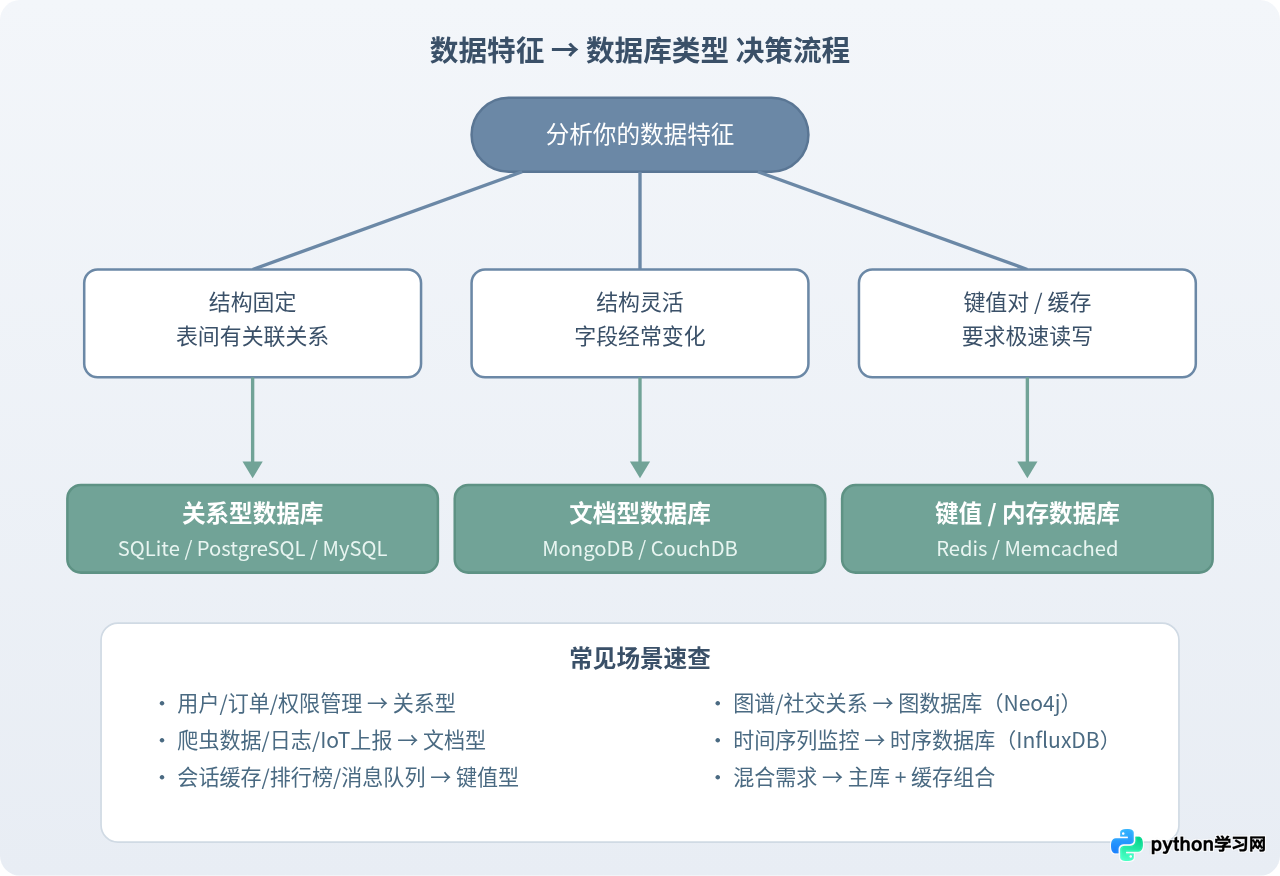
图1:根据数据特征判断数据库类型的决策路径
Python中最常用的几种数据库,分别适合什么项目
缩小了类型范围之后,下一步是在同类数据库里做具体选择。下面逐个说明 Python 项目中出现频率最高的五种数据库。
SQLite:单机小项目的默认选择
SQLite 是一个嵌入式数据库,整个数据库就是一个文件,不需要安装服务端。Python 标准库自带 sqlite3 模块,零配置即可使用。
适合的场景包括:本地工具脚本、桌面应用、小型 Web 应用(日活几百以内)、数据分析中的临时存储,以及原型开发阶段先跑通流程。
不适合的场景:多个进程或服务需要同时大量写入同一个数据库——SQLite 对并发写入的支持有限,写操作会锁住整个数据库文件。如果你的项目未来要部署成多实例的 Web 服务,SQLite 就不够用了。
# 标准库直接使用,无需安装
import sqlite3

conn = sqlite3.connect("myapp.db")
cursor = conn.cursor()
cursor.execute("""
    CREATE TABLE IF NOT EXISTS users (
        id INTEGER PRIMARY KEY AUTOINCREMENT,
        name TEXT NOT NULL,
        email TEXT UNIQUE
    )
""")
conn.commit()
conn.close()
PostgreSQL:功能最全面的开源关系型数据库
PostgreSQL 对数据类型的支持非常丰富:原生 JSON/JSONB 字段、数组、范围类型、全文搜索,还有扩展插件(如 PostGIS 处理地理数据)。如果你的项目既需要严格的关系模型,又偶尔需要存一些半结构化数据,PostgreSQL 一个就能覆盖,不必再引入 MongoDB。
Python 中操作 PostgreSQL 最常用的驱动是 psycopg2(同步)和 asyncpg(异步),ORM 方面 SQLAlchemy 和 Django ORM 都对 PostgreSQL 支持得最好。
适合的场景:中大型 Web 应用、需要复杂查询和事务的业务系统、数据仓库的在线部分、对数据完整性要求高的金融或电商项目。
# 使用 psycopg2 连接 PostgreSQL
# 安装:pip install psycopg2-binary
import psycopg2

conn = psycopg2.connect(
    host="127.0.0.1",
    port=5432,
    dbname="myapp",
    user="appuser",
    password="your_password"
)
cursor = conn.cursor()
cursor.execute("SELECT version();")
print(cursor.fetchone())
# 示例输出:('PostgreSQL 15.4 on x86_64-pc-linux-gnu...',)
conn.close()
MySQL:Web开发中使用最广泛的数据库
MySQL 的生态非常成熟,大量教程和运维工具围绕它构建。如果你接手的项目已经在用 MySQL,或者部署环境只提供 MySQL(很多共享主机和云服务默认提供 MySQL),继续用它是最省事的选择。
MySQL 和 PostgreSQL 最大的差异在于:MySQL 默认配置下追求速度,某些场景对数据一致性的保障不如 PostgreSQL 严格;PostgreSQL 则在功能和标准合规性上更胜一筹。对于大多数 CRUD 应用来说,两者都能胜任,选择往往取决于团队经验和现有基础设施。
Python 驱动方面,pymysql(纯 Python)和 mysqlclient(C 扩展,速度更快)是最常见的选择。
MongoDB:灵活结构数据的文档仓库
MongoDB 以 BSON(类似 JSON 的二进制格式)存储文档,每条记录可以有不同的字段。Python 通过 pymongo 驱动操作 MongoDB 非常自然——传入和取出的都是 Python 字典。
适合的场景:内容管理系统(文章结构不统一)、产品目录(不同品类属性差异大)、快速迭代期需要频繁改表结构的项目、日志和事件存储。
需要注意:MongoDB 不支持跨文档的 ACID 事务(4.0 版本之后部分支持多文档事务,但使用成本较高)。如果你的业务核心是"转账""扣库存"这类需要严格事务的操作,MongoDB 不是好选择。
# 使用 pymongo 操作 MongoDB
# 安装:pip install pymongo
from pymongo import MongoClient

client = MongoClient("mongodb://127.0.0.1:27017/")
db = client["myapp"]
collection = db["products"]

# 插入一条文档,不需要预定义字段
collection.insert_one({
    "name": "机械键盘",
    "price": 399,
    "specs": {"switch": "红轴", "layout": "87键"},
    "tags": ["外设", "办公"]
})

# 查询
product = collection.find_one({"name": "机械键盘"})
print(product["specs"]["switch"])
# 示例输出:红轴
Redis:高速缓存和简单数据结构
Redis 把数据存在内存中,读写速度可以达到微秒级别。它支持字符串、列表、集合、有序集合、哈希等数据结构,非常适合做缓存层、会话管理、计数器和排行榜。
Redis 通常不单独作为主数据库使用,而是和关系型数据库搭配。比如 PostgreSQL 存储业务数据,Redis 缓存热点查询结果,用户请求先查 Redis,命中就直接返回,没命中再查 PostgreSQL 并回写缓存。
# 使用 redis-py 操作 Redis
# 安装:pip install redis
import redis

r = redis.Redis(host="127.0.0.1", port=6379, db=0)
r.set("session:user_1001", "active", ex=3600)  # 设置1小时过期
status = r.get("session:user_1001")
print(status)
# 示例输出:b'active'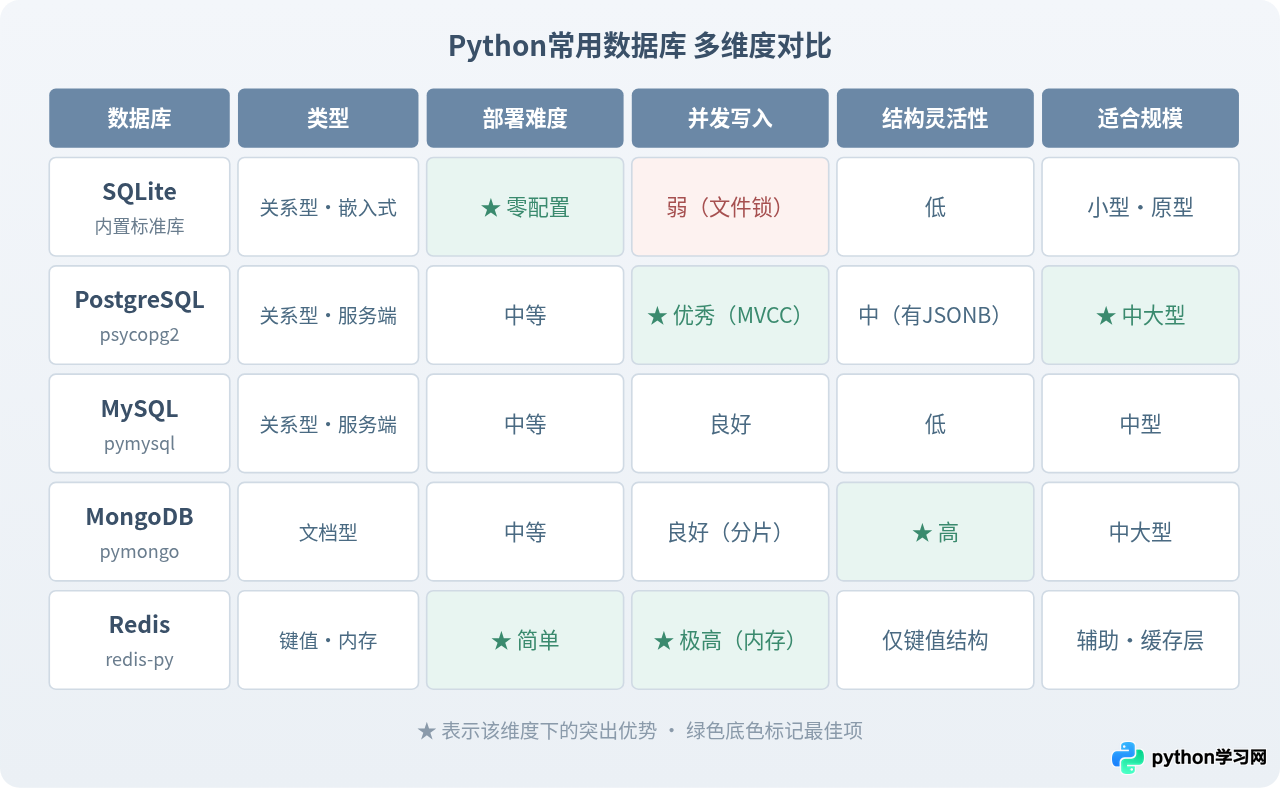
图2:五种常用数据库在部署难度、并发写入、结构灵活性和适合规模上的对比
除了数据结构,还要看这几个现实因素
很多人只看功能对比表就做决定,忽略了项目的实际约束。以下几个问题往往比技术参数更影响最终选择。
项目现在有多大,未来会长到多大?
如果只是一个几千条记录的工具脚本,SQLite 就够了,引入 PostgreSQL 反而增加了部署和维护的负担。但如果你现在做的是一个面向用户的 Web 服务,预计半年内数据量过百万行、需要多台服务器部署,那从一开始就选 PostgreSQL 或 MySQL 会省去后面迁移的麻烦。
一个实用的判断方法:如果你的应用跑在单台机器上,不需要多个进程同时写数据库,SQLite 就是最简方案;一旦需要"数据库服务独立部署"或"多个应用实例共享同一个数据库",就该切换到客户端-服务器架构的数据库。
团队熟悉什么?
技术选型不是考试,不需要选最先进的。如果团队所有人都熟悉 MySQL,没有人用过 PostgreSQL,而项目的需求 MySQL 完全能满足,那选 MySQL 就是合理的。数据库出问题时的排查和优化,很大程度上依赖经验积累,一个团队不了解的技术在生产环境出事故的代价远高于技术上的那点差异。
部署环境提供什么?
在云平台上,托管数据库服务可以省去大量运维工作。AWS RDS 支持 PostgreSQL 和 MySQL;如果你用的是 MongoDB Atlas,MongoDB 的部署运维会简单很多。部署环境的限制有时直接决定了选择——比如某些 Serverless 平台对 SQLite 支持良好,而连接传统数据库需要额外配置连接池。
要不要用 ORM?
ORM(对象关系映射)在 Python 中很流行,SQLAlchemy 和 Django ORM 是两个主力。使用 ORM 的好处是切换数据库时改动较小——比如开发阶段用 SQLite,上线后切 PostgreSQL,只需要改连接字符串。但 ORM 也有代价:复杂查询的性能调优不如直接写 SQL 透明,而且 ORM 生成的 SQL 有时效率不理想。
如果你的项目以常规 CRUD 为主,ORM 能大幅提升开发效率;如果有大量复杂报表查询或对性能要求很高的热路径,建议至少在关键部分直接写 SQL。
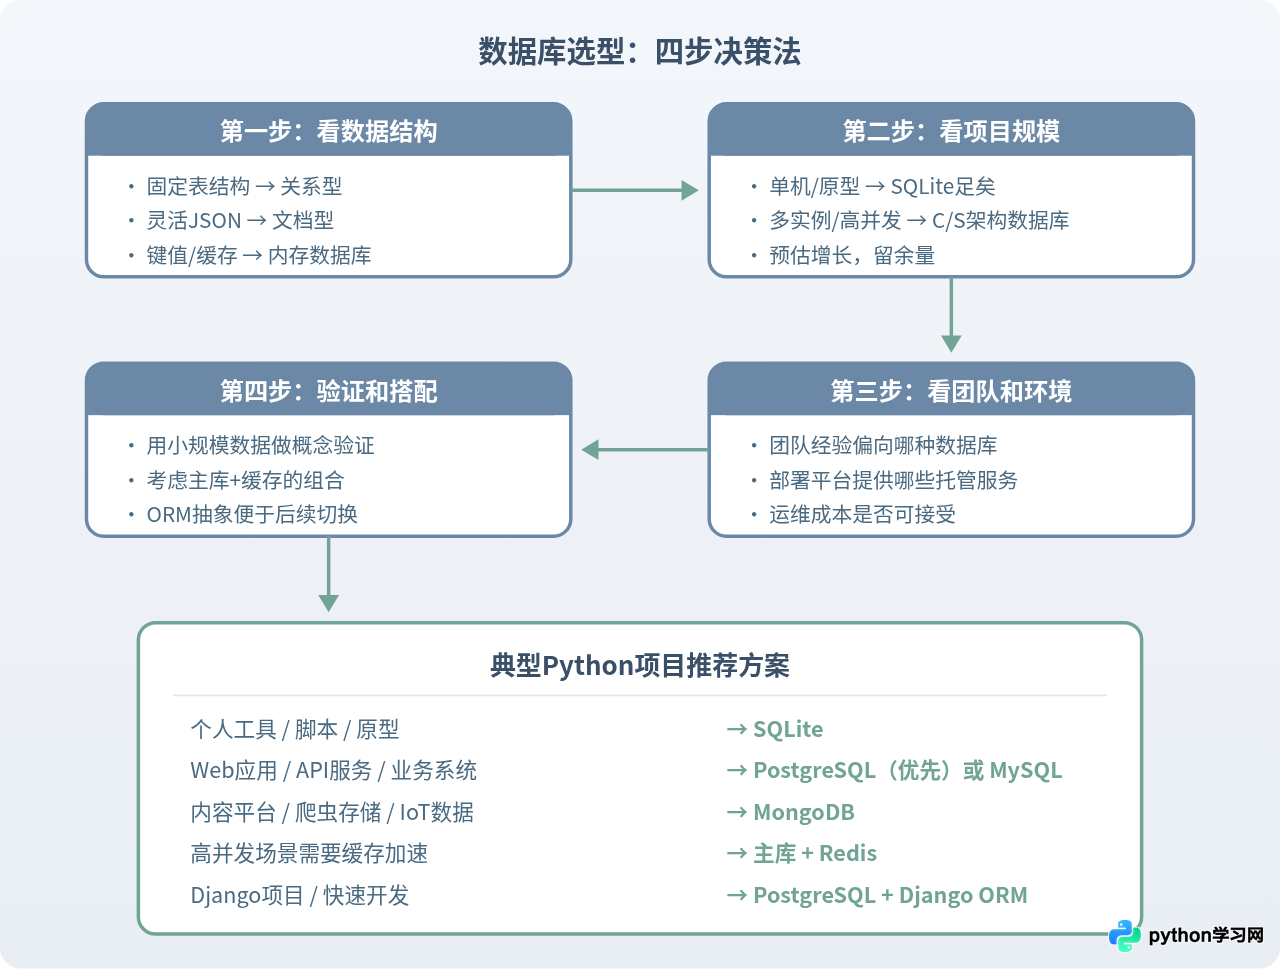
图3:从数据结构到最终方案的四步决策过程与典型推荐
一个实际的选型过程演示
假设你要做一个在线书店系统,包含用户注册登录、图书浏览、购物车、下单付款这些功能,预计上线后日活几千人。按照前面的思路走一遍:
第一步,数据结构。用户、图书、订单、订单项之间有明确的关联关系(一个用户有多个订单,一个订单包含多本书),需要事务保证下单和扣库存的一致性。结论:用关系型数据库。
第二步,规模。日活几千人,数据量在百万行级别,需要部署在云服务器上,可能未来做读写分离。结论:不用 SQLite,选 PostgreSQL 或 MySQL。
第三步,团队和环境。假设团队用 Django 框架,Django 官方文档推荐 PostgreSQL 并且对它的功能支持最完整(比如 ArrayField、JSONField、全文搜索)。云平台上有 PostgreSQL 托管服务。结论:选 PostgreSQL。
第四步,搭配。首页热门书单、用户会话这些读取频繁的数据可以用 Redis 缓存。Django 通过 django-redis 包就能接入 Redis 作为缓存后端和会话引擎。
最终方案:PostgreSQL 做主数据库 + Redis 做缓存层,通过 Django ORM 操作。
# Django settings.py 中的数据库和缓存配置示例

DATABASES = {
    "default": {
        "ENGINE": "django.db.backends.postgresql",
        "NAME": "bookstore",
        "USER": "appuser",
        "PASSWORD": "your_password",
        "HOST": "127.0.0.1",
        "PORT": "5432",
    }
}

CACHES = {
    "default": {
        "BACKEND": "django_redis.cache.RedisCache",
        "LOCATION": "redis://127.0.0.1:6379/1",
        "OPTIONS": {
            "CLIENT_CLASS": "django_redis.client.DefaultClient",
        }
    }
}
容易踩的几个坑
过早引入多种数据库。一个小项目同时用 PostgreSQL 存业务数据、MongoDB 存日志、Redis 做缓存、Elasticsearch 做搜索——每多一种数据库就多一份部署、监控和故障排查的成本。除非每种数据库确实解决了不同的问题,否则先用一种关系型数据库覆盖大部分需求,等性能瓶颈真正出现后再有针对性地引入。
因为"大家都在用"而选 MongoDB。MongoDB 解决的核心问题是"结构不固定的数据存储"和"水平扩展"。如果你的数据结构很清晰、表间关系明确,用关系型数据库会更省事。在关系型数据库上强行模拟文档模型,和在文档数据库上强行模拟关系模型,都会把简单的事情搞复杂。
忽视数据迁移的成本。从 SQLite 切到 PostgreSQL 相对容易,因为它们都是关系型数据库,SQL 语法差异不大,ORM 切换只需要改配置。但从 MongoDB 切到 PostgreSQL(或反过来)涉及数据模型的根本变化,迁移成本很高。所以初始选型时多花半天想清楚,比后面花两周迁移数据要划算。
在开发环境和生产环境用不同类型的数据库。常见的做法是开发时用 SQLite(方便),上线后用 PostgreSQL。如果使用 ORM 并且只用标准 SQL 特性,这种切换问题不大。但如果用了数据库特有的功能(比如 PostgreSQL 的 JSONB 查询语法),开发环境用 SQLite 就会发现测不出真实的行为。建议开发环境也用 Docker 跑一个和生产环境相同的数据库实例。
选型之后:用Python连接数据库的常用方式
确定了数据库,下一步是选择 Python 的连接方式。这里整理一个速查表:
| 数据库 | 底层驱动 | ORM / 高层工具 |
|---|---|---|
| SQLite | sqlite3(标准库) | SQLAlchemy, Django ORM, Peewee |
| PostgreSQL | psycopg2, asyncpg | SQLAlchemy, Django ORM, Tortoise ORM |
| MySQL | pymysql, mysqlclient | SQLAlchemy, Django ORM, Peewee |
| MongoDB | pymongo, motor(异步) | MongoEngine, ODMantic |
| Redis | redis-py, aioredis | django-redis, walrus |
如果你还没有偏好,推荐从 SQLAlchemy 2.0 开始。它同时支持 ORM 和 Core(直接写 SQL 表达式)两种用法,对 SQLite、PostgreSQL、MySQL 都有成熟的方言支持,社区活跃,文档齐全。Django 项目则直接用 Django 自带的 ORM 即可。
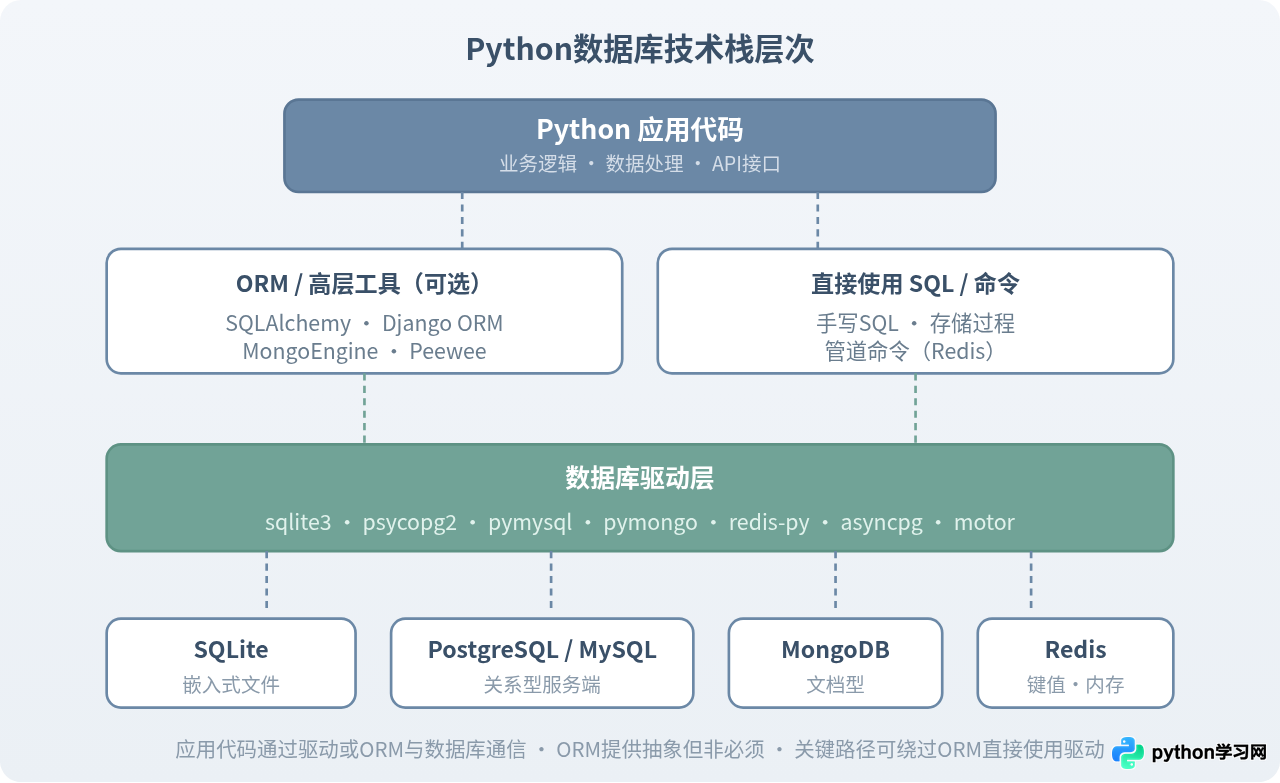
图4:Python应用到数据库的技术栈分层:应用 → ORM → 驱动 → 数据库
总结
选择数据库不需要追求"最好"的技术,而是找到与你的数据特征、项目规模、团队能力和部署环境最匹配的方案。回顾一下核心判断路径:
- 数据结构固定且有关联——关系型数据库;结构灵活——文档型;高速键值——内存数据库。
- 单机小项目选 SQLite,需要独立数据库服务时升级到 PostgreSQL 或 MySQL。
- 团队熟悉什么、部署平台提供什么,往往比功能对比表更能决定选择。
- 不要过早引入多种数据库,先用一种覆盖核心需求,等遇到真实瓶颈再扩展。
- 使用 ORM(如 SQLAlchemy 或 Django ORM)做一层抽象,后续切换数据库的成本会低很多。
如果你实在拿不定主意,对于大多数 Python Web 项目来说,PostgreSQL + Redis + SQLAlchemy(或 Django ORM)是一个经过大量实践检验的稳妥组合。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















