


DeepSeek本地部署报错怎么办?显存不足与CUDA问题修复

在本地计算机上运行 DeepSeek 这样的大语言模型,往往伴随着一种“既兴奋又焦虑”的复杂情绪。兴奋在于数据隐私完全掌握在自己手中,响应速度不再受云端排队影响;焦虑则来自那行突然跳出的红色报错代码——无论是 CUDA out of memory 还是 cuBLAS error,都像是在提醒用户:你的硬件或环境并没有准备好迎接这场算力盛宴。
很多用户在尝试部署时,容易陷入两个极端:要么盲目追求满血版模型导致显卡瞬间爆显存,要么被复杂的 Python 依赖库劝退。其实,本地部署的核心不在于拥有顶级服务器,而在于精准匹配。只要理清显存占用逻辑和环境依赖关系,大多数消费级显卡都能找到合适的运行姿势。
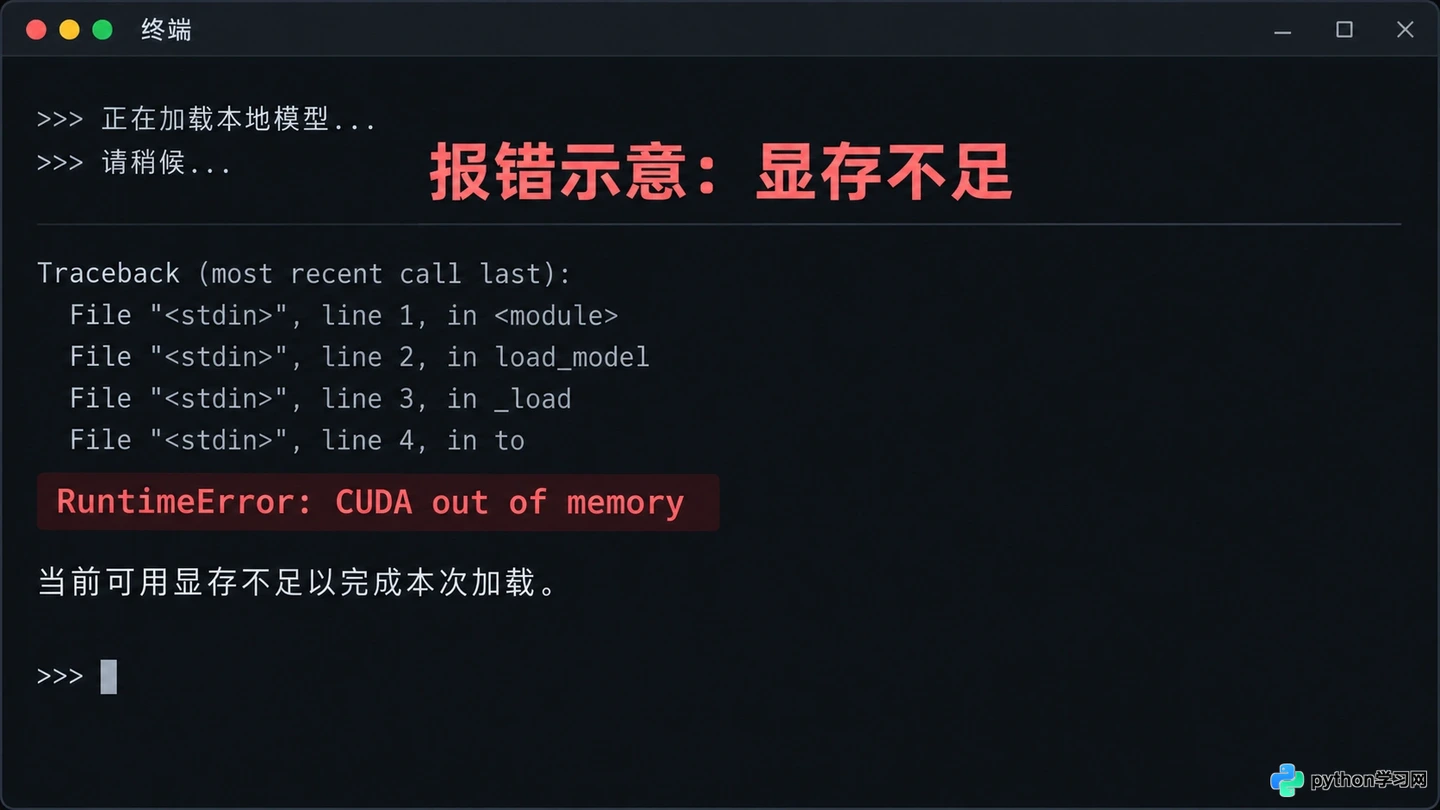
常见的显存溢出报错界面,提示用户当前显存不足以加载模型
显存溢出:从“硬扛”到“量化妥协”
当终端抛出 RuntimeError: CUDA out of memory 时,最直观的反应往往是关闭所有后台程序。但这通常治标不治本。DeepSeek 的不同版本对显存的需求差异巨大,未经量化的全精度模型(FP16)即使是 7B 参数规模,也需要约 14-16GB 显存才能流畅加载,这直接劝退了大部分 8GB 或 12GB 显存的显卡用户。
解决这一问题的关键路径是量化(Quantization)。量化通过将模型权重从高精度浮点数转换为低精度整数(如 INT4 或 INT8),在几乎不损失对话智能的前提下,大幅降低显存占用。例如,DeepSeek-R1-Distill-Qwen-7B 的 INT4 版本仅需约 5-6GB 显存即可加载,留出余量给上下文窗口(KV Cache)。
如果你使用 Ollama 进行部署,无需手动下载量化文件,只需在拉取模型时指定标签即可。例如,执行 ollama run deepseek-r1:7b-q4_K_M 会自动下载并加载 4-bit 量化版本。这种操作不仅降低了显存阈值,还提升了推理速度,因为数据传输带宽压力减小了。
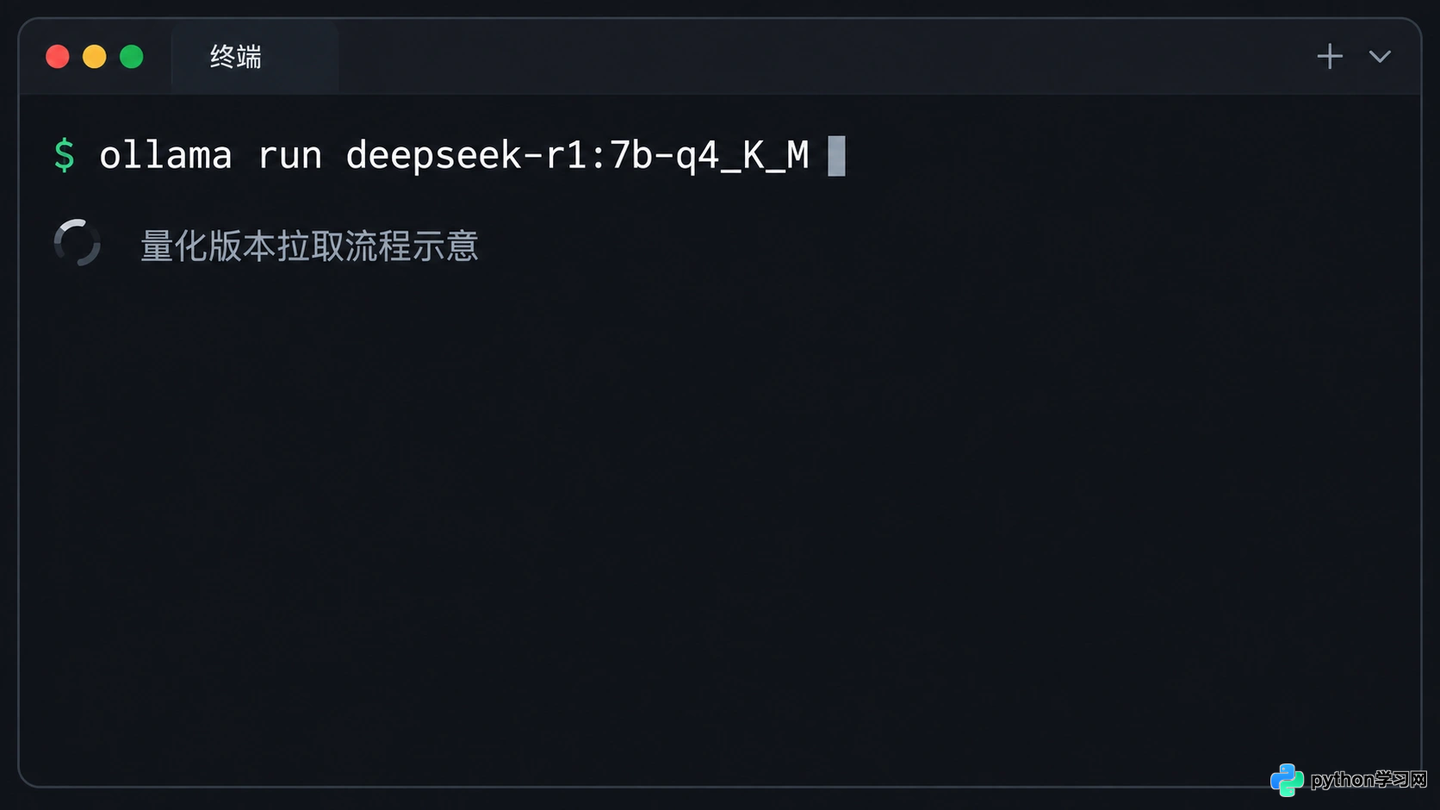
使用Ollama命令指定量化版本拉取模型,简化部署流程
对于使用 LM Studio 或 Text-Generation-WebUI 的用户,应在加载界面明确选择 Q4_K_M 或 Q5_K_M 格式的 GGUF 文件。如果依然报错,可以尝试进一步降低量化等级至 Q3_K_M,或者在启动参数中限制上下文长度(Context Length)。将上下文从默认的 32k 缩减至 4k 或 8k,能释放出数 GB 的显存空间,这对于日常问答和代码辅助已经足够。
CUDA 环境冲突:版本对齐与驱动更新
比显存不足更令人头疼的是环境依赖错误,典型的如 cuBLAS error 或 CUDA driver version is insufficient for CUDA runtime version。这类错误通常不是模型本身的问题,而是底层软件栈的“代沟”。
PyTorch 或其他深度学习框架在安装时,会绑定特定版本的 CUDA Toolkit。如果你的 NVIDIA 显卡驱动程序过旧,不支持框架所需的最低 CUDA 版本,就会直接崩溃。反之,如果驱动很新但安装的 PyTorch 是 CPU 版本或旧版 CUDA 编译的,也会无法调用 GPU。
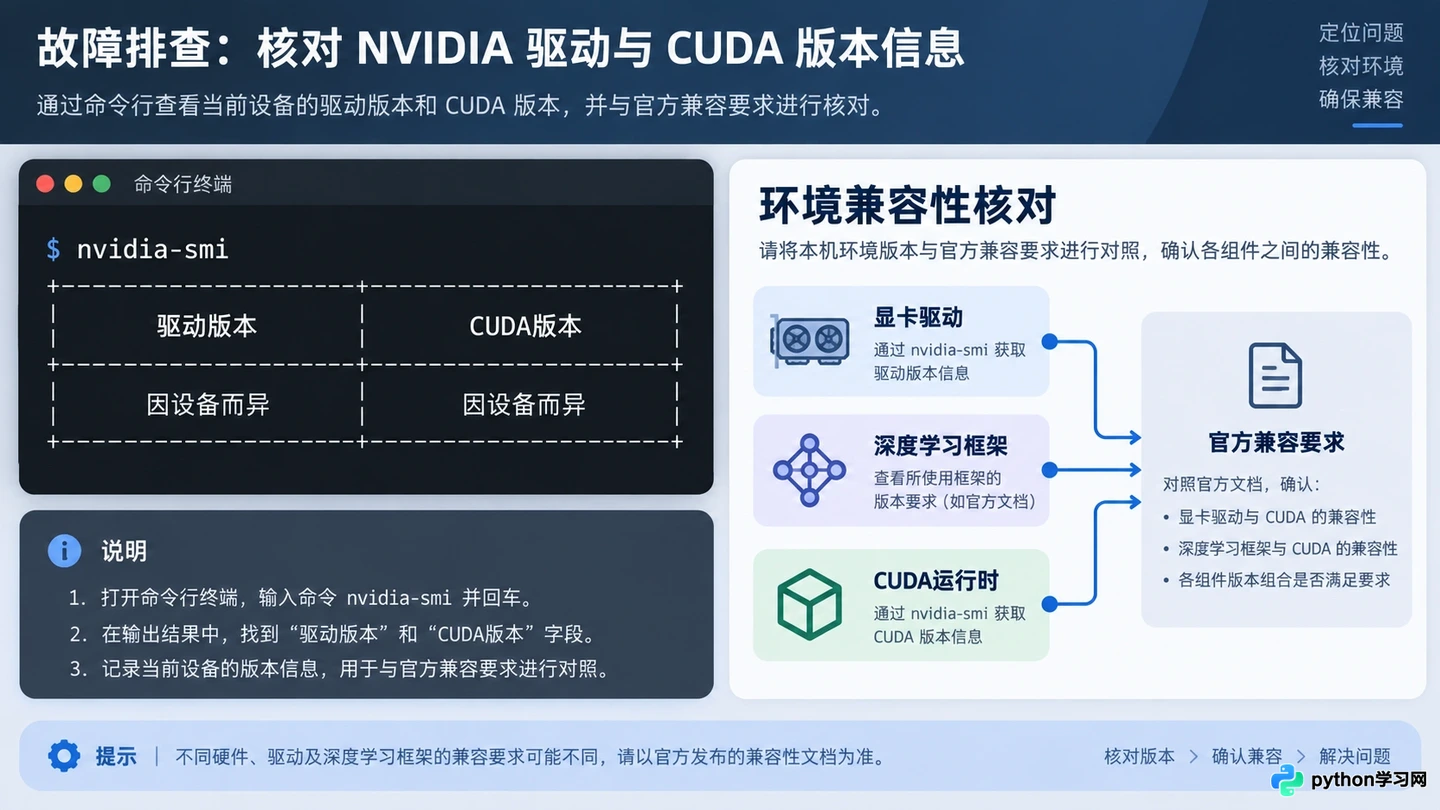
检查显卡驱动版本与CUDA运行时版本的一致性
修复的第一步是检查驱动与 CUDA 的兼容性。在命令行输入 nvidia-smi,查看右上角显示的 Driver Version 和 CUDA Version。确保你的显卡驱动支持至少 CUDA 11.8 或 12.1(目前主流 AI 框架推荐的版本)。如果驱动版本过低,请前往 NVIDIA 官网下载最新的 Game Ready 或 Studio 驱动,而非仅通过 Windows Update 更新。
第二步是确认 Python 环境的 CUDA 支持。在 Python 交互环境中运行以下代码:
import torch
print(torch.cuda.is_available())
print(torch.version.cuda)
如果输出为 False 或版本号与你安装的 PyTorch 不匹配,说明环境配置有误。此时最高效的解决方案不是手动修补依赖,而是重建虚拟环境并使用官方推荐的安装命令。例如,对于 CUDA 11.8,应使用:
pip install torch torchvision torchaudio --index-url https://download.pytorch.org/whl/cu118
切勿混用 conda 和 pip 安装核心深度学习库,这极易导致动态链接库冲突。保持环境纯净,是避免玄学报错的最好方式。
推理后端选择:Ollama 与 llama.cpp 的差异化优势
当基础环境调通后,选择合适的推理后端能进一步规避报错。许多初学者直接使用 Hugging Face Transformers 库加载模型,这种方式虽然灵活,但对内存管理和并发处理要求极高,极易因碎片化导致 OOM。
相比之下,Ollama 和 llama.cpp 采用了更底层的内存管理策略。Ollama 封装了 llama.cpp 的核心能力,自动处理模型分片、GPU 层数分配(n_gpu_layers)和内存映射。在资源受限的设备上,它会自动将部分模型层卸载到系统内存(RAM)中,虽然速度稍慢,但保证了“能跑起来”。
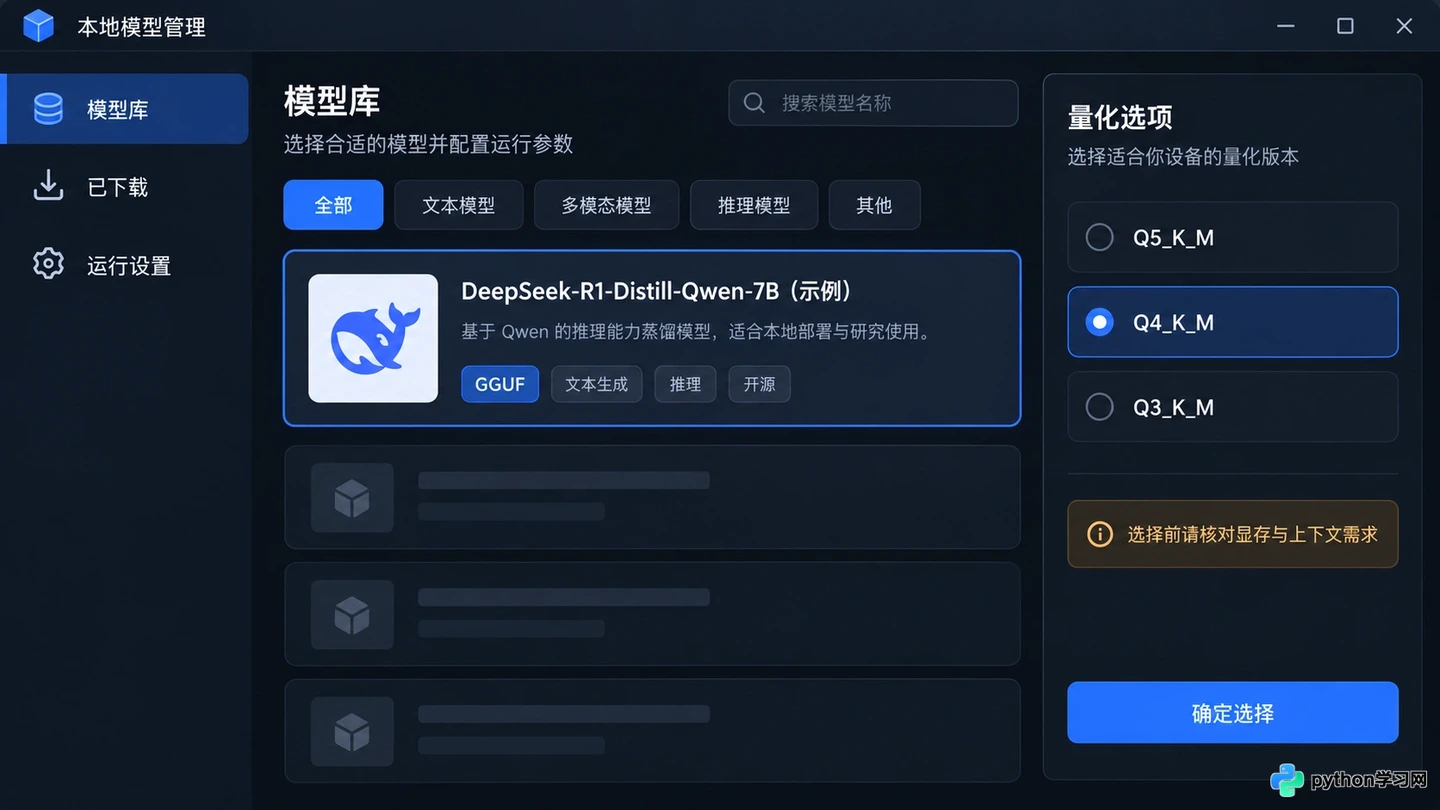
在图形化界面中选择Q4_K_M量化模型以适配显存
如果你发现 GPU 利用率极低而 CPU 满载,可能是因为默认设置未充分利用 GPU。在 Ollama 中,可以通过修改 Modelfile 增加 NUM_GPU 参数,强制更多层加载到显存中。而在 llama.cpp 的直接调用中,使用 -ngl 参数(如 -ngl 99)可以指定卸载到 GPU 的层数。对于显存刚好够用的情况,设置为最大层数能获得最佳性能;对于显存紧张的情况,适当减少该数值,让 CPU 分担部分计算,是一种以时间换空间的稳妥策略。
边界与预期:本地部署的真实体验
需要明确的是,本地部署并非万能解药。即使解决了所有报错,消费级显卡在生成速度上仍无法与云端集群相比。DeepSeek-R1 等包含复杂推理链的模型,在首字延迟(TTFT)和生成吞吐量上,会受到显卡算力的物理限制。
此外,量化带来的精度损失虽然在通用对话中难以察觉,但在极端的数学推导或代码调试场景中,可能会出现逻辑跳跃。因此,不要指望本地小参数量化模型能完全替代云端超大模型,它更适合用于隐私敏感数据的预处理、日常知识检索和轻量级创作辅助。
成功运行DeepSeek模型后的流畅对话体验
回到最初的取舍:本地部署的价值在于可控性与隐私安全,而非极致性能。当你不再纠结于每一秒的生成速度,而是享受数据不出本地、随时可调用的自由时,那些曾经令人焦虑的报错代码,就变成了理解计算机底层运作的一次次有趣调试。对于大多数用户而言,选择一个成熟的工具链(如 Ollama),配合适当的量化模型,足以跨越技术门槛,让 AI 真正融入本地工作流。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















