


Python怎么使用NumPy和Pandas批量对数据取整

np.round()、np.floor()、np.ceil() 和 np.trunc() 四类核心算子,能直接作用于多维数组;Pandas 既支持针对 DataFrame 和 Series 的 .round() 链式调用(支持按列指定精度),也可以无缝接收 NumPy 算子进行快速批量计算。
一、为什么批量取整必须放弃原生循环
当数据规模达到几十万甚至千万行时,使用 Python 原生内置的 round() 结合列表推导式或 for 循环,会面临严重的解释器性能瓶颈。每次循环都需要在动态类型解析、对象封装与内存解引用上耗费大量时间。
NumPy 与 Pandas 采用 C 语言级别连续内存块组织数据,通过单指令流多数据流(SIMD)与预编译循环直接在底层操作整块内存。执行相同的取整任务,向量化方式通常比 Python 原生循环快数十倍乃至上百倍。
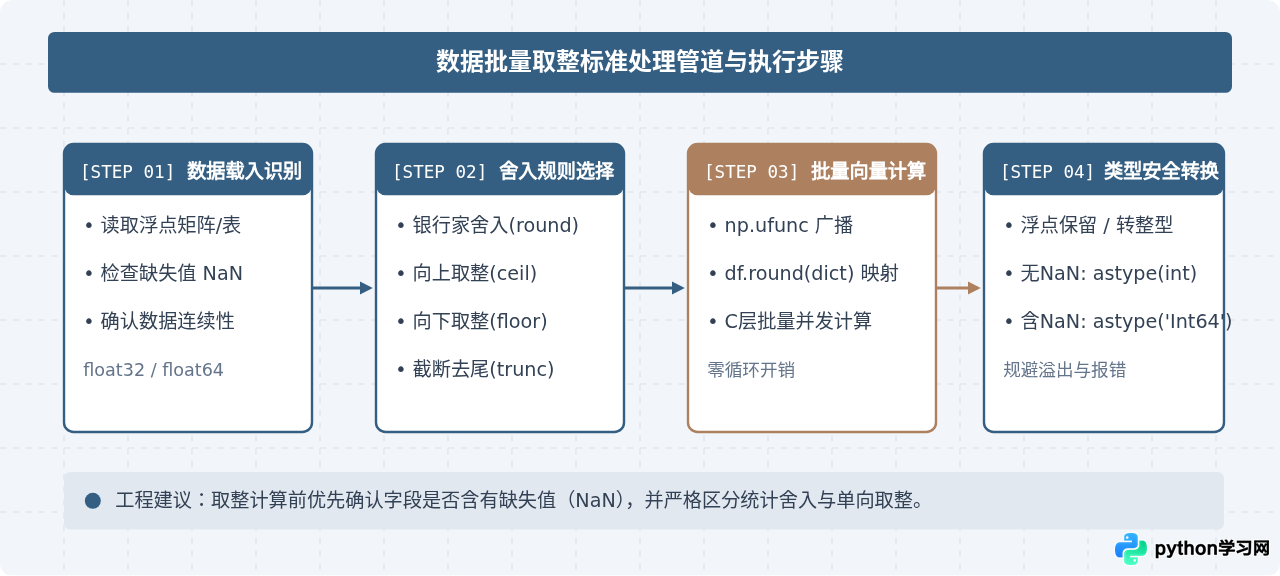
二、NumPy 批量取整的四种核心函数
NumPy 提供了一组以通用函数(ufunc)形式实现的取整算子。无论输入是一维数组还是高维张量,都可以直接传入函数,得到形状完全相同的取整后数组。
1. np.round():四舍六入五成双(银行家舍入法)
np.round() 或 np.around() 是最常用的取整方法。它接收参数 decimals 控制保留的小数位数,默认值为 0(即取整到整数位)。
import numpy as np

arr = np.array([1.5, 2.5, 3.5, 4.5, -1.5, -2.5])

# 取整到整数位(返回仍为浮点类型)
rounded = np.round(arr)
print("np.round 结果:", rounded)
# 示例输出: [ 2.  2.  4.  4. -2. -2.]

# 保留 1 位小数
arr_float = np.array([1.234, 1.256, 1.250])
print("保留1位小数:", np.round(arr_float, decimals=1))
# 示例输出: [1.2 1.3 1.2]
2. np.floor():向下取整(朝负无穷方向靠拢)
np.floor() 返回不大于输入值的最大整数。对于正数而言类似于抹去小数,但对于负数而言,它会向更小的负数方向推进。
arr = np.array([2.1, 2.9, -2.1, -2.9])
print("np.floor 结果:", np.floor(arr))
# 示例输出: [ 2.  2. -3. -3.]
3. np.ceil():向上取整(朝正无穷方向靠拢)
np.ceil() 返回不小于输入值的最小整数。常用于需要向上拉平配额、计算批次页数或包装箱数的业务场景。
arr = np.array([2.1, 2.9, -2.1, -2.9])
print("np.ceil 结果:", np.ceil(arr))
# 示例输出: [ 3.  3. -2. -2.]
4. np.trunc():向零截断取整(直接丢弃小数)
np.trunc()(或 np.fix())直接丢弃所有小数位,正数向小取整,负数向大取整,统一向 0 靠拢。
arr = np.array([2.9, -2.9, 0.7, -0.7])
print("np.trunc 结果:", np.trunc(arr))
# 示例输出: [ 2. -2.  0. -0.]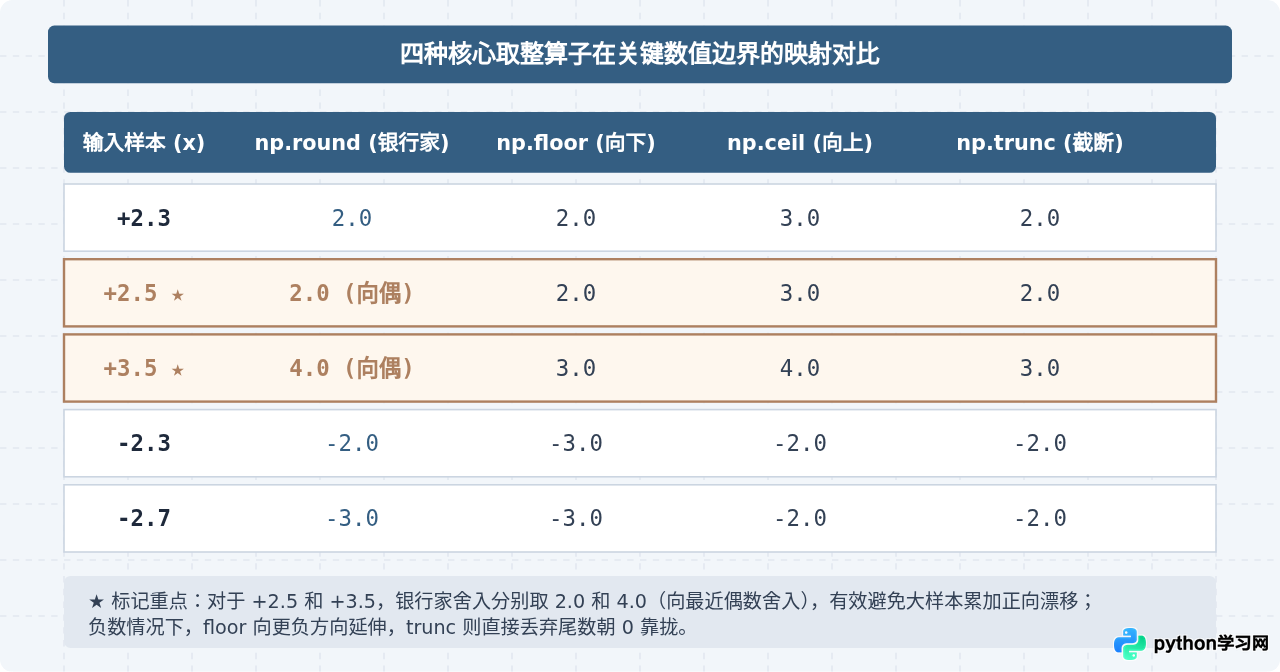
三、Pandas 表格数据的批量取整方法
在结构化表格分析中,数据通常封装在 pd.Series 或 pd.DataFrame 中。Pandas 不仅原生提供了方便易用的 .round() 方法,还能与 NumPy 的通用函数深度协同。
1. 全表与单列批量四舍五入
调用 df.round(decimals) 会将整个表格的所有浮点数值列批量舍入;如果传入字典,则可以为不同的列设定完全不同的保留位数:
import pandas as pd
import numpy as np

df = pd.DataFrame({
    'item_id': [101, 102, 103],
    'price': [19.256, 45.824, 88.500],
    'weight': [1.2854, 2.7631, 0.9999],
    'score': [4.5, 3.5, 2.5]
})

# 1. 全表统一保留 2 位小数
df_all_rounded = df.round(2)

# 2. 差异化批量配置:price 保留2位,weight 保留3位,score 取整
precision_map = {
    'price': 2,
    'weight': 3,
    'score': 0
}
df_custom = df.round(precision_map)
print(df_custom)
# 示例输出:
#    item_id  price  weight  score
# 0      101  19.26   1.285    4.0
# 1      102  45.82   2.763    4.0
# 2      103  88.50   1.000    2.0
2. 在 Pandas 中应用 floor、ceil 与 trunc
由于 Pandas 自身并没有直接提供 df.floor() 或 df.ceil() 方法,很多初学者会错误地使用 .apply(np.floor)。这种做法会在 Python 层面产生迭代封装,损失性能。
正确的高效做法是:直接将 DataFrame 或 Series 作为参数传给 NumPy 函数。NumPy 的通用函数天然支持 Pandas 对象,并会在计算完成后保留原有的 Index 和 Column 结构:
# 针对单列高效向上取整
df['box_needed'] = np.ceil(df['weight'])

# 针对指定的多列执行向下取整
target_cols = ['price', 'weight']
df[target_cols] = np.floor(df[target_cols])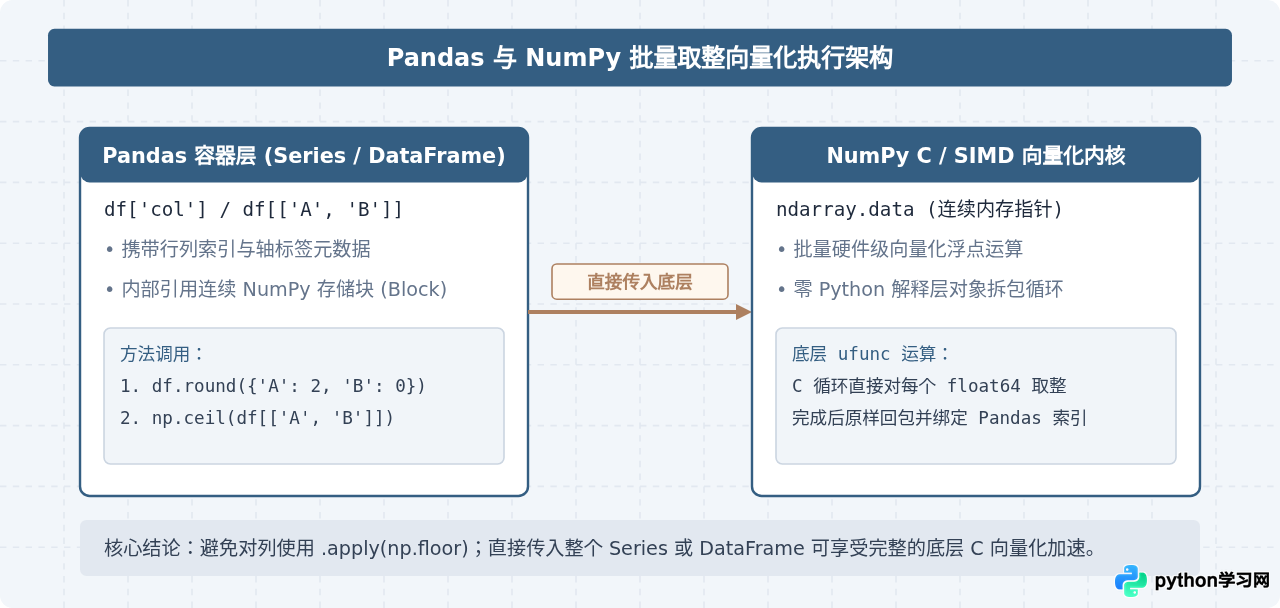
四、关键细节与类型转换陷阱
1. 为什么取整后依然是 float64 浮点型?
无论是使用 np.round()、np.floor() 还是 df.round(),返回的数据类型依然是浮点数(例如 float64),即输出为 2.0 而不是整数 2。这是因为取整运算只改变数值大小,不改变数据类型;此外,若保留了小数位(如 decimals=2),本身就必须保持浮点类型。
2. 包含缺失值(NaN)时的整型转换报错
如果业务最终需要纯整数类型(如商品件数、用户数量),需要调用 .astype() 进行类型转换。但这里存在一个常见陷阱:标准整型(int32/int64)不支持 NaN(缺失值)。
如果数据列中存在 NaN,直接执行 df['col'].astype(int) 会抛出经典错误:ValueError: Cannot convert non-finite values (NA or inf) to integer。
import pandas as pd
import numpy as np

s = pd.Series([1.7, 2.3, np.nan, 4.8])

# 1. 批量取整(结果仍是浮点,保留 NaN)
s_rounded = np.floor(s)
# 0    1.0
# 1    2.0
# 2    NaN
# 3    4.0

# 2. 错误做法:直接转为标准 int,若含 NaN 会报错
# s_rounded.astype(int)  # 抛出 ValueError!

# 3. 正确方案 A:填充缺失值后再转为标准整数
s_filled = s_rounded.fillna(0).astype(int)

# 4. 正确方案 B:使用 Pandas 可空整数类型 'Int64'(大写 I)
s_nullable_int = s_rounded.astype('Int64')
print(s_nullable_int)
# 示例输出:
# 0       1
# 1       2
# 2    <NA>
# 3       4
# dtype: Int64
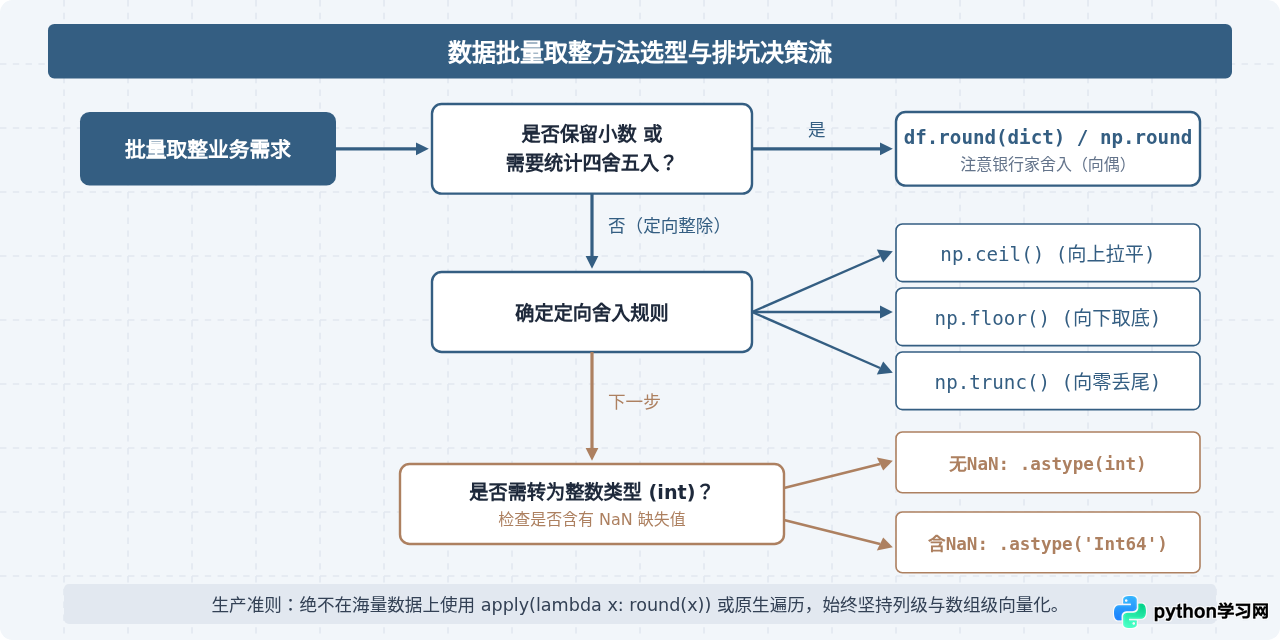
五、工程场景选型与总结决策树
在实际生产环境中,面对不同业务诉求,如何快速选定最佳的取整与转换路径?可通过以下决策流程进行判断:
六、总结与速查清单
| 任务需求 | 推荐使用方式 | 性能与边界注意事项 |
|---|---|---|
| DataFrame 多列不同精度四舍五入 | df.round({'col1': 2, 'col2': 0}) |
基于 C 层连续广播,遵循银行家舍入,支持指定列映射字典。 |
| 数组/列 向上对齐取整 | np.ceil(df['col']) |
直接传入 Series 或 ndarray,保留原有索引;结果依然是浮点型。 |
| 数组/列 向下底线取整 | np.floor(df['col']) |
负数会向更小的负数推进(如 -2.1 变为 -3.0)。 |
| 正负数直接丢弃小数 | np.trunc(df['col']) |
向 0 方向截断(-2.9 变为 -2.0,2.9 变为 2.0)。 |
| 取整后输出包含空值的整数列 | np.floor(s).astype('Int64') |
必须使用大写 'Int64' 可空扩展类型,避免 ValueError。 |
掌握以上 NumPy 与 Pandas 的原生向量化方法,不仅能规避海量数据下的运行性能瓶颈,还能在面对浮点舍入偏差与缺失值异常时保持代码的稳健与严谨。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















