


Python和Java在并发处理上的差异:多线程与GIL限制
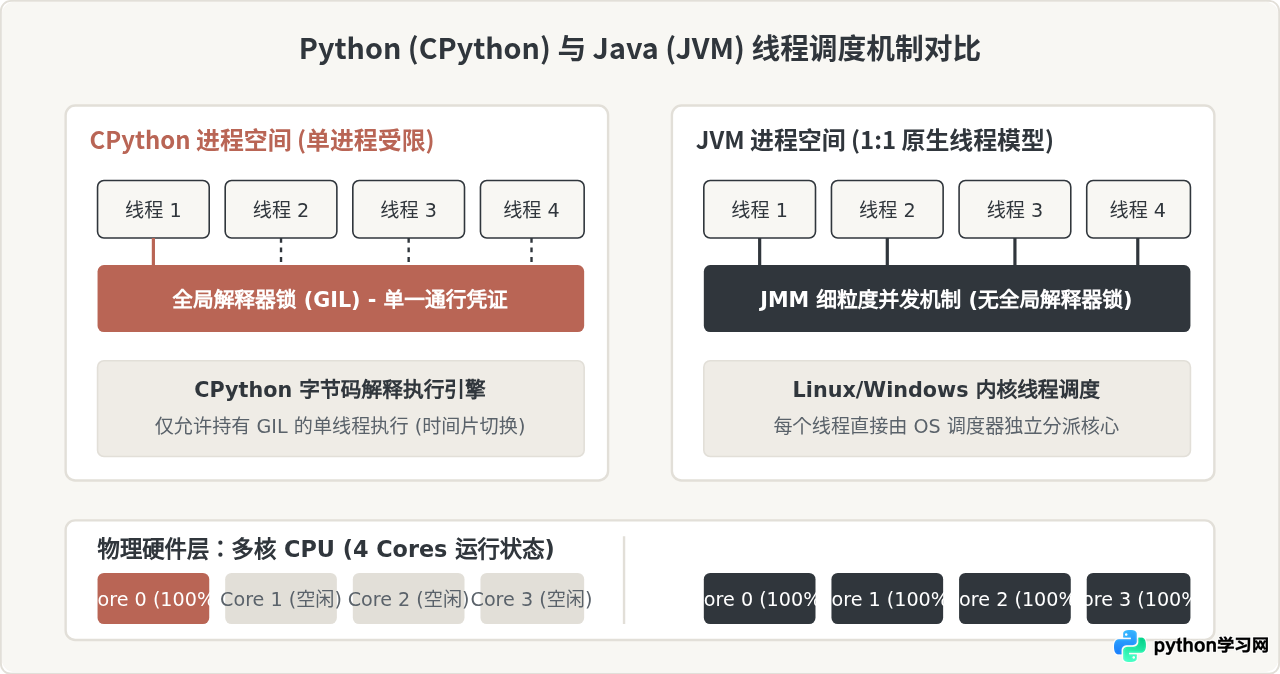
Python与Java在并发编程能力上的根本差异,直接源于两者的底层执行模型与线程调度机制:Java的多线程由JVM直接映射为操作系统的原生内核线程,能够原生在多核CPU上实现真正的物理并行计算;而主流Python实现(CPython)中存在全局解释器锁(GIL,Global Interpreter Lock),同一时刻仅允许一个线程执行字节码,导致Python多线程无法利用多核心加速计算密集型任务。理解这一差异,是为不同业务场景选型高并发架构的基础。
一、核心机制:操作系统线程映射与GIL的存在意义
多线程在概念上都代表程序中的并发执行流,但进入底层操作系统与虚拟机层面时,Python与Java的处理逻辑完全分化。
Java在早期(Java 1.2之前)曾使用称为“绿色线程(Green Threads)”的由JVM自行调度的用户态线程。自Java 1.3起,主流JVM(如HotSpot)全面转向1:1线程模型:每当在Java代码中创建一个java.lang.Thread实例并启动时,JVM都会通过操作系统系统调用(在Linux上是clone()生成原生LWP轻量级进程)创建对应的OS线程。操作系统内核调度器负责分配CPU时间片,若机器拥有8个物理核心,8个活跃的Java计算线程就能同时分别运行在8个核心上,实现100%的物理多核利用率。
与之相反,标准Python解释器(CPython)虽然在调用threading.Thread时同样创建了真实的操作系统内核线程,但在解释器进程内部设置了一道全局互斥锁——GIL。CPython采用基于引用计数的内存垃圾回收机制,为了保证多线程下对象引用计数增减、内部字典结构及C扩展接口的内存安全,CPython通过GIL强制规定:同一进程内,任意时刻只能有一个线程持有GIL并执行Python字节码。即使操作系统将多个Python线程唤醒,只要它们没有拿到GIL,就只能处于等待状态。
二、CPU密集型场景:多线程运行表现与代码实证
为了直观说明差异,我们以大范围整数累加或哈希运算等典型的CPU密集型任务为例。在这类任务中,CPU核心持续进行算术运算,几乎不涉及网络或磁盘等系统调用。
1. Python在CPU密集型任务下的行为
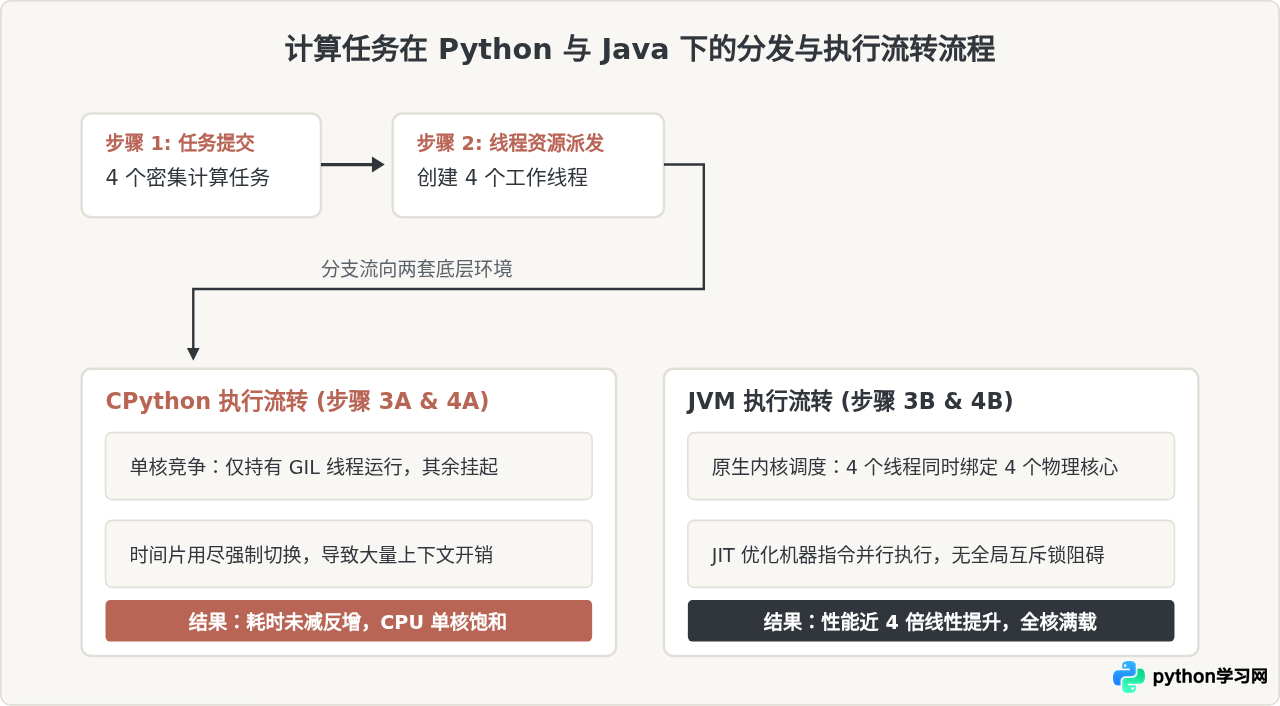
如果启动4个Python线程共同分担计算量,这4个线程会频繁竞争同一个GIL。由于Python设置了线程执行字节码的步数或时间片阈值(sys.getswitchinterval(),默认5毫秒),线程在时间片用尽后会被强制释放锁并唤醒其他线程。这导致大量的时间被消耗在操作系统线程挂起、唤醒及GIL争抢的上下文切换开销上。结果是:Python多线程处理CPU密集型任务不仅无法提速,总耗时通常比单线程还要慢。
# Python: 线程池与进程池对比计算密集型任务
import time
from concurrent.futures import ThreadPoolExecutor, ProcessPoolExecutor

def cpu_heavy_work(n):
    count = 0
    for i in range(n):
        count += i
    return count

if __name__ == "__main__":
    nums = [30000000] * 4

    # 1. 单线程顺序执行
    start = time.perf_counter()
    res1 = [cpu_heavy_work(n) for n in nums]
    print(f"单线程耗时: {time.perf_counter() - start:.2f} 秒")

    # 2. 多线程执行 (受制于 GIL,耗时往往增加)
    start = time.perf_counter()
    with ThreadPoolExecutor(max_workers=4) as executor:
        res2 = list(executor.map(cpu_heavy_work, nums))
    print(f"4线程耗时: {time.perf_counter() - start:.2f} 秒")

    # 3. 多进程执行 (绕过 GIL,利用全部多核)
    start = time.perf_counter()
    with ProcessPoolExecutor(max_workers=4) as executor:
        res3 = list(executor.map(cpu_heavy_work, nums))
    print(f"4进程耗时: {time.perf_counter() - start:.2f} 秒")
2. Java在CPU密集型任务下的行为
Java通过java.util.concurrent.Executors创建固定大小的线程池,启动与CPU物理核心数相当的工作线程。操作系统将每个工作线程直接分派给独立的CPU核心,每个核心独立运行JIT编译优化后的机器码,线程之间互不干扰,几乎没有争抢与额外开销,加速比接近线性的核心倍数。
// Java: 固定线程池处理计算密集型任务
import java.util.List;
import java.util.ArrayList;
import java.util.concurrent.*;

public class CpuConcurrencyDemo {
    private static long cpuHeavyWork(long n) {
        long count = 0;
        for (long i = 0; i < n; i++) {
            count += i;
        }
        return count;
    }

    public static void main(String[] args) throws Exception {
        int tasks = 4;
        long target = 30000000L;
        ExecutorService pool = Executors.newFixedThreadPool(tasks);

        long start = System.currentTimeMillis();
        List<Future<Long>> futures = new ArrayList<>();
        for (int i = 0; i < tasks; i++) {
            futures.add(pool.submit(() -> cpuHeavyWork(target)));
        }

        for (Future<Long> f : futures) {
            f.get();
        }
        pool.shutdown();
        System.out.println("Java 4线程并发耗时: " + (System.currentTimeMillis() - start) + " 毫秒");
    }
}
三、I/O密集型场景:GIL释放与高并发吞吐
虽然GIL限制了CPU密集型多线程,但在网络请求、文件读写、数据库操作等I/O密集型任务中,Python多线程依然具有极其实用的价值。
1. Python在I/O阻塞中的自动释放机制
当Python线程发起阻塞式I/O操作(例如调用socket.recv()、requests.get()或time.sleep())时,CPython在进入操作系统系统调用前,会主动释放GIL;等到操作系统返回I/O数据后,该线程再重新尝试竞争获取GIL以继续处理数据。因此,当线程A在等待网络响应时,线程B、C、D可以正常获取GIL并在CPU上执行准备代码。在大量I/O等待的场景下,Python的多线程模型能够有效隐藏I/O延迟。
2. Java传统线程池与现代虚拟线程(Virtual Threads)
Java在I/O密集型任务中历来依靠线程池(如Tomcat默认200线程模型)。然而传统OS线程占用内存较大(通常每个线程栈预分配1MB内存),操作系统内核调度数十万个OS线程时上下文切换开销极高。为此,Java 21正式引入了虚拟线程(Project Loom)。虚拟线程属于用户态轻量级执行流,由JVM调度挂载到少量物理“载体线程(Carrier Threads)”上。当虚拟线程遇到网络I/O阻塞时,JVM自动将其从载体线程上卸载(Park),载体线程立即转去执行其他虚拟线程,从而以极低内存开销轻松支撑百万级并发连接。
注意: Python应对极高并发网络I/O的现代方案通常不是多线程,而是基于事件驱动的单线程异步框架 asyncio。在单线程中使用 async/await 避免了线程切换与锁竞争,单机吞吐表现优异。
四、绕过限制与并发选型演进路径
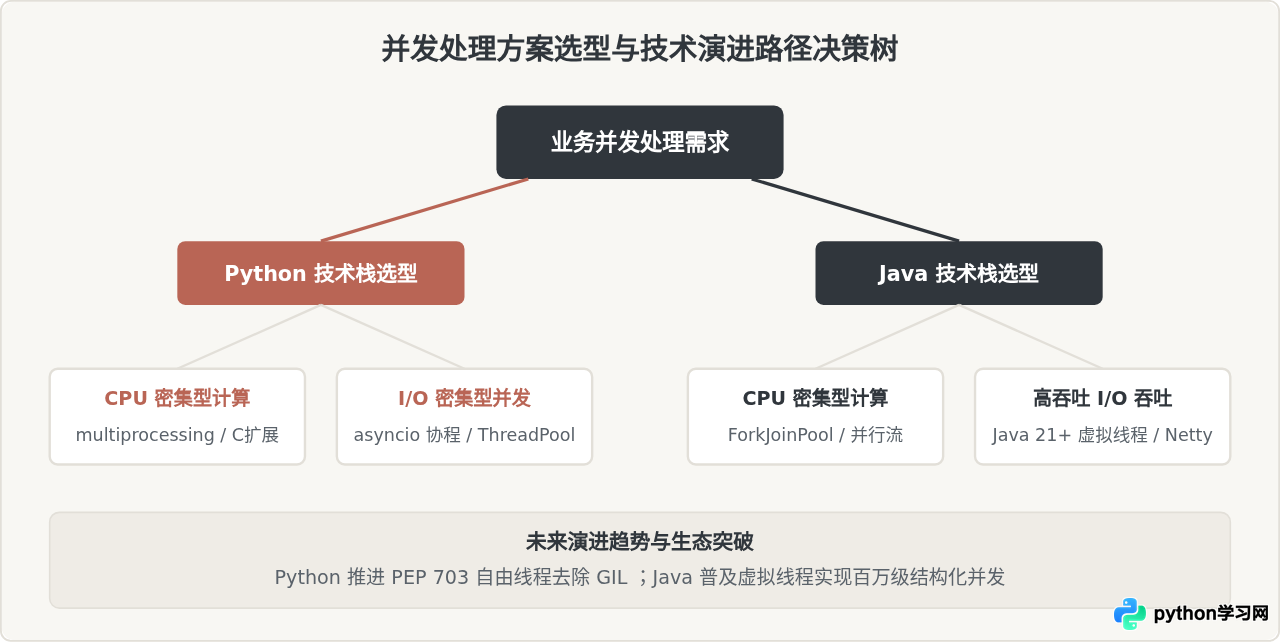
针对两门语言不同的并发短板,工程界已经发展出成熟的演化路径与解决模式:
- Python解决多核算力问题:
- 多进程模式(multiprocessing): 创建独立的Python子进程,每个进程拥有独立的内存空间和独立的GIL,从而能够占满多核。代价是跨进程数据需要进行Pickle序列化,存在IPC开销。
- C/C++/Rust 扩展: 将高负荷计算逻辑用Cython、C++扩展或Rust(PyO3)实现,在底层C代码块中使用宏
Py_BEGIN_ALLOW_THREADS显式释放GIL,执行完毕后再重新申请GIL。NumPy、PyTorch即是利用此机制在多核CPU和GPU上发挥极致算力。 - Python 3.13 自由线程模式(Free-threaded / PEP 703): Python官方正在推进移除GIL的工作。在Python 3.13中提供了实验性的无GIL构建版本,通过在对象层引入更细粒度的同步机制逐步实现真正多线程并行。
- Java降低I/O开销并简化编程:
- 线程池分级管理: 通过
ForkJoinPool和ThreadPoolExecutor区分处理CPU密集任务(线程数 ≈ CPU核心数)与I/O密集任务(线程数较多)。 - 虚拟线程直接替代: 采用
Executors.newVirtualThreadPerTaskExecutor()编写直观的同步阻塞风格代码,底层却具备极高吞吐。
- 线程池分级管理: 通过
五、核心维度对比与架构总结
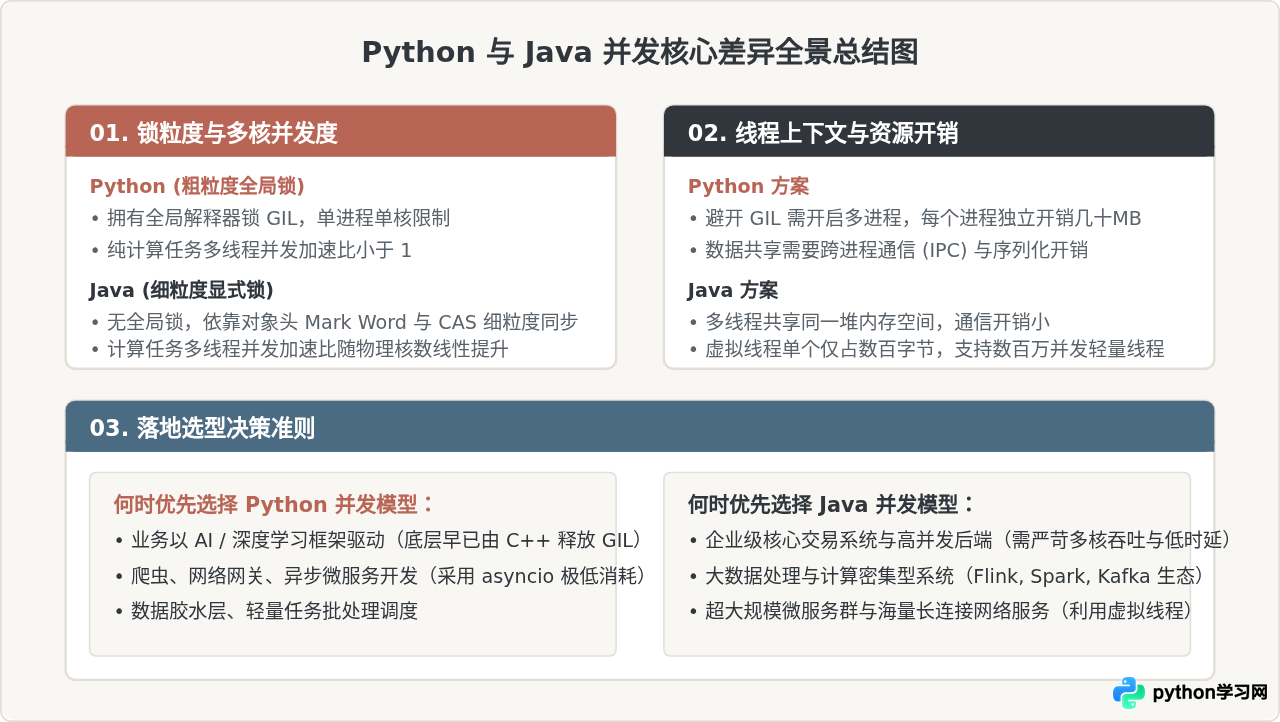
为了让不同场景下的选型更加明确,下表总结了Python与Java在并发编程各维度的关键特性对比:
| 对比维度 | Python (以 CPython 为基准) | Java (以 HotSpot JVM 为基准) |
|---|---|---|
| 底层线程模型 | 映射为OS原生线程,但受GIL互斥锁约束 | 1:1 映射为OS原生线程(Java 21+ 增加虚拟线程) |
| 多线程CPU利用率 | 单进程仅能占满 1 个CPU核心 | 可无限制充分利用机器所有物理CPU核心 |
| I/O密集型表现 | 遇到系统调用主动释放GIL,多线程有效 | 传统线程池稳定强劲,虚拟线程带来极高并发量 |
| 并发安全防护 | GIL保障底层内存安全,应用层仍需Lock防护竞态 | 依靠JMM规范,通过synchronized、ReentrantLock等机制保证 |
| 典型多核方案 | 多进程 (multiprocessing) 或 C/Rust 原生扩展 | 原生多线程 (ThreadPoolExecutor / ForkJoinPool) |
| 编程模型心智负担 | CPU计算需换多进程,异步I/O需用async/await | 传统多线程需注意线程安全;虚拟线程保持同步写法 |
结语
Python与Java在并发上的差异并非简单的优劣之分,而是两门语言在设计哲学和权衡取舍上的具象体现。CPython通过GIL换取了单线程极高的运行效率和极为简便的C语言扩展接入能力,为如今Python在数据科学与AI领域的繁荣奠定了基石;而Java从诞生之初便瞄准企业级大规模并发场景,以完善的JMM内存模型与原生OS线程支持,构建了支撑现代互联网后端坚不可摧的算力基石。在架构设计中,认清GIL在CPU与I/O场景下的行为边界,结合多进程、异步协程或JVM多线程各自的优势,才能做出最优的技术决策。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















