


Python列表与字典实战:通过数据清洗案例掌握核心数据结构
很多初学者掌握了列表的增删切片,也记住了字典的键值对定义,但在遇到接口返回的原始数据或导出的日志时,依然不知道如何把两种结构顺畅组合起来。真实业务场景中极少有纯粹的孤立数据,最常见的数据载体是由字典组成的列表(List[Dict])。本文将以一份包含字段缺失、空格污染、类型错乱和重复项的电商订单数据为切入点,通过构建四步清洗流水线,拆解列表与字典的核心分工、协作技巧与避坑要点,让你写出干净、高效且不容易崩溃的数据处理代码。
一、分工基石:列表与字典在数据处理中的职责划分
在编写处理脚本前,需要明确列表和字典各自不可替代的特性。列表是有序序列,主要职责是充当流水线容器,管理整批数据的顺序、追加与批量迭代;字典则是哈希映射表,负责表达单个实体的各项属性,并在需要快速定位字段时提供 O(1) 的查询效率。
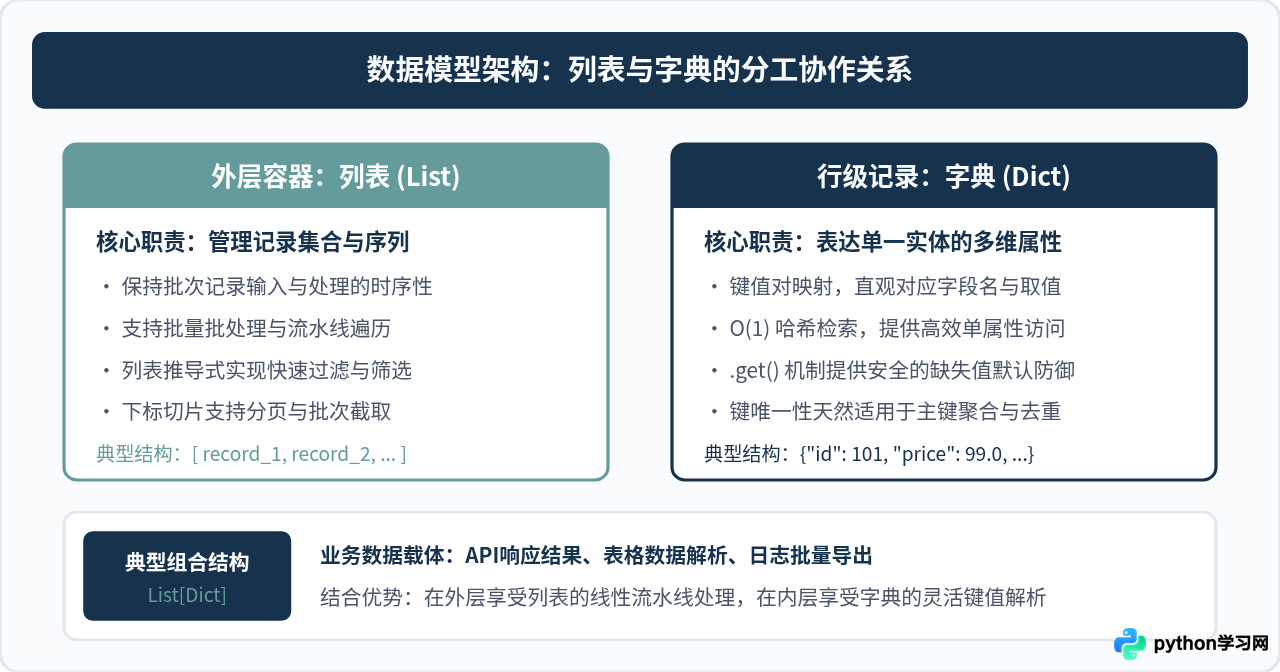
当我们要批量处理数百甚至数万条记录时,外层的列表负责提供迭代遍历的骨架,内层的字典负责承载一条数据的所有细节。如果把整批数据比作一张表格,外层列表就是行数的集合,内层字典就是每一行中由列名索引的单元格。
二、案例场景:一份典型的脏数据样本
在真实开发中,从非关系型数据库导出的数据或上游服务同步的订单往往存在各种不规范之处。下面是一份典型的待清洗列表,其中包含 5 条原始订单数据:
# 原始输入数据:存在大小写混乱、前后空格、类型错误、字段缺失和重复订单
raw_orders = [
    {
        "order_id": "ORD-1001",
        "user_email": "  Alice@EXAMPLE.COM ",
        "amount": "128.50",
        "status": "PAID"
    },
    {
        "order_id": "ORD-1002",
        "user_email": "bob@example.com",
        "amount": "99.00",
        # 缺失 status 键
    },
    {
        "order_id": "ORD-1001",  # 与第一条 ID 重复
        "user_email": "alice@example.com",
        "amount": 128.50,        # 已经是浮点数
        "status": "PAID"
    },
    {
        "order_id": "ORD-1003",
        "user_email": "charlie@test.com",
        "amount": "-50.00",      # 异常负数金额
        "status": "REFUNDED"
    },
    {
        "order_id": "ORD-1004",
        "user_email": "  DAVID@domain.org",
        "amount": "340.20",
        "status": "delivered"   # 小写状态
    }
]
通过检查这段数据,我们梳理出四个必须解决的具体问题:
- 字典键缺失:第 2 条记录缺少
status键,直接通过下标取值item["status"]会直接抛出KeyError异常中断程序。 - 格式不规范:邮箱两端存在多余空格且包含大写字母;订单状态存在大写和小写混合情况。
- 类型不一致与异常值:金额字段有的是字符串(如
"128.50"),有的是数字,甚至存在非法的负数金额。 - 重复订单:存在相同的
order_id,需要按规则合并或去重。
三、实战拆解:四步流水线清洗数据
针对上述问题,我们设计一套规范的数据清洗流水线。处理过程不建议直接在原列表上原地修改,而应当遵循“输入 - 规整 - 过滤 - 输出”的阶段式推进。
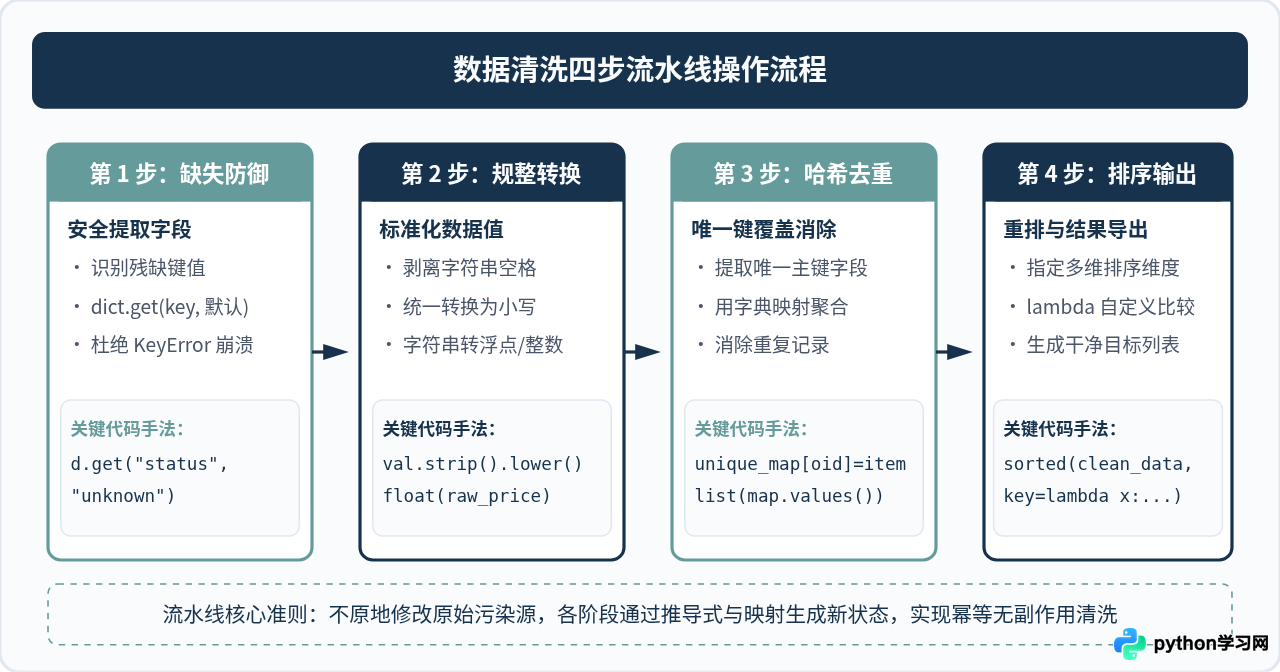
步骤 1:利用字典的 .get() 建立缺失值防御
处理外部传入的字典时,最忌讳直接使用 record["key"] 取值。一旦上游接口改版或者网络丢包导致字段丢失,整个清洗任务就会立刻挂掉。正确的方式是使用 dict.get(key, default),并在业务上给一个合理的默认值:
# 传统硬编码取值:风险极高
# status = order["status"]  # 若没有 status,直接抛出 KeyError

# 防御性取值:安全可靠
status = order.get("status", "PENDING").upper()
步骤 2:字段清洗与合法性过滤
我们需要将邮箱剥离首尾空格并转为纯小写,将金额转换为标准浮点数,同时过滤掉金额小于等于 0 的脏记录。这里使用单个记录的处理函数配合列表推导式,不仅逻辑清晰,而且执行效率高:
def sanitize_order(order: dict) -> dict:
    """清洗单条字典记录,返回规整后的新字典"""
    raw_amount = order.get("amount", 0.0)
    try:
        clean_amount = round(float(raw_amount), 2)
    except (ValueError, TypeError):
        clean_amount = 0.0

    return {
        "order_id": str(order.get("order_id", "")).strip(),
        "user_email": str(order.get("user_email", "")).strip().lower(),
        "amount": clean_amount,
        "status": str(order.get("status", "PENDING")).strip().upper()
    }

# 过滤并规整:使用列表推导式过滤无效金额
sanitized_list = [
    sanitize_order(item)
    for item in raw_orders
    if sanitize_order(item)["amount"] > 0
]
步骤 3:借用字典键的唯一性进行极速去重
列表去重很多初学者喜欢写双重循环:if item not in result: result.append(item)。这种做法在数据量达到数万条时会变极其缓慢(时间复杂度为 O(N²))。
由于字典的底层是哈希表,字典的键天然具有唯一性且查找时间复杂度为 O(1)。我们可以把去重依据(如 order_id)作为字典的键,将清洗后的对象作为值存入字典。如果后出现的记录有更丰富的信息,直接覆盖或者保留第一条:
# 使用临时字典按 order_id 去重(时间复杂度 O(N))
dedup_dict = {}
for item in sanitized_list:
    oid = item["order_id"]
    # 如果已经存在,可以根据业务需求选择保留或覆盖,此处保留最后一条最新记录
    dedup_dict[oid] = item

# 从字典的值中重新提取出干净列表
deduped_orders = list(dedup_dict.values())
步骤 4:根据业务指标进行重排与最终封装
得到去重后的数据后,业务通常需要按照某种规则展示。比如:按照订单金额从高到低倒序排列。Python 列表提供了内置的 sorted() 函数,配合 lambda 可以非常优雅地按字典中的某个字段排序:
# 按照订单金额倒序排序
final_clean_orders = sorted(
    deduped_orders,
    key=lambda record: record["amount"],
    reverse=True
)
完整清洗执行脚本与输出
把上述四个步骤组合起来,就形成了一个完整可运行的数据清洗模块:
def clean_order_pipeline(orders: list) -> list:
    """执行完整的订单数据清洗流程"""
    cleaned_map = {}

    for raw in orders:
        # 1. 字段安全提取与默认值
        oid = str(raw.get("order_id", "")).strip()
        if not oid:
            continue

        # 2. 金额类型转换与合法性检查
        try:
            amt = round(float(raw.get("amount", 0)), 2)
        except (ValueError, TypeError):
            continue

        if amt <= 0:
            continue

        # 3. 构造干净的单个实体记录
        clean_record = {
            "order_id": oid,
            "user_email": str(raw.get("user_email", "")).strip().lower(),
            "amount": amt,
            "status": str(raw.get("status", "PENDING")).strip().upper()
        }

        # 4. 利用字典键去重
        cleaned_map[oid] = clean_record

    # 5. 排序并转为最终列表
    return sorted(cleaned_map.values(), key=lambda x: x["amount"], reverse=True)

# 执行清洗
result = clean_order_pipeline(raw_orders)可以看到,输入中的 5 条记录经过清洗后只保留了 3 条有效记录:ORD-1003 因负数金额被自动剔除;ORD-1001 重复项被安全合并去重;缺失 status 的 ORD-1002 被自动补全了默认的 PENDING 状态,大小写和多余空格被全部规整,最终数据按照金额由高到低整齐排列。
四、避坑指南:初学者高频犯的 3 个操作陷阱
在实际编码中,很多隐蔽的 bug 都源于对列表和字典的内部行为理解不透彻。下面列出三类最常见的高危陷阱及其实战防御手法:
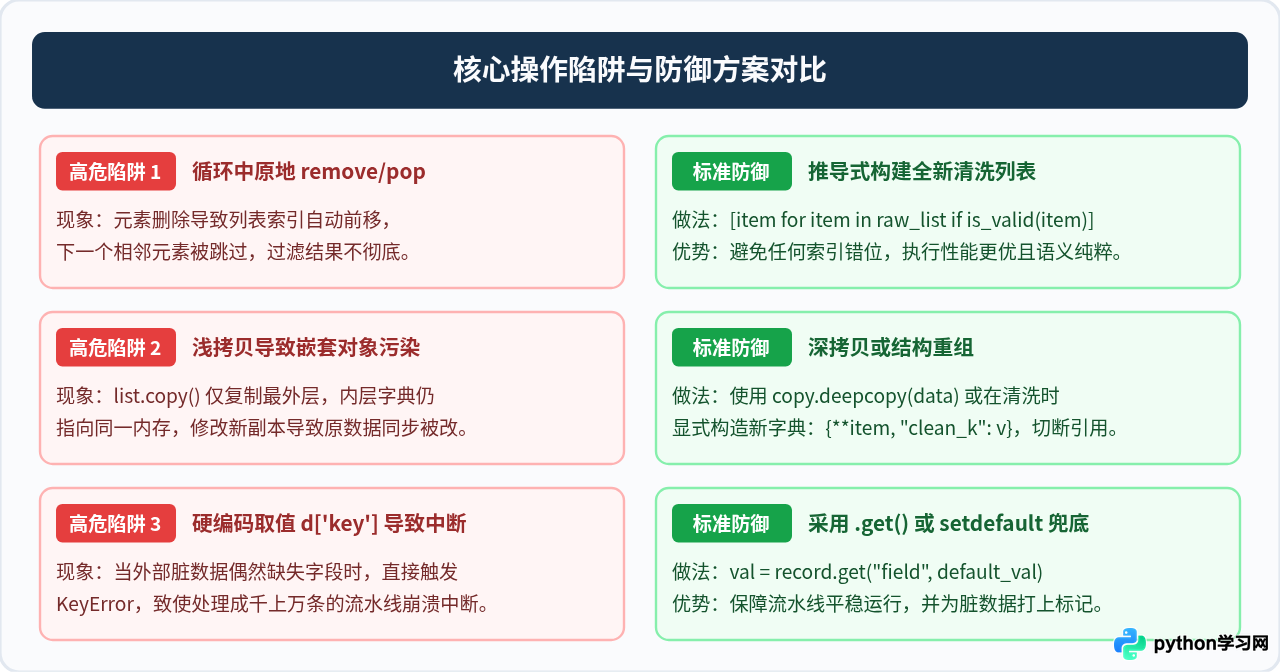
陷阱 1:遍历列表过程中直接删除元素
很多人过滤数据时喜欢写这样的代码:
# 错误示例:边遍历边删除
for order in orders:
    if float(order.get("amount", 0)) <= 0:
orders.remove(order) # 致命错误!导致索引偏移,紧邻的下一个元素被漏检避坑策略:永远不要在 for 循环中直接对当前正在迭代的同一个列表执行 remove()、pop() 或 del。请使用列表推导式或内置的 filter() 函数生成新列表。
陷阱 2:浅拷贝带来的“幽灵修改”
如果调用 copied_orders = raw_orders.copy(),系统只拷贝了最外层的列表容器。列表内部的每个字典对象,依然指向原来的内存地址。如果修改了 copied_orders[0]["status"] = "PROCESSED",原始的 raw_orders[0]["status"] 也会跟着被修改!
避坑策略:如果需要在保留原始数据的前提下进行试探性清洗,使用 Python 内置的 copy.deepcopy() 进行深层递归复制,或者在生成清洗数据时总是返回新建的字典对象:
import copy
clean_backup = copy.deepcopy(raw_orders)
五、知识总结:核心数据结构操作与决策矩阵
为了在以后的开发中能够根据场景快速选择最合适的数据结构和操作方法,我们将列表与字典的关键特性整理为决策矩阵:
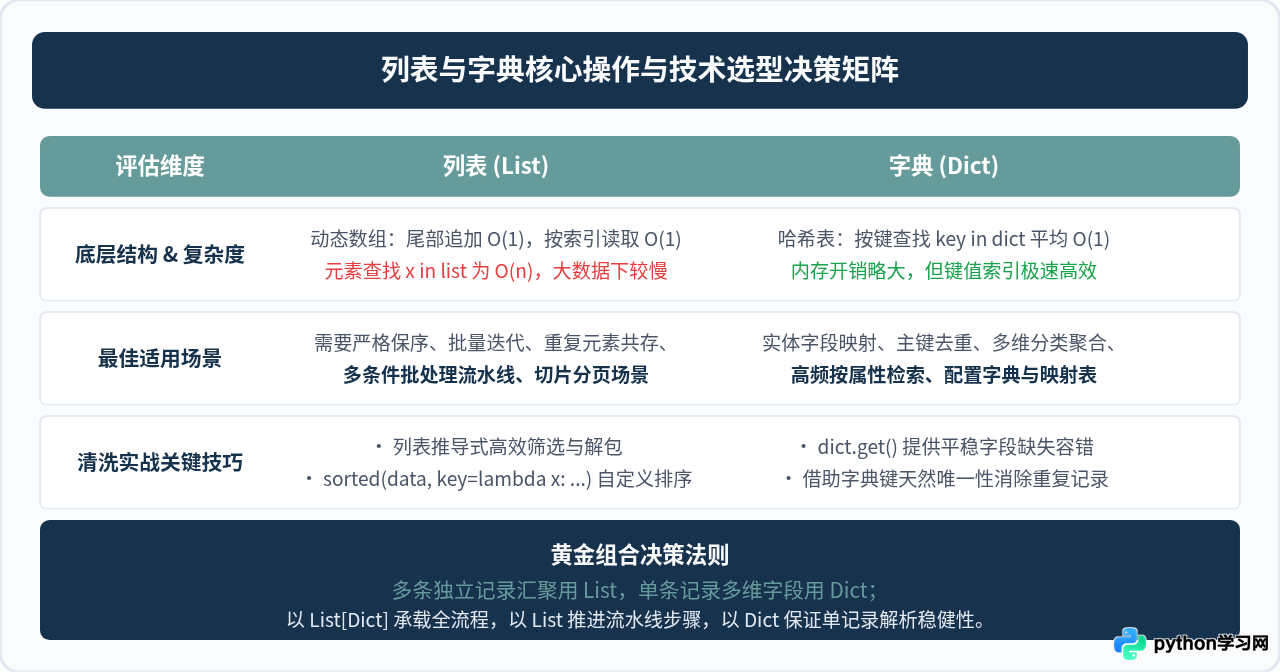
掌握了列表与字典的搭配之道,就具备了处理绝大多数真实业务数据的底层内功。在后续遇到更复杂的数据结构(如嵌套多层列表与字典的树状 JSON)时,只要牢记“外层用序列驱动流程、内层用映射管理属性、各阶段以不可变思想推导生成”,就能写出无论面对多么脏乱的输入都能从容应对的高质量 Python 代码。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















