


Python遍历列表时删除元素的正确做法
remove() 或 del 会导致元素跳过与索引错位。处理该问题的核心准则是:要么通过列表推导式筛选生成目标列表,要么通过原列表切片副本进行迭代,要么采用倒序索引从末尾向前删除。
一、常见错误操作与漏删现象
初学者在尝试根据条件删除列表元素时,最容易写出类似以下的代码:
# 错误示例:直接遍历原列表并删除匹配元素
numbers = [1, 2, 2, 3, 4]
for item in numbers:
    if item == 2:
        numbers.remove(item)

print("处理后列表:", numbers)
# 期望输出: [1, 3, 4]
# 实际输出: [1, 2, 3, 4]
输出结果中依然残留了一个数值为 2 的元素。很多人误以为是 remove() 出了故障,但其实这是由于 Python 的列表遍历机制与底层连续内存结构相互作用所引发的必然结果。
二、底层原理解析:为什么直接遍历会发生漏删?
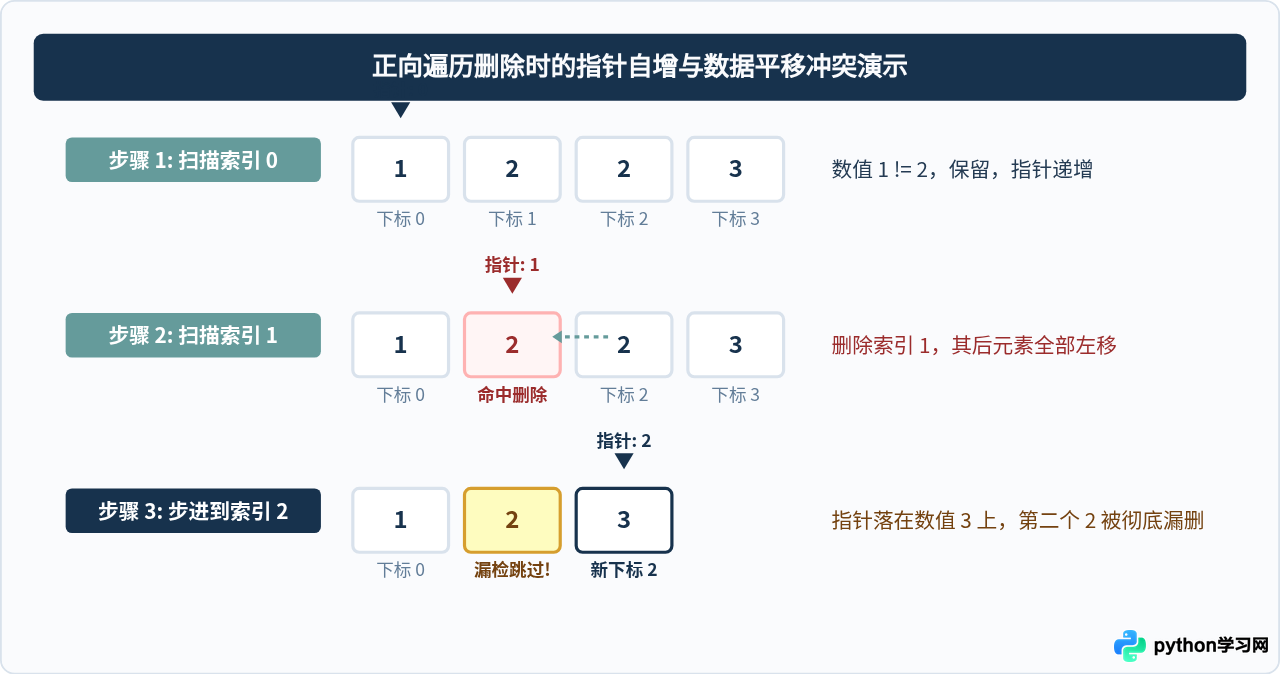
Python 内部的 for 循环依赖迭代器维护一个自增的整数索引计数器(从 0 递增到 len(lst) - 1)。当执行删除操作时,列表底层作为动态数组,被删元素右侧的所有元素会立即向左平移一个单位以填补空位:
- 当指针到达索引
1时,识别到第一个数值2并将其删除; - 原本位于索引
2的第二个数值2瞬间左移到索引1; - 迭代器按照既定规则向前步进,下一次循环检查索引
2; - 移入索引
1的第二个数值2恰好被指针越过,彻底失去了被检查的机会。
三、正确做法一:列表推导式(最推荐、最地道)
在 Python 编程哲学中,处理列表元素筛选的最优解通常不是“逐个删除无用项”,而是“筛选出需要的保留项”。使用列表推导式具备执行效率高、逻辑表达清晰、不易出错的特点:
# 推荐做法:通过条件筛选保留目标元素
numbers = [1, 2, 2, 3, 4]

# 保留所有不等于 2 的元素
numbers = [item for item in numbers if item != 2]

print(numbers)  # 输出: [1, 3, 4]
这种写法的底层执行逻辑是在 C 语言层面快速申请一块连续内存空间,仅将满足保留条件的对象指针填入新列表中。由于完全脱离了原地修改的指针同步问题,因此在逻辑上具有百分之百的安全性。
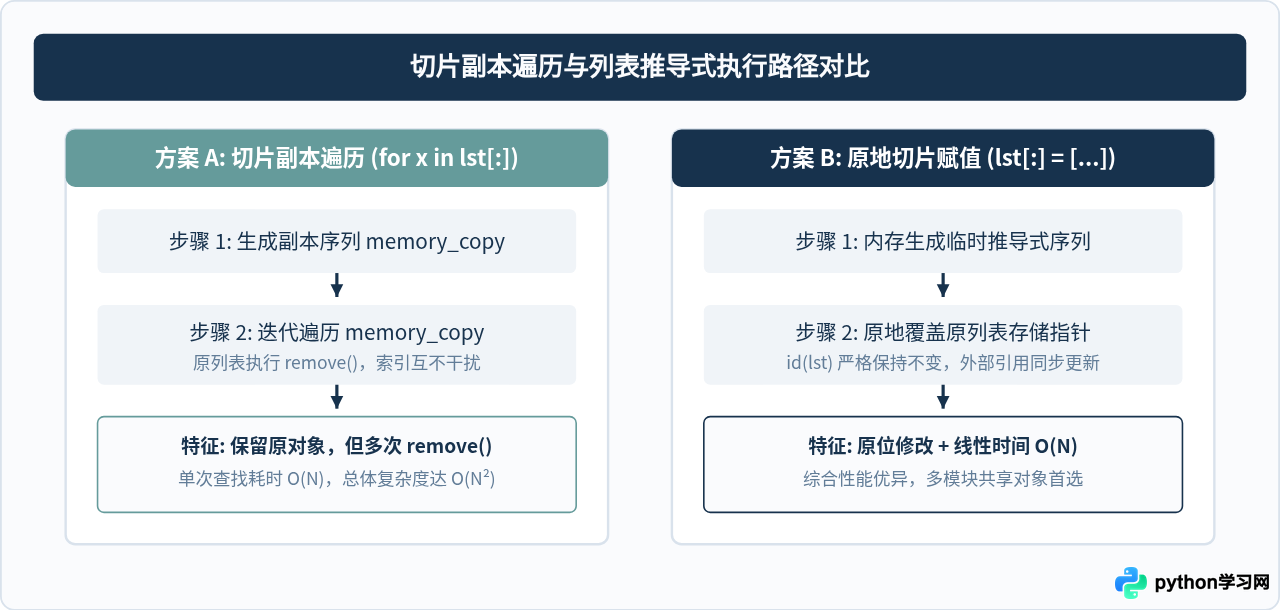
numbers 重新指向该新对象。如果外部有其他变量或函数参数也引用了原列表对象,该绑定不会改变外部引用的内容。若必须保持原有对象内存地址不变,需使用后文介绍的原地切片赋值。
四、正确做法二:切片浅拷贝遍历原列表
如果出于业务逻辑必须使用 for 循环,并且在循环体中执行复杂的删除判断逻辑,那么正确的做法是遍历列表的浅拷贝(切片副本),而在原列表上执行删除:
numbers = [1, 2, 2, 3, 4]

# numbers[:] 创建原列表的浅拷贝,循环在副本上进行
for item in numbers[:]:
    if item == 2:
        numbers.remove(item)

print(numbers)  # 输出: [1, 3, 4]
在这个方案中,循环迭代的是 numbers[:] 产生的独立副本列表。原列表 numbers 发生的数据平移完全不影响副本的迭代索引,因此不会发生跳项漏删。
五、正确做法三:原地切片赋值(兼具原地修改与高效率)
当开发者既想要列表推导式的高效率(单次线性扫描),又必须将修改同步给该列表的所有外部引用者时,切片赋值语法 lst[:] = [...] 是最优雅的标准解法:
def purge_evens(target_list):
    # 使用切片赋值,原地更新列表内部数据指针
    target_list[:] = [x for x in target_list if x % 2 != 0]

data = [10, 15, 20, 25, 30]
alias_data = data  # 外部别名引用

purge_evens(data)

print("data:", data)              # 输出: [15, 25]
print("alias_data:", alias_data)  # 输出: [15, 25]
print(id(data) == id(alias_data)) # 输出: True (对象地址完全未变)该语法保留了原有列表的内存地址(id 保持一致),同时将新筛选序列的元素批量复制回原对象容器中。这种做法避免了循环调用 remove() 时产生的大量重复线性查找开销。
六、正确做法四:倒序索引遍历删除(纯原地零额外空间)
在部分极端内存受限的场景下,若无法承受创建副本或生成新列表所产生的临时内存消耗,可以使用倒序索引遍历(Reverse Index Traversal)。
倒序删除之所以安全,是因为从列表尾部向前检查,当执行 del lst[i] 时,只有处于 i 右侧已完成检查的元素会发生左移,而处于 i 左侧尚未被访问的元素其相对位置和物理索引保持绝对静止:
numbers = [1, 2, 2, 3, 4]

# range(len(numbers) - 1, -1, -1) 生成从末位向首位的倒序索引
for i in range(len(numbers) - 1, -1, -1):
    if numbers[i] == 2:
        del numbers[i]

print(numbers)  # 输出: [1, 3, 4]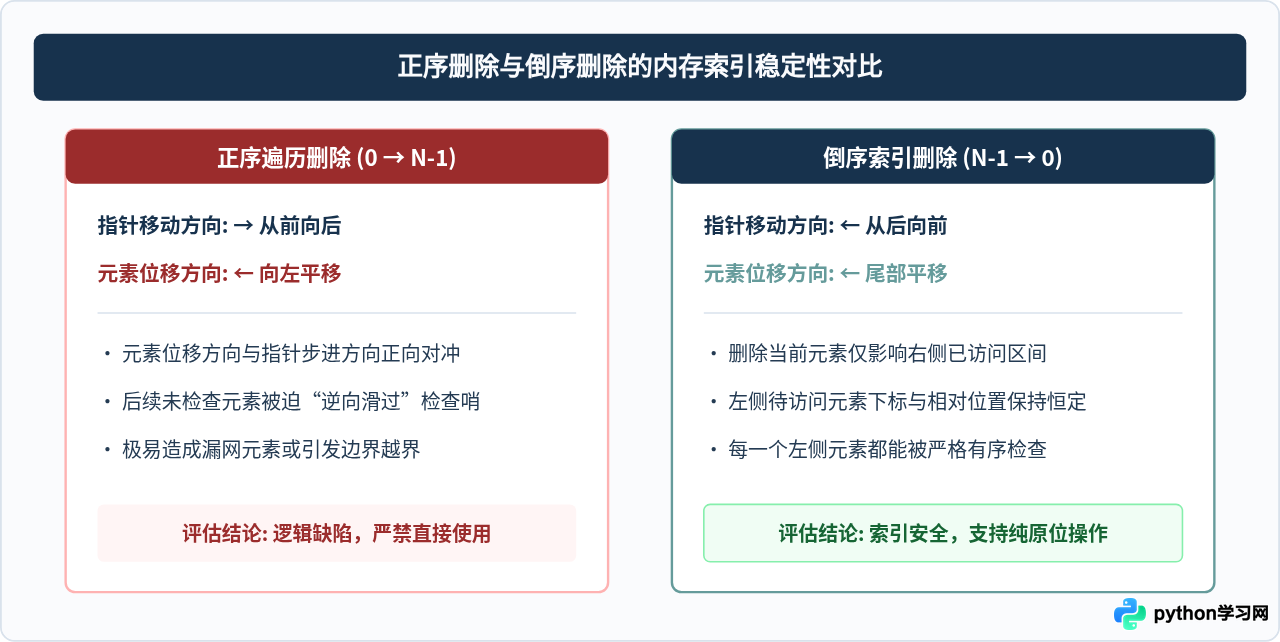
七、方案选型与性能权衡指南
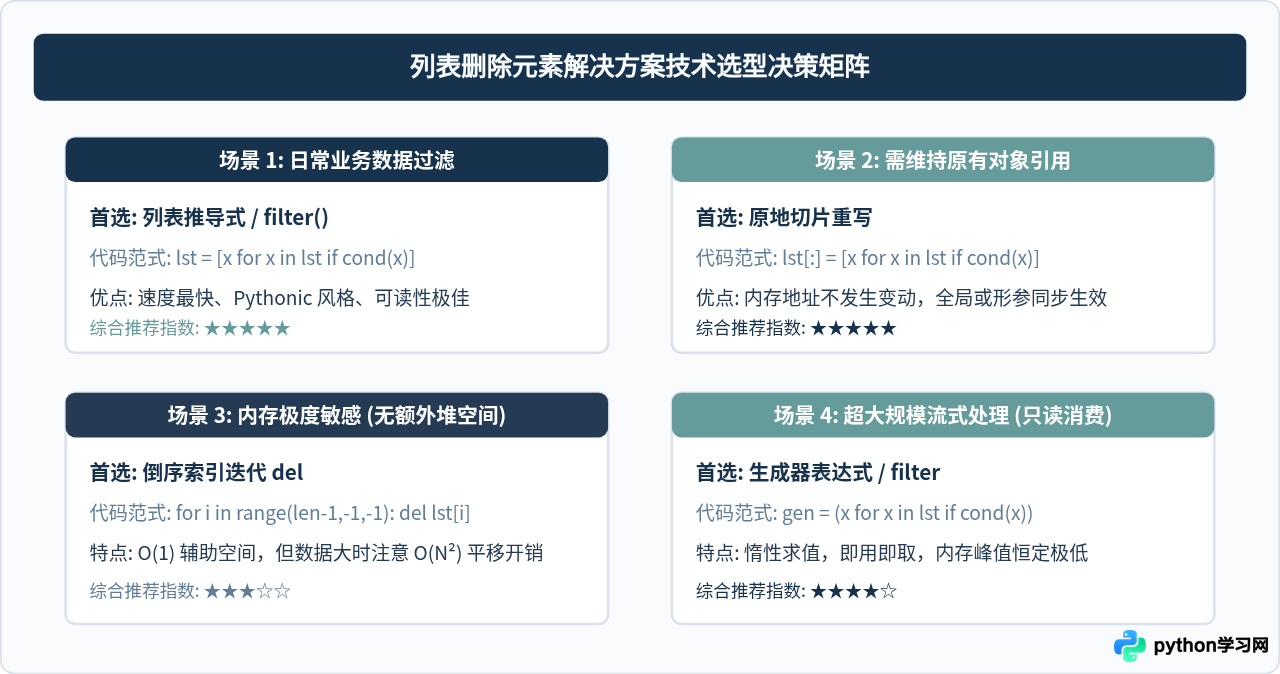
在工程实践中,不同的方案在可读性、执行耗时、空间占用以及外部引用保持方面存在差异。选择方案时可参考下表与决策矩阵:
| 处理方案 | 时间复杂度 | 额外空间 | 是否修改原对象 | 最佳适用场景 |
|---|---|---|---|---|
列表推导式 [x for x in lst if ...] |
O(N) | O(N) | 否 (生成新对象) | 绝大多数常规过滤逻辑,代码简洁 |
切片赋值 lst[:] = [...] |
O(N) | O(N) | 是 (原地更新) | 跨函数传递列表、多引用保持场景 |
切片遍历 + remove for x in lst[:] |
O(N²) | O(N) | 是 (原地删除) | 数据量极小(十几个以内)且逻辑复杂的脚本 |
倒序索引删除 del lst[i] |
O(N²) | O(1) | 是 (原地删除) | 强约束禁止分配临时额外内存的环境 |
八、核心要点总结
- 禁止直接迭代原列表删除:永远不要对正在正向遍历的同一个列表对象调用
.remove()或del。 - 常规推荐列表推导式:编写
[x for x in lst if not condition(x)],代码最具可读性且速度最快。 - 必须原地修改时使用切片赋值:编写
lst[:] = [x for x in lst if not condition(x)],保持对象内存地址不变。 - 极端内存约束使用倒序遍历:从末尾向前执行
for i in range(len(lst)-1, -1, -1)并配合del lst[i]。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















