


Python爬虫陷入无限重定向循环的检测与处理方法

在编写 Python 爬虫抓取目标网站时,开发者常会遇到程序突然报错卡死或抛出 requests.exceptions.TooManyRedirects 的情况。出现此类报错的核心原因,是目标服务器返回了带有跳转指令的 HTTP 状态码(如 301、302、307),而爬虫客户端在跟随跳转后,由于缺少 Cookie、请求头缺失、URL 规范化差异或反爬验证拦截,被服务器再次重定向回前序地址或进入无限交替跳变链路。解决该问题的标准路径包括:明确成环场景、提取 response.history 定位跳转轨迹、引入带环路判重的自定义重定向机制,以及通过 Session 维持完整的上下文状态。
一、重定向成环机理与常见诱发场景
HTTP 协议中,3xx 系列状态码用于告知客户端所请求的资源已迁移,并在响应头部中附带 Location 字段指引新的访问地址。主流 HTTP 客户端(如 requests)默认开启自动跟随重定向(allow_redirects=True),且内置最大跳转上限(requests 默认上限通常为 30 次)。当跳转次数超过上限时,客户端就会抛出超限异常。
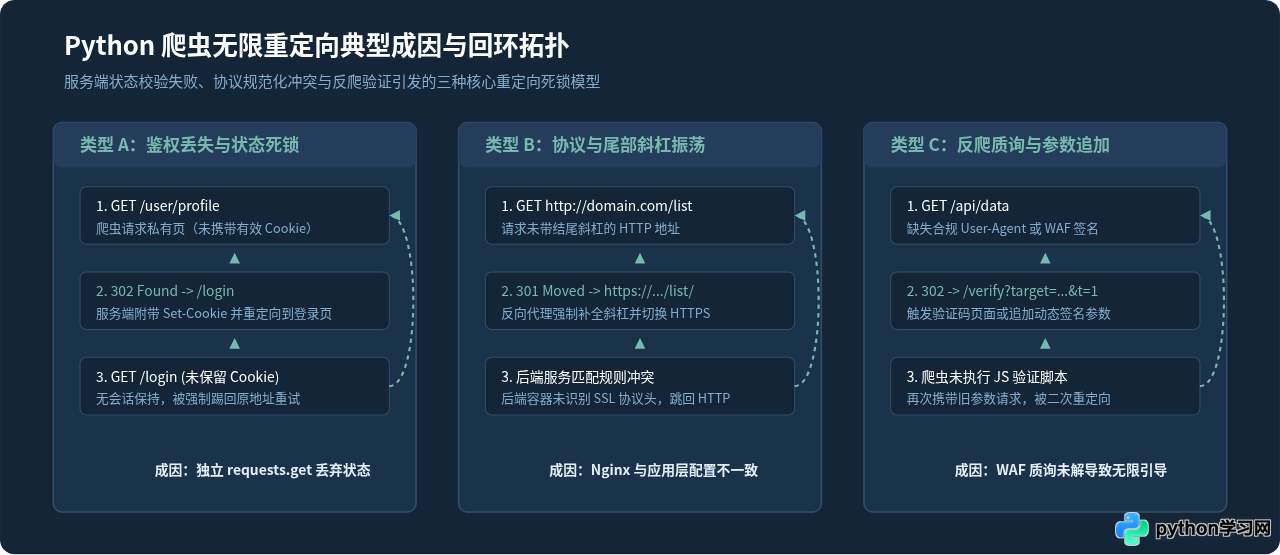
重定向循环并非单纯由网络故障引起,绝大多数情况下是爬虫行为模式与服务端校验逻辑碰撞的结果。归纳起来主要有以下四点:
- 会话状态与 Cookie 丢失:使用独立的
requests.get()发出请求时,每次调用都是全新的会话。如果服务端在 302 响应中下发了认证令牌(如Set-Cookie: session_id=xxx),但客户端在紧接着发起对Location目标的请求时未带回该 Cookie,服务端便会认为用户未认证并再度重定向到登录页。 - 反向代理与 URL 规范化冲突:网站往往有严格的 URL 规范,例如强制要求末尾带斜杠(
/catalog/)或强制升级 HTTPS。若网关层将 HTTP 重定向至 HTTPS,而后端应用或 CDN 回源配置错误又将 HTTPS 重定向至 HTTP,两者之间就会形成双向乒乓弹跳。 - WAF 与防爬策略拦截:许多安全防护系统在检测到爬虫默认请求头(如 Python 自带的
python-requests/x.x.x)后,会返回 302 临时跳转到防爬滑块页或防盗链页;若脚本未解析防爬参数而继续跟进,会导致反复进入验证中间页。 - 动态追加参数膨胀:部分系统的重定向逻辑会在 URL 结尾追加回调参数(例如
?redirect_count=1或时间戳)。若客户端始终无法满足放行条件,URL 可能会不断拉长直至超过头部限制或触发重定向循环报警。
二、重定向链路的检测与诊断定位
当遇到 TooManyRedirects 报错时,第一步不是盲目修改重定向参数,而是精准还原整个重定向链路,看清楚爬虫在哪些 URL 之间往返、每次跳转对应的状态码以及服务端返回的 Location 头部。
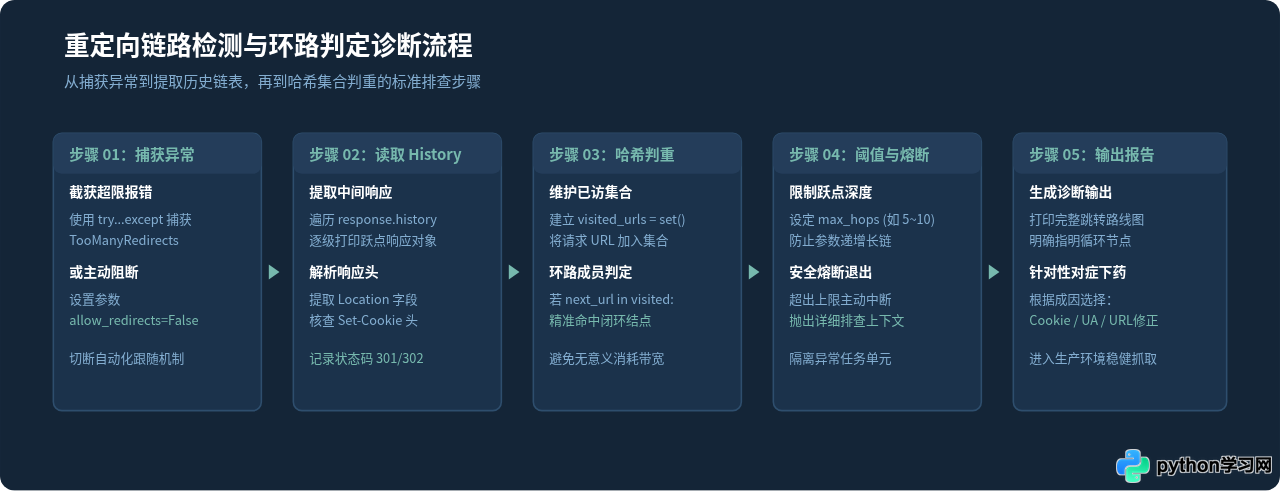
1. 查看请求历史对象(response.history)
requests 库在每次完成重定向后,都会将前面的响应对象按顺序保存在最终响应的 history 列表中。如果请求并未直接崩溃,或者我们调小最大重定向跳数捕获异常,可以直接检查该列表:
import requests

url = "https://example.com/target-path"
headers = {
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36"
}

try:
    response = requests.get(url, headers=headers, timeout=10)
    print(f"最终响应状态码: {response.status_code}")
    print(f"最终 URL: {response.url}")
    print(f"累计重定向次数: {len(response.history)}")

    # 逐级打印跳转历史
    for i, resp in enumerate(response.history, 1):
        target_location = resp.headers.get("Location", "未标明")
        print(f"跃点 [{i}] 状态码: {resp.status_code} | 当前URL: {resp.url} -> 目标: {target_location}")

except requests.exceptions.TooManyRedirects as err:
    print(f"捕获到重定向循环异常: {err}")
# 发生异常时,可以通过异常挂载的 response(若可用)或手动单步探测获取上下文requests.get() 直接触发 TooManyRedirects 抛出时,外部无法通过常规变量直接拿到完整的未完成 response。因此,在排查顽固死循环时,推荐改用下述“单步探测”方案。
三、解决无限重定向的核心处理方案与代码实践
针对排查出的具体原因,我们需要采用相匹配的防御策略。以下是处理 Python 爬虫重定向死锁最常用且最有效的四种技术方案。
方案 1:必须使用 Session 保持上下文
对于由于登录失效、防盗链验证引致的重定向死循环,最直接的手段是将孤立的 requests.get() 改写为基于 requests.Session() 的调用。Session 会在整个生命周期内自动接收并回传 Set-Cookie:
import requests

# 创建会话对象,自动管理 Cookie 状态
session = requests.Session()

# 统一定义请求头,避免反爬识别为裸脚本
session.headers.update({
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36",
    "Accept": "text/html,application/xhtml+xml,application/xml;q=0.9,image/webp,*/*;q=0.8",
    "Accept-Language": "zh-CN,zh;q=0.9,en;q=0.8",
})

# 如果需要登录或携带已有凭证,可预先注入
# session.cookies.set("auth_token", "YOUR_TOKEN_HERE", domain="example.com")

try:
    resp = session.get("https://example.com/protected-resource", timeout=10)
    print(f"最终获取成功: {resp.url}, 状态码: {resp.status_code}")
except requests.exceptions.TooManyRedirects:
    print("使用了 Session 依然发生重定向超限,需进一步检查是否为反爬质询或 URL 配置冲突")
方案 2:编写带环路检测的手动重定向跟踪器(核心推荐)
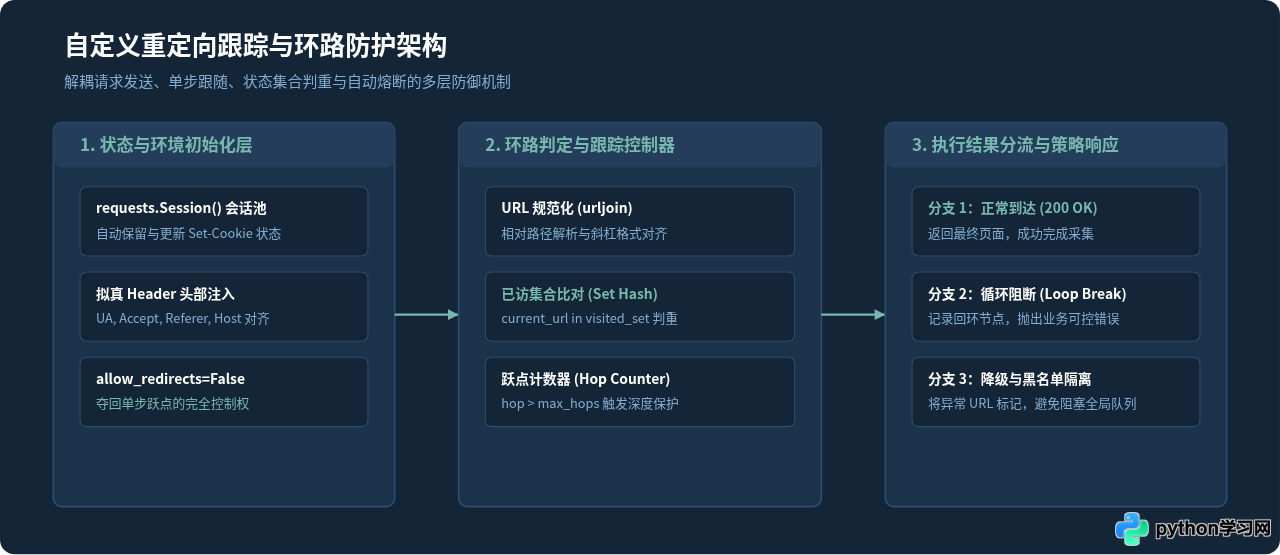
为了从根本上阻止爬虫在 A 与 B 之间无限跳动,最稳妥的工程方案是:禁用默认自动跳转(allow_redirects=False),采用 while 循环配合已访问 URL 集合(visited_set)实现手动跟踪。一旦发现即将访问的 Location 已经存在于集合中,即可立即判定为死循环并安全退出。
from urllib.parse import urljoin
import requests

def safe_fetch(start_url, max_hops=8, timeout=10):
    """
    手动跟随重定向并检测闭环链路
    :param start_url: 起始请求 URL
    :param max_hops: 最大允许跳转次数
    :param timeout: 超时时间(秒)
    :return: 最终成功响应的 Response 对象
    """
    session = requests.Session()
    session.headers.update({
        "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36",
        "Accept": "text/html,application/xhtml+xml,application/xml;q=0.9,*/*;q=0.8",
    })

    current_url = start_url
    visited_urls = set()
    history_trace = []

    for hop in range(1, max_hops + 1):
        # 环路判定:当前 URL 已经访问过,立即熔断
        if current_url in visited_urls:
            chain_str = " -> \n  ".join(history_trace + [current_url])
            raise RuntimeError(f"【拦截】检测到重定向死循环!重复节点: {current_url}\n链路轨迹:\n  {chain_str}")

        visited_urls.add(current_url)
        history_trace.append(current_url)

        # 禁用内置自动跳转,单步控制
        resp = session.get(current_url, allow_redirects=False, timeout=timeout)
        print(f"跃点 [{hop}/{max_hops}] 访问: {current_url} -> 状态码: {resp.status_code}")

        # 判断是否为重定向状态码 (301, 302, 303, 307, 308)
        if resp.status_code in (301, 302, 303, 307, 308):
            location = resp.headers.get("Location")
            if not location:
                raise ValueError(f"收到状态码 {resp.status_code},但响应头缺失 Location 字段")

            # 兼容相对路径跳转,例如 Location: /index.html
            next_url = urljoin(current_url, location)
            current_url = next_url
        else:
            # 状态码为 200 或其他非重定向代码,正常返回
            print(f"成功到达最终页面: {current_url}")
            return resp

raise RuntimeError(f"已超出设定的最大重定向次数 ({max_hops}),可能存在长链无限跳转")urljoin(current_url, location)能够准确处理形如Location: /login、Location: ?step=2的相对路径,确保比对键值的完整性与规范性。set的查询复杂度为 O(1),在每次循环前检查current_url in visited_urls,能在第二轮命中循环的第一个跃点时毫秒级阻断,省去数十次无谓请求。
方案 3:调整 requests 原生最大重定向阈值
如果业务本身由于多层微服务调用确有较多合法跳转(例如 5~8 次),但又希望防止在 30 次才报错导致耗时过长,可以直接修改 Session 的 max_redirects 属性:
session = requests.Session()
# 将默认的 30 次重定向降低为 5 次,快速试错
session.max_redirects = 5
四、异步与现代客户端处理(httpx / aiohttp)
在大规模高并发爬虫中,常用 httpx 或 aiohttp 替代 requests。这两款现代库在重定向处理上的设计更加严格:
| 客户端库 | 默认重定向行为 | 最大重定向控制参数 | 异常类型 |
|---|---|---|---|
| requests | 默认开启跟随 (True) | session.max_redirects = 30 |
requests.exceptions.TooManyRedirects |
| httpx | 默认关闭跟随 (False) | client = httpx.Client(max_redirects=5) |
httpx.TooManyRedirects |
| aiohttp | 默认开启跟随 (True) | session.get(url, max_redirects=5) |
aiohttp.TooManyRedirects |
以 httpx 为例,其设计理念推荐显式声明跳转意图。若开启跟随,可以直接在客户端级别设定上限:
import httpx

# httpx 必须显式开启 follow_redirects=True 才会跳转
with httpx.Client(follow_redirects=True, max_redirects=5, timeout=10) as client:
    try:
        response = client.get("https://example.com/target")
        print(f"最终 URL: {response.url}, 状态码: {response.status_code}")
    except httpx.TooManyRedirects as e:
        print(f"httpx 捕获重定向超限: {e}")
五、排查与防御速查总结
面对爬虫重定向死锁,开发者可参照下述结构化四步矩阵快速定位并修复问题:
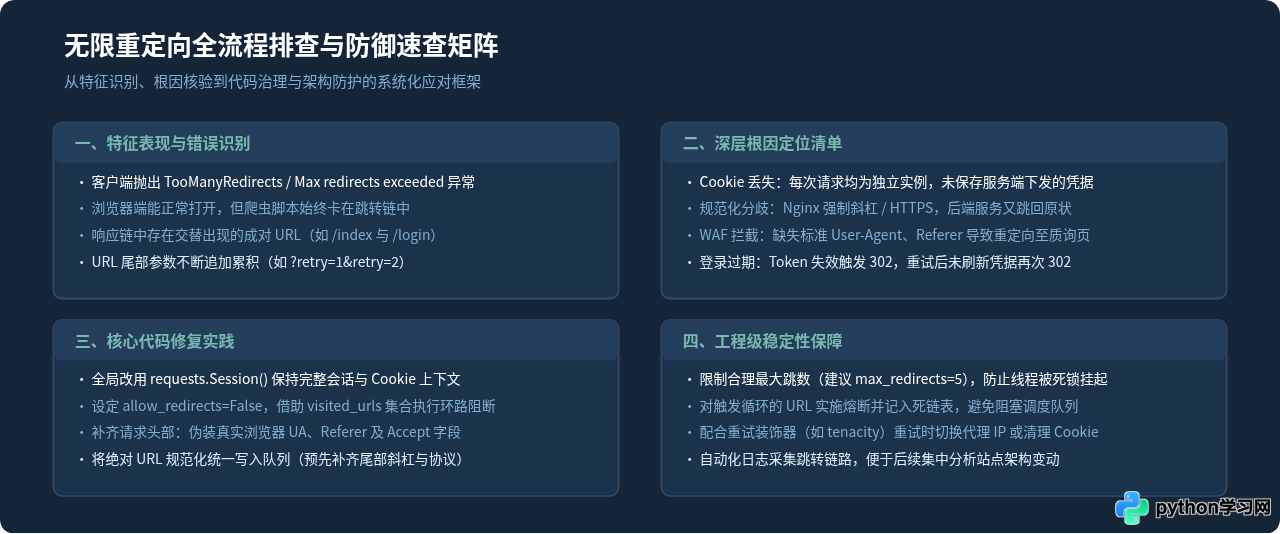
综上所述,Python 爬虫陷入无限重定向并非不可控的偶发故障。通过 response.history 抓取跳转链、利用 requests.Session() 维护服务端状态、配合 allow_redirects=False 与已访哈希集合构建主动环路拦截,便可以在保障爬虫抓取效率的同时,彻底根除重定向死循环导致的程序中断与资源浪费。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















