


Python使用numpy.random高效生成大规模随机数组
在处理千万级乃至上亿规模数据模拟、机器学习特征采样或蒙特卡洛仿真时,生成随机数组的吞吐率和内存开销直接决定程序稳定性。本文详解如何利用 NumPy 现代随机数 API 生成大规模数组,并在内存占用、执行速度与线程安全之间取得最佳平衡。
一、认识 NumPy 现代随机数接口的核心机制
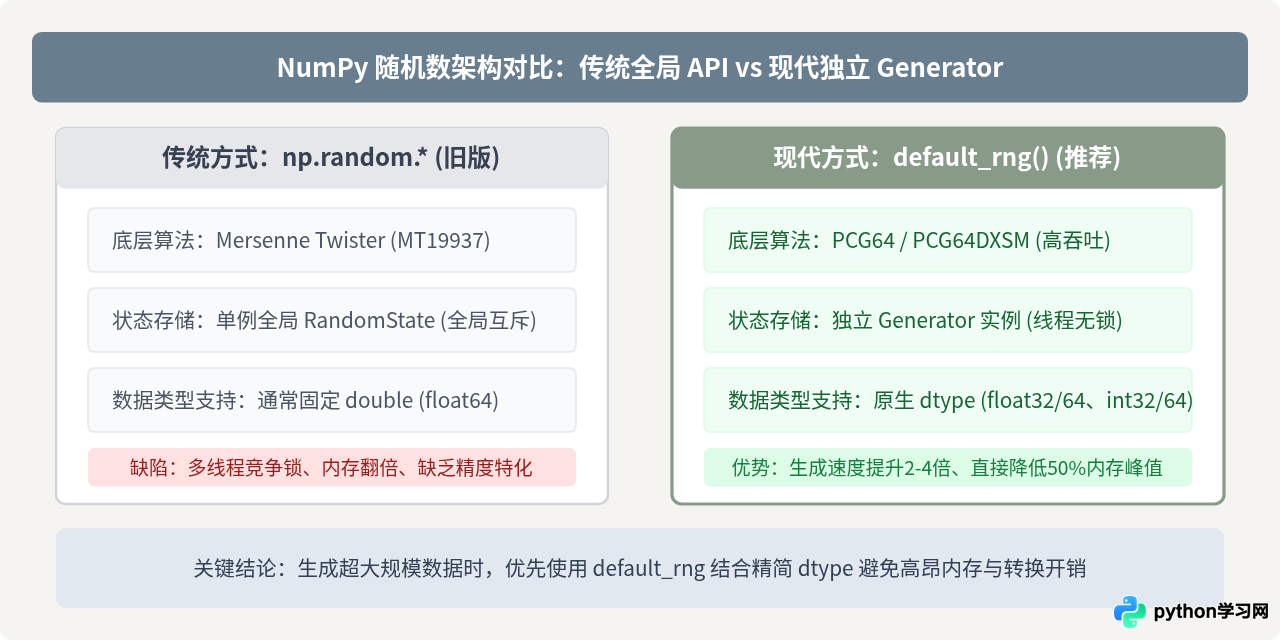
自 NumPy 1.17 开始,官方重构了随机数子模块,引入了以 Generator 和底层 BitGenerator 为基础的新架构,推荐通过 np.random.default_rng() 代替旧版面向全局状态的 np.random.* 快捷函数(如 np.random.rand、np.random.randn)。
这种转变对于大规模数据生成尤为关键。旧版 API 基于 Mersenne Twister (MT19937) 算法,维护一个全局共享的状态对象,且在底层绑定全局锁(GIL),在循环调用或多线程中会造成明显的串行等待。而 default_rng() 默认采用更为先进的 PCG64 算法,具备极佳的统计随机性、极短的状态周期跳转耗时,且各个生成器实例完全独立、无锁运行。
| 评估维度 | 传统 API (np.random.*) |
推荐 API (default_rng()) |
大规模生成时的具体影响 |
|---|---|---|---|
| 底层位生成器 | MT19937 | PCG64 | PCG64 计算流水线更短,大批量纯数字生成速度更快 |
| 数据类型控制 | 默认生成 float64 |
原生支持 dtype=np.float32 |
float32 单精度比双精度直接节省 50% 的物理内存 |
| 原地填充能力 | 无 out 参数支持 |
支持 out=arr 原地填充 |
避免在堆中先分配临时数组再拷贝,消除内存瞬时尖峰 |
| 并发与隔离 | 全局共享状态,存在锁 | 独立对象,易于并行切分 | 在多线程处理不同分区时无锁争夺,线性扩展吞吐 |
二、高效生成大规模随机数组的标准流程
生成大规模随机数组不仅是调用单行函数,更需在执行前明确空间规划。以下是经过工业验证的四步标准操作流程:
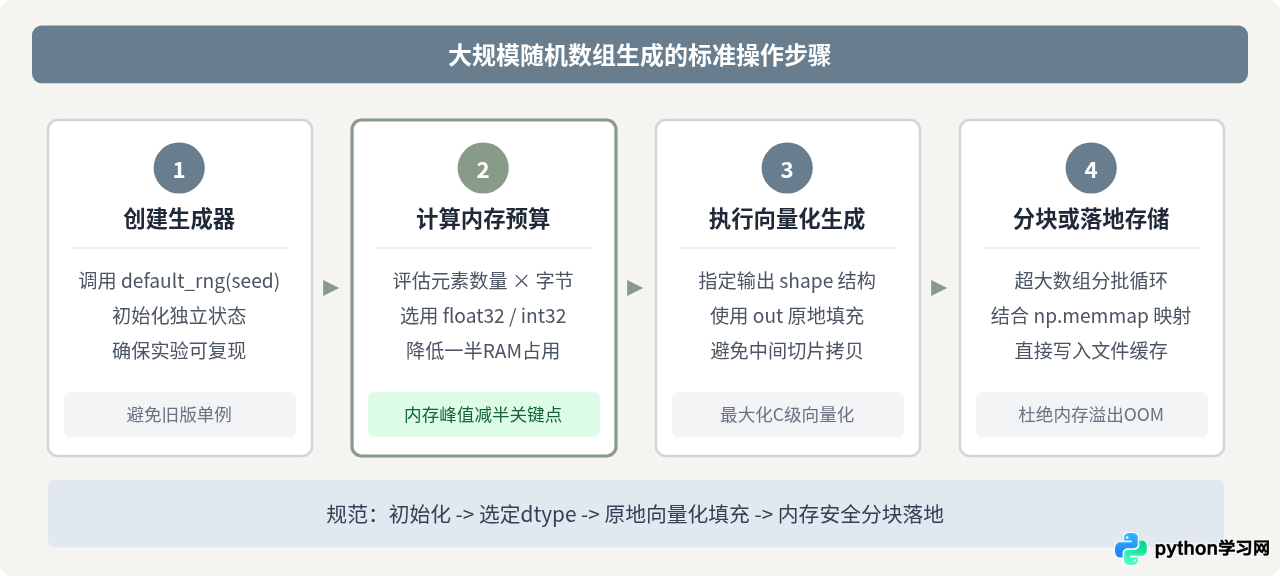
1. 实例化生成器并设置随机种子
为保证科研实验或数据工程的可复现性,应显式传入整数种子初始化。避免直接重复调用 default_rng() 而不复用实例,因为反复创建对象的开销会抵消生成效率:
import numpy as np

# 建立一个独立的随机数生成器实例
seed = 20261026
rng = np.random.default_rng(seed)
2. 显式指定单精度减少内存占用
大规模生成时,内存是第一制约因素。默认情况下,浮点随机数(如标准正态分布或均匀分布)以 64 位双精度(8 字节)返回。若生成 1 亿个浮点数,float64 需占用约 763 MiB,而指定 dtype=np.float32 仅需约 381 MiB,节省整整一半内存,并且由于内存带宽利用率翻倍,CPU 写入缓存的速度也会显著提升:
# 生成 10,000,000 个 [0.0, 1.0) 之间的 32 位浮点数
arr_uniform = rng.random(size=10_000_000, dtype=np.float32)

# 生成形状为 (10000, 1000) 的标准正态分布数组
arr_normal = rng.standard_normal(size=(10_000, 1_000), dtype=np.float32)
3. 利用 out 参数进行原地填充
在已经预分配内存空间(例如多轮仿真迭代或已有特定内存块)的场景下,使用 out 参数可以直接将随机序列填入指定连续内存,而不需要在堆中临时新建数组再赋值,这彻底消除了垃圾回收(GC)引起的内存毛刺:
# 预分配连续内存空间
buffer = np.empty((5_000, 2_000), dtype=np.float32)

# 原地填充标准正态分布随机数
rng.standard_normal(out=buffer)
三、应对超大规模数据的内存控制策略与原理
当数组规模达到数十亿个元素(需要数十吉字节物理内存)时,如果尝试一次性分配连续数组,极易因系统连续物理地址不足引发 MemoryError。此时应通过分块生成或结合 np.memmap 流式写入磁盘。
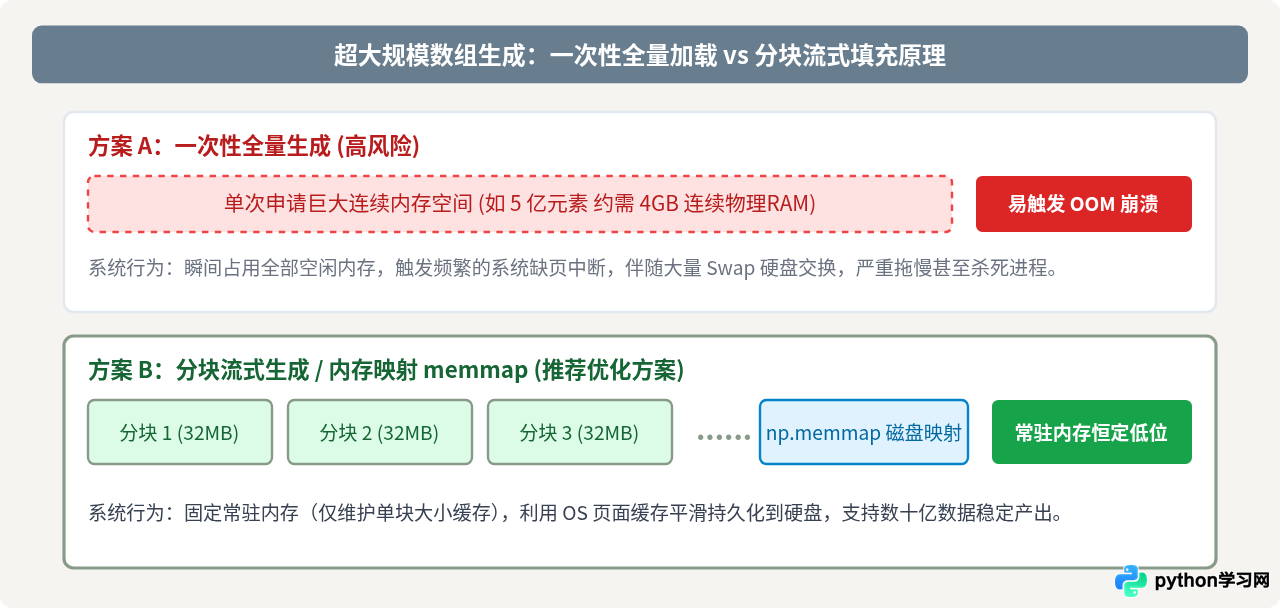
np.memmap 在仅占用数十兆内存的前提下,生成并持久化 1 亿个 32 位浮点随机数:
import numpy as np

total_elements = 100_000_000  # 1 亿元素
chunk_size = 5_000_000        # 每批处理 500 万,单块仅占约 19MB
filename = "large_random_array.dat"

rng = np.random.default_rng(2026)

# 在磁盘上创建内存映射文件
mmap_array = np.memmap(
    filename,
    dtype=np.float32,
    mode="w+",
    shape=(total_elements,)
)

# 循环分块填充
for i in range(0, total_elements, chunk_size):
    end_idx = min(i + chunk_size, total_elements)
    # 直接在内存映射切片上原地生成
    rng.random(size=end_idx - i, dtype=np.float32, out=mmap_array[i:end_idx])

# 确保完全刷入磁盘
mmap_array.flush()
print("大规模数据生成并刷写完成。")
四、常见随机分布的大规模生成技巧与避坑指南
不同数学分布在底层的生成开销大不相同。掌握各类分布的高效生成方法可以避免走弯路:
1. 大规模离散整数采样 (rng.integers)
旧版 API 使用 np.random.randint,而现代推荐使用 rng.integers。rng.integers 专门针对不同位宽(如 8位、16位、32位、64位整数)实现了优化的位掩码算法:
# 生成范围在 [0, 100) 的 8 位无符号整数 5000 万个(总共仅 47.6 MiB)
small_integers = rng.integers(0, 100, size=50_000_000, dtype=np.uint8)
2. 超大规模无放回随机抽样
当需要从 $N$ 个元素中无放回抽取 $M$ 个元素时,若 $M$ 极大,rng.choice(replace=False) 会在底层根据比例自动选择算法。若仅需要打乱整个序列,应直接调用 rng.permutation 或原地打乱 rng.shuffle,避免建立全量的索引数组。
3. 并行与多进程环境下的种子派生 (SeedSequence)
如果在多进程(如 multiprocessing 或 Celery)中并行生成随机数,切忌把主进程的 rng 实例直接通过浅拷贝或全局变量暴露给各个子进程。否则,所有子进程将产生完全一致的重复随机数。正确做法是使用 SeedSequence 为每个并发工作线程或进程派生独立的独立生成器:
from numpy.random import SeedSequence, default_rng

# 生成根种子序列并派生4个独立生成器
ss = SeedSequence(123456)
child_seeds = ss.spawn(4)
streams = [default_rng(s) for s in child_seeds]

# 每个 worker 独享各自的 streams[i],无锁且序列相互正交独立
五、知识梳理与最佳实践总结
在 Python 中生成大规模随机数组是一项典型的计算与内存密集型任务。将现代生成器与精简数据类型配合使用,可以显著提高程序吞吐并杜绝内存溢出。
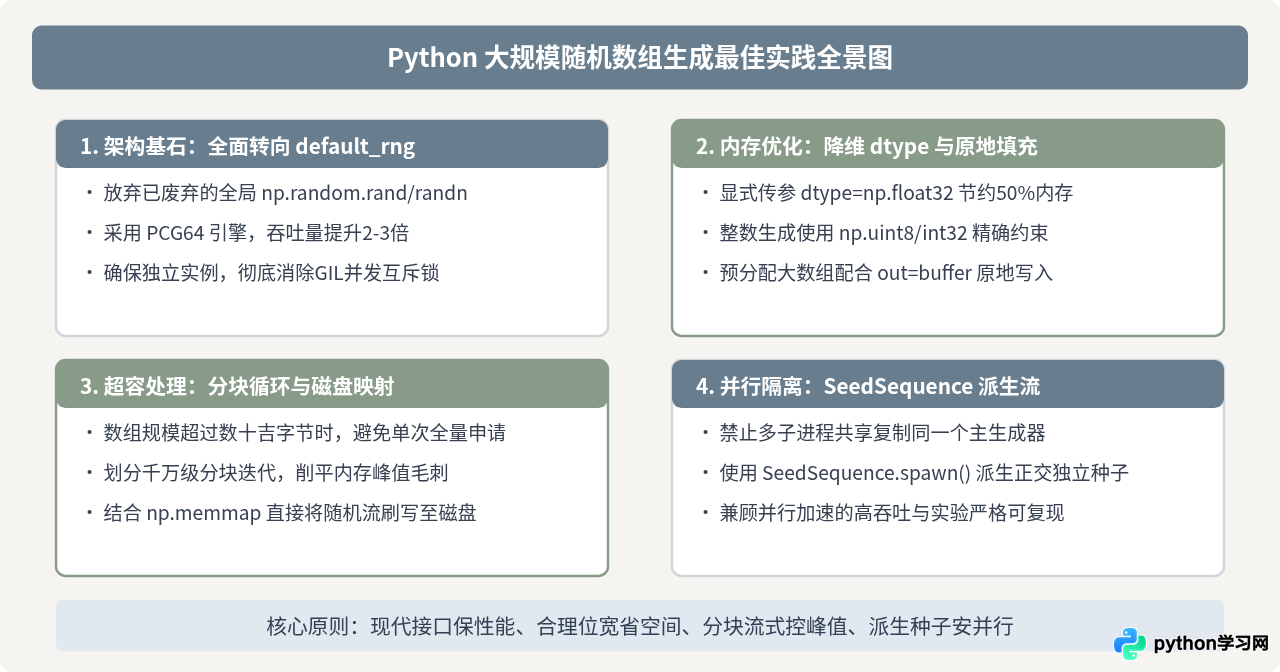
遵循上述原则,开发者不仅可以充分释放 CPU 的向量化计算性能,还能在大规模机器学习采样、蒙特卡洛仿真等生产环境中,以极低且可控的物理内存开销稳定运行。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















