


Python打开文件报错FileNotFoundError怎么解决

在 Python 中执行 open() 试图读取或操作文件时,如果抛出 FileNotFoundError: [Errno 2] No such file or directory,其本质原因始终是解释器在所指定的绝对物理路径上未检索到目标文件。解决该问题的关键在于理清程序执行时的“当前工作目录”与目标路径的真实对应关系,并规范路径编写方式。
一、报错信息的核心结构与解读
当 Python 抛出 FileNotFoundError 时,终端输出的标准追溯信息(Traceback)通常包含清晰的线索:
Traceback (most recent call last):
  File "main.py", line 4, in <module>
    with open("config.json", "r", encoding="utf-8") as f:
FileNotFoundError: [Errno 2] No such file or directory: 'config.json'
报错最后一行指明了系统底层返回的错误代号 [Errno 2] 以及程序尝试打开的目标路径 'config.json'。很多开发者感到困惑的原因在于:“这个文件明明就在我的 Python 脚本旁边,为什么系统就是找不到?”要解答这个疑问,必须先了解排查逻辑。
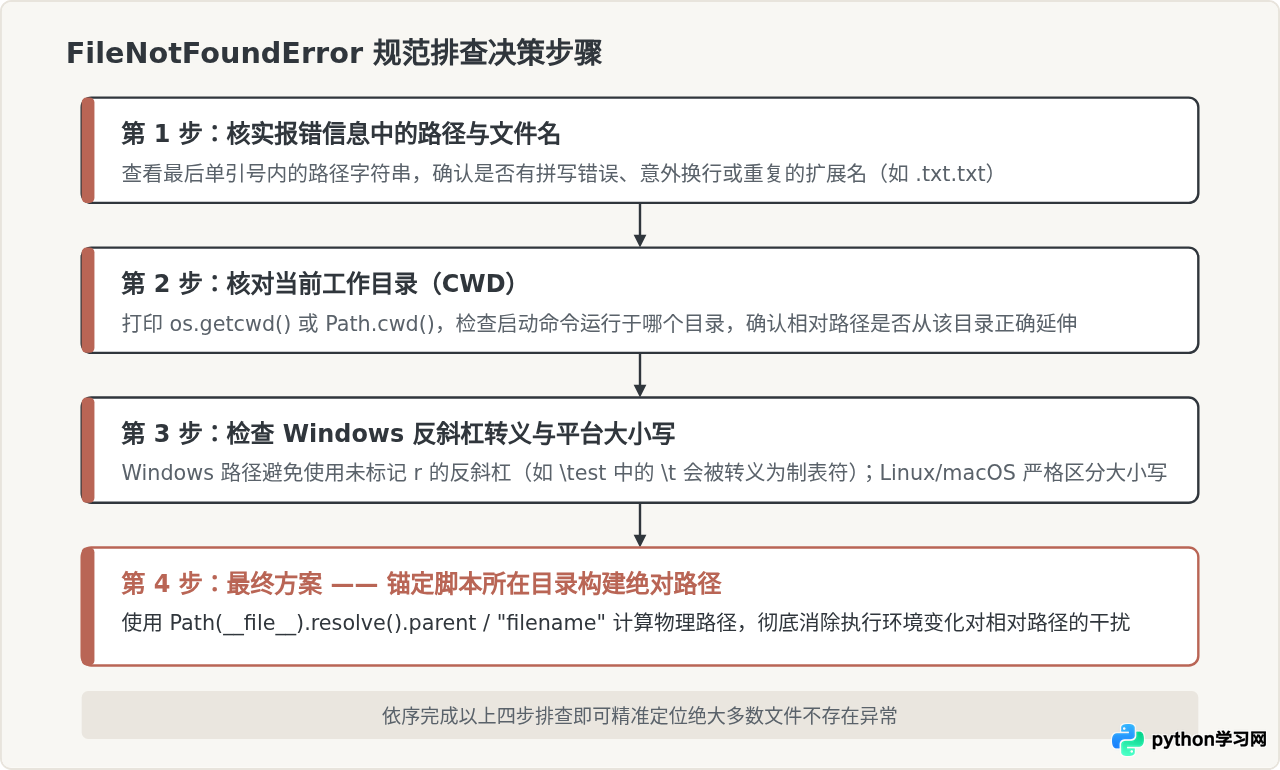
二、诱因一:当前工作目录(CWD)与相对路径偏差
这是导致 FileNotFoundError 出现概率最高的原因。许多初学者误以为在代码中写 open("data.csv") 时,Python 会自动从当前正在运行的 .py 脚本所在的文件夹寻找该文件。实际上并非如此。
Python 解析相对路径的基准,是运行该命令时终端所在的“当前工作目录”(Current Working Directory,简称 CWD),而不是脚本代码文件自身的存放目录。
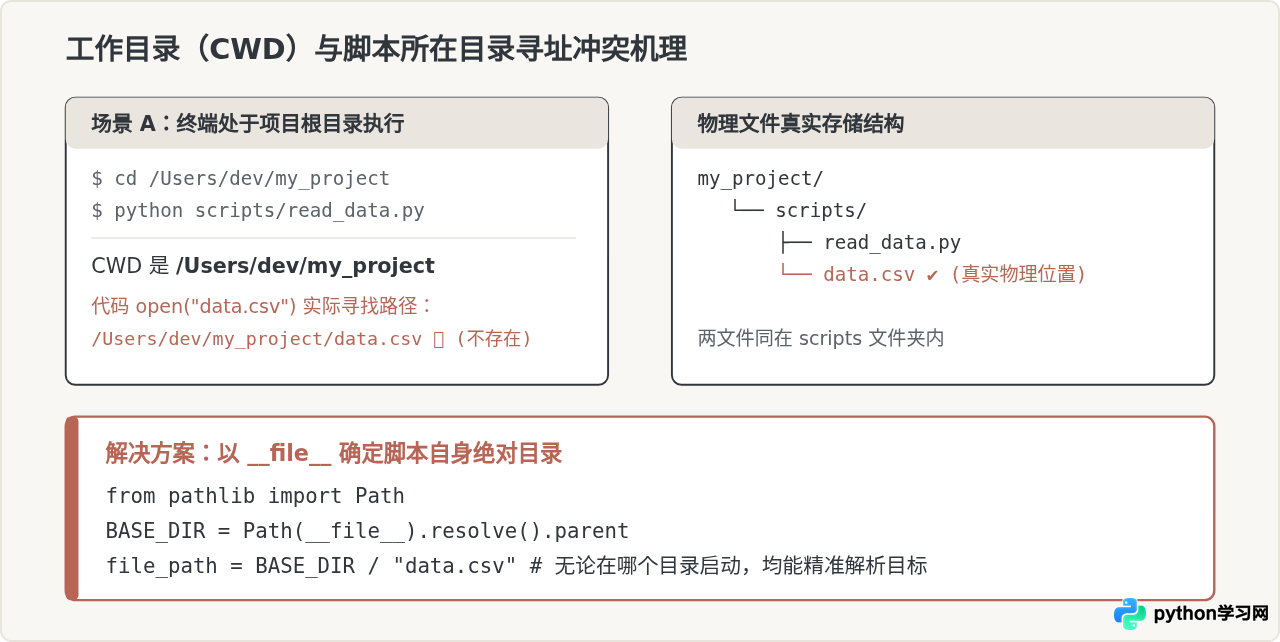
验证当前工作目录的方法非常直接。在调用 open() 之前,可以打印出当前工作目录进行核对:
import os
from pathlib import Path

# 查看当前终端工作目录
print("当前工作目录为:", os.getcwd())
# 或者使用 pathlib
print("当前工作目录为:", Path.cwd())
如果打印出的路径并非数据文件所在的文件夹,那么直接传入文件名必然触发 FileNotFoundError。
三、诱因二:文件名拼写、扩展名隐藏与大小写
当路径确认无误但依然报错时,通常是文件命名细节上出现了偏差。常见情况包括:
- Windows 下隐藏已知文件类型的扩展名:系统默认会隐藏
.txt等扩展名。用户在资源管理器中新建文件并命名为data.txt,其实际完整全名已变为data.txt.txt。在 Python 中以open("data.txt")打开自然会提示找不到文件。 - 操作系统的文件名大小写敏感性:在 Linux 和 macOS(默认 APFS 分区通常区分大小写)服务器上,
Report.csv与report.csv是两个完全独立的文件。如果开发在 Windows(不敏感)上完成,部署到 Linux 服务器时就容易出现该异常。 - 文件名首尾包含不可见空格:手动重命名文件时,偶然按下的前导或尾随空格会导致实际名称为
"test .json",代码使用"test.json"将无法命中。
验证技巧:可以在脚本中列出目标目录下的全部文件真实名称进行逐一对比:print(os.listdir(Path(__file__).parent)),以此迅速识别双重后缀或首尾空格。
四、诱因三:Windows 反斜杠转义灾难
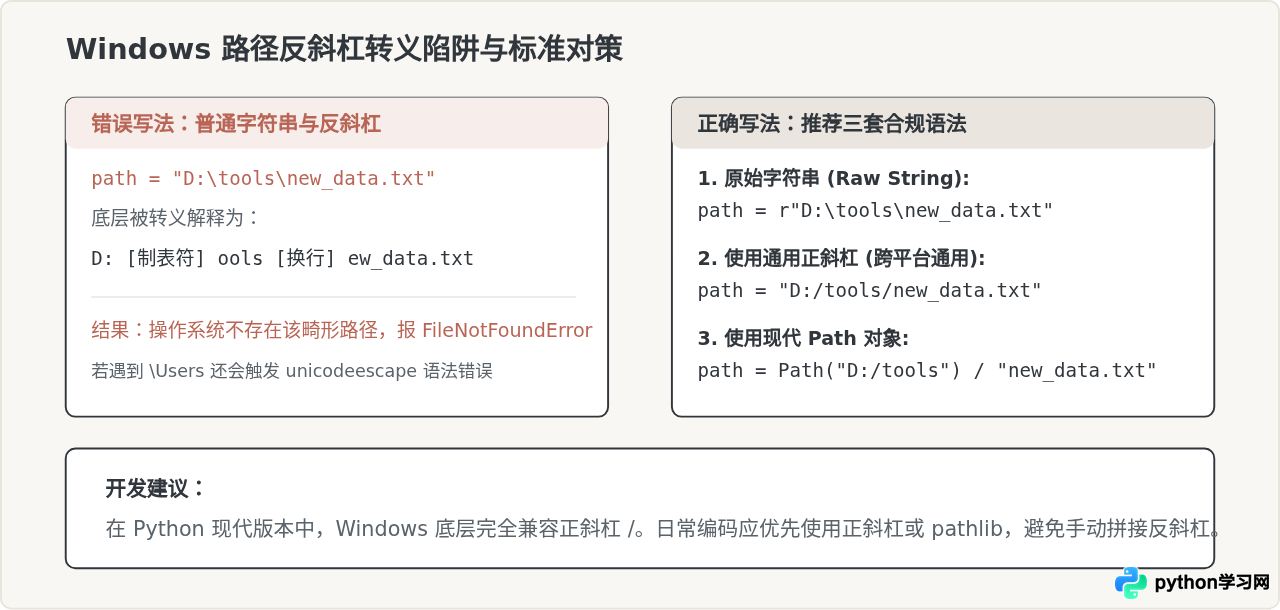
在 Windows 环境下,文件路径使用反斜杠 \ 作为层级分隔符。然而在 Python 字符串字面量中,反斜杠是用于定义转义字符的特殊符号。
例如,若路径写为 "C:\test\new_project\data.txt":
\t会被解析为水平制表符(Tab)\n会被解析为换行符\U或\u会被当成 Unicode 转义前缀,若后继字符不符合十六进制要求甚至会直接抛出SyntaxError
五、诱因四:文件读写模式与父级目录不存在
另一个需要澄清的细节是 open() 的模式参数(Mode):
"r"(默认只读模式):目标文件必须已存在,否则必定抛出FileNotFoundError。"w"/"a"(写入 / 追加模式):若文件名本身不存在,Python 会自动创建该文件;但是,如果指定的路径中包含不存在的中间子文件夹,Python 依然会抛出 FileNotFoundError。
例如以下代码:
# 假设当前目录没有 logs 这个文件夹
with open("logs/output.txt", "w", encoding="utf-8") as f:
    f.write("test")
此时抛出的依然是 FileNotFoundError: [Errno 2] No such file or directory: 'logs/output.txt',其原因是操作系统无法在不存在的父目录 logs 下创建新文件。正确的做法是在写入前确保父目录已创建:
from pathlib import Path

target_file = Path("logs/output.txt")
# 自动递归创建上级目录(如果不存在),存在则忽略
target_file.parent.mkdir(parents=True, exist_ok=True)

with open(target_file, "w", encoding="utf-8") as f:
    f.write("test")
六、现代标准解法:使用 pathlib 构建健壮路径
自 Python 3.4 引入 pathlib 模块后,面向对象的路径处理已成为官方推荐的标准实践。使用 pathlib 能够一次性解决工作目录不一致、系统斜杠差异和父目录创建问题:
from pathlib import Path

# 1. 获取当前脚本文件的真实物理绝对目录
SCRIPT_DIR = Path(__file__).resolve().parent

# 2. 通过 / 运算符安全拼接子目录与文件名
data_path = SCRIPT_DIR / "data" / "user_info.json"

# 3. 读取文件:可直接使用 Path.open 或 Path.read_text
try:
    with data_path.open("r", encoding="utf-8") as f:
        content = f.read()
    print("文件读取成功!")
except FileNotFoundError:
    print(f"未能找到目标文件,尝试检索的绝对路径为: {data_path.resolve()}")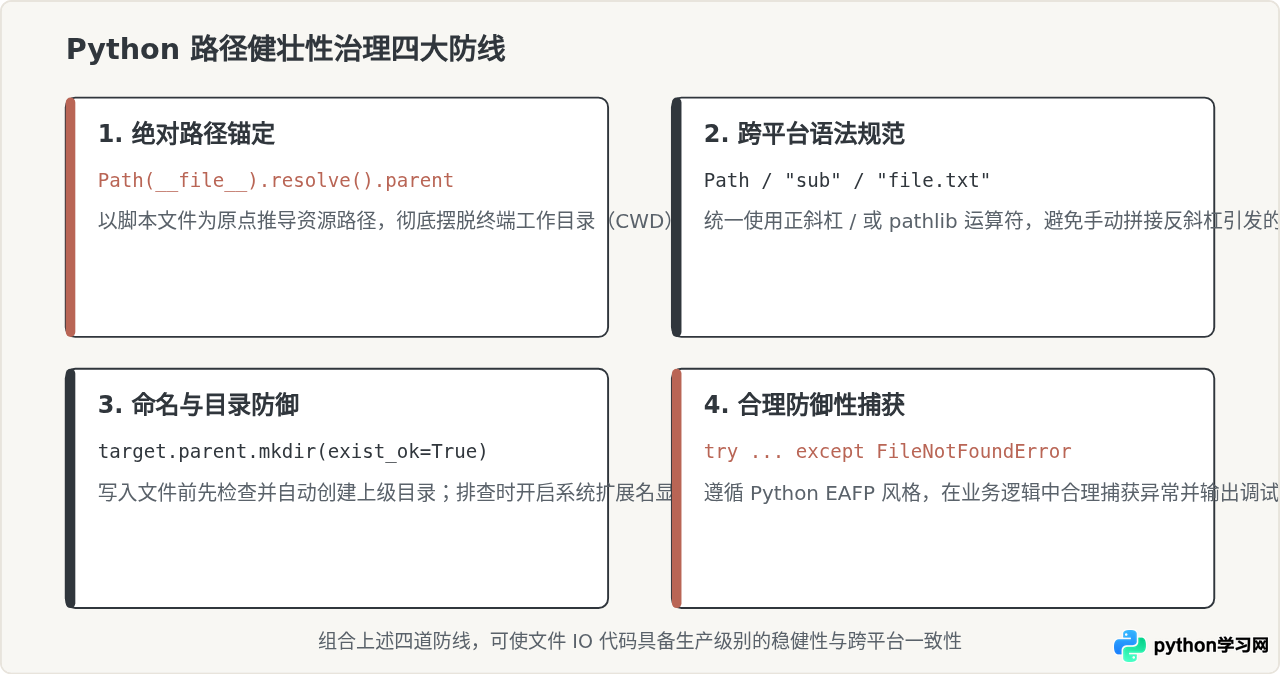
七、预先判断 exists() 与 try-except 的选择
有些开发者习惯在读取前先使用条件判断进行预检:
# 风格一:LBYL (Look Before You Leap)
if file_path.exists():
    with open(file_path, "r", encoding="utf-8") as f:
        data = f.read()
else:
    print("文件不存在")
但在 Python 编程哲学中,官方更推荐遵循 EAFP 原则(Easier to Ask for Forgiveness than Permission,请求宽恕比事先准许更容易):
# 风格二:EAFP (推荐方式)
try:
    with open(file_path, "r", encoding="utf-8") as f:
        data = f.read()
except FileNotFoundError:
    # 可以在此处执行降级逻辑,如创建默认配置文件或提示用户
    print(f"提示:未能找到文件 {file_path}")
采用 try...except 的主要优势在于能够避免竞态条件(Race Condition):在多线程或高并发文件读写中,即使 exists() 检查为真,在执行 open() 的瞬间文件仍有可能被外部程序移动或删除。使用异常捕获机制不仅逻辑更紧凑,而且在面对真实异常时能够给出确切的容错与恢复措施。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















