


Python集合推导式怎么写:快速生成与过滤数据的技巧
在 Python 中,当我们需要从现有数据序列中提取、处理并自动去重生成无序集合时,集合推导式(Set Comprehension)是最直接高效的语法方案。它的基本书写形式为 {expression for item in iterable if condition}。与传统的 for 循环搭配 set.add() 相比,集合推导式不仅代码表达紧凑,而且在底层直接由字节码循环构建底层哈希表,执行速度与内存表现通常更加优异。本文将具体讲解集合推导式的书写结构、执行流程、过滤优化技巧以及日常开发中的关键边界。
一、集合推导式的核心语法与解构
集合推导式外层使用花括号 {} 包裹,与字典类似,但其内部产生的是单一值而不是键值对 key: value。理解其书写方式,关键在于拆解其三大组成单元:生成表达式、遍历循环与可选的条件过滤器。
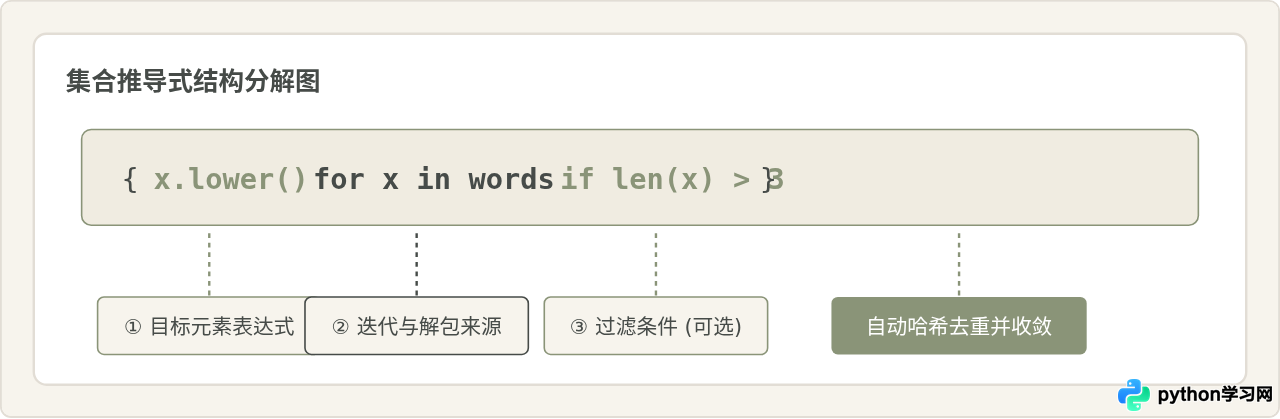
以下为一个基础的代码对照示例。若需要统计一批文本中不同单词的小写形态,传统循环与推导式的写法分别如下:
# 传统循环写法
words = ["Apple", "banana", "APPLE", "orange", "BANANA", "fig"]
unique_words = set()
for w in words:
    if len(w) > 3:
        unique_words.add(w.lower())
# 示例输出: {'banana', 'orange', 'apple'}

# 集合推导式写法
unique_words = {w.lower() for w in words if len(w) > 3}
# 示例输出: {'banana', 'orange', 'apple'}
可以看到,推导式将原本分散在四行中的初始化、遍历、判断与收集逻辑收敛为单条语句,既保持了语义的完整性,又避免了反复调用 unique_words.add() 带来的额外方法查找开销。
二、执行过程推导:从输入流到哈希表
很多初学者以为集合推导式仅仅是把列表推导式的结果套上了一个 set() 函数,但实际上 Python 在字节码层面直接为推导式创建了一个专用的集合构建操作。理解其具体的推导与过滤步骤,有助于写出性能更稳健的代码。
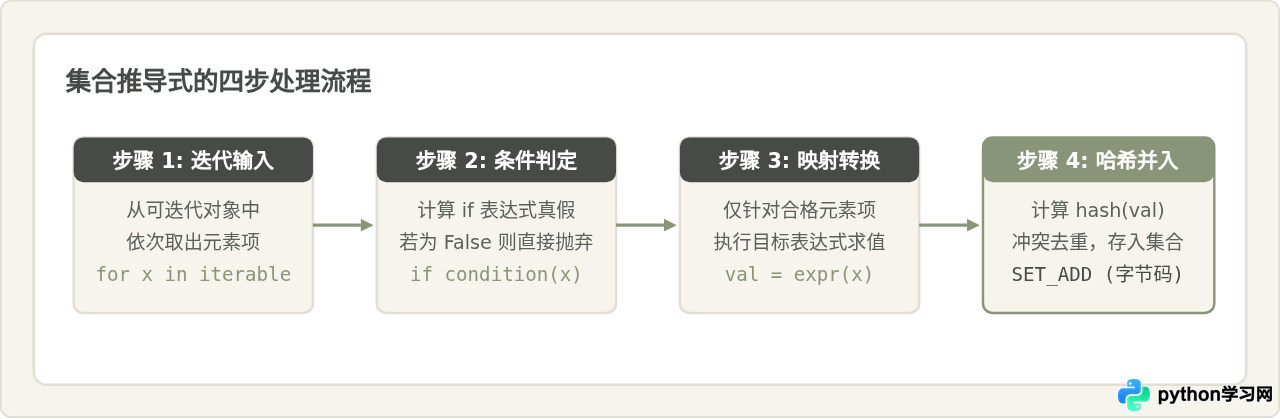
这个执行顺序决定了:任何被 if 条件拦截掉的数据,都不会触发左侧表达式的求值。这一特性非常关键,它允许我们在左侧安全地编写潜在的高耗能或易引发异常的操作,例如除法运算、类型转换或正则提取:
raw_records = ["42", "18", "error", "-5", "100", "invalid", "18"]

# 安全过滤:先检验是否全为数字,再做 int 转换与正数过滤
positive_numbers = {int(s) for s in raw_records if s.lstrip("-").isdigit() and int(s) > 0}
# 示例输出: {18, 42, 100}
三、生成与过滤技巧
1. 多条件组合过滤
在推导式末尾,可以书写复合布尔表达式,或者连续写多个 if 关键字。在 Python 语法中,连续的多个 if 等价于逻辑与(and)关系:
numbers = range(1, 31)

# 写法一:使用 and 连接
evens_div3_a = {x for x in numbers if x % 2 == 0 and x % 3 == 0}

# 写法二:串联两个 if 子句
evens_div3_b = {x for x in numbers if x % 2 == 0 if x % 3 == 0}

# 两个写法完全等价,结果均为: {6, 12, 18, 24, 30}
如果过滤逻辑存在“或”关系(OR),则必须显式使用 or 运算符,不能拆分为两个单独的 if。
2. 嵌套循环与多维展开
当处理二维列表、表格行或嵌套序列时,集合推导式支持嵌套 for 循环。其嵌套书写顺序与多层传统 for 循环完全一致,外层循环在先,内层循环在后:
matrix = [
    ["Python", "Java", "C++"],
    ["Go", "Rust", "Python"],
    ["JavaScript", "TypeScript", "Java"]
]

# 提取所有语言并转换为全小写、去重,仅保留长度大于 3 的项
clean_langs = {lang.lower() for row in matrix for lang in row if len(lang) > 3}
# 示例输出: {'typescript', 'javascript', 'python', 'rust', 'java'}
四、结构对比:集合推导式、列表推导式与生成器
在 Python 语法中,推导式家族有三种极其相似的书写形式,但它们返回的数据结构、去重机制以及内存开销有着本质的区别。清楚认识它们的差异,才能在不同场景下作出恰当的选择。
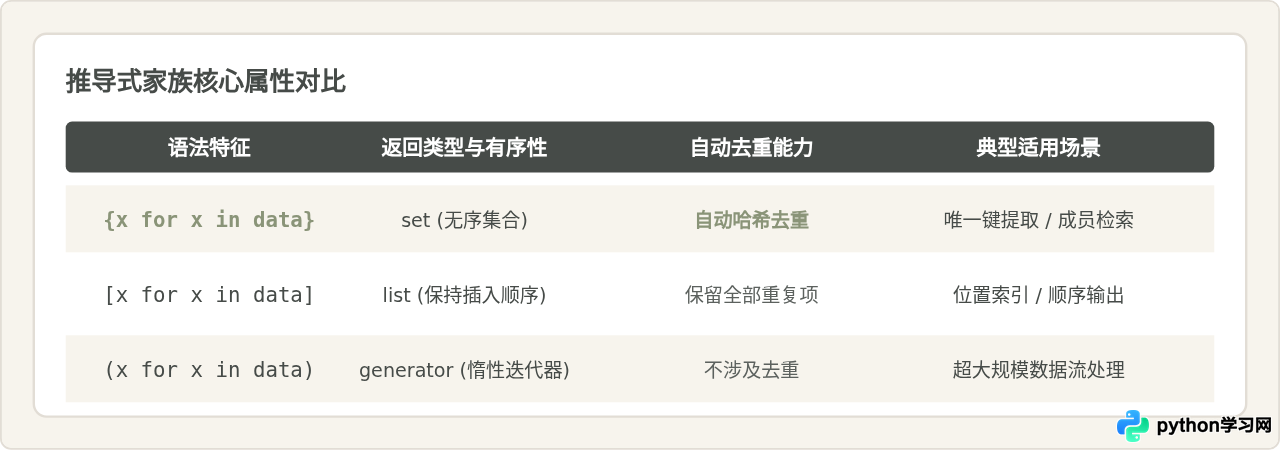
set([x for x in data]) 与 {x for x in data}有些开发者习惯先写一个列表推导式,再用
set(...) 进行包裹。这种写法完全可用,但存在性能缺陷:它必须在内存中完整分配并实例化一个暂存的 list 对象,然后将该列表传递给 set() 构造器重新遍历一遍。直接使用集合推导式 {...},解释器只分配一个集合对象,单次遍历即可完成构建,运行速度更快且节省内存。
五、常见陷阱与使用注意事项
虽然集合推导式使用非常方便,但在实际编写时仍有两个极易踩坑的语法与逻辑边界需要注意:
1. 空集合的初始化陷阱
在推导式中,{} 配合 for 可以正常生成集合。但是在普通赋值中,单独的字面量 empty = {} 创建的是空字典(dict),而非集合。空集合必须明确使用 empty = set() 来创建。虽然推导式内部有循环子句因此不会产生歧义,但在编写条件兜底逻辑时切勿将空字典与空集合混淆。
2. 元素的“可哈希”约束(TypeError: unhashable type)
集合的底层依赖哈希表保证唯一性,因此集合中的所有元素必须是可哈希(Hashable)且不可变的类型(如整数、浮点数、字符串、元组等)。如果在推导式的输出表达式中产生了列表、字典或其他集合,Python 会在运行时抛出异常:
raw_tags = [["python", "code"], ["web", "api"], ["python", "code"]]

# 错误示例:列表不可哈希
# bad_set = {tags for tags in raw_tags}  # 抛出 TypeError: unhashable type: 'list'

# 正确示例:转换为不可变元组后再存入集合
good_set = {tuple(tags) for tags in raw_tags}
# 示例输出: {('web', 'api'), ('python', 'code')}
六、实践总结与决策导图
为帮助你在编码时快速判断何时应使用集合推导式,可以通过以下决策路径进行选择:
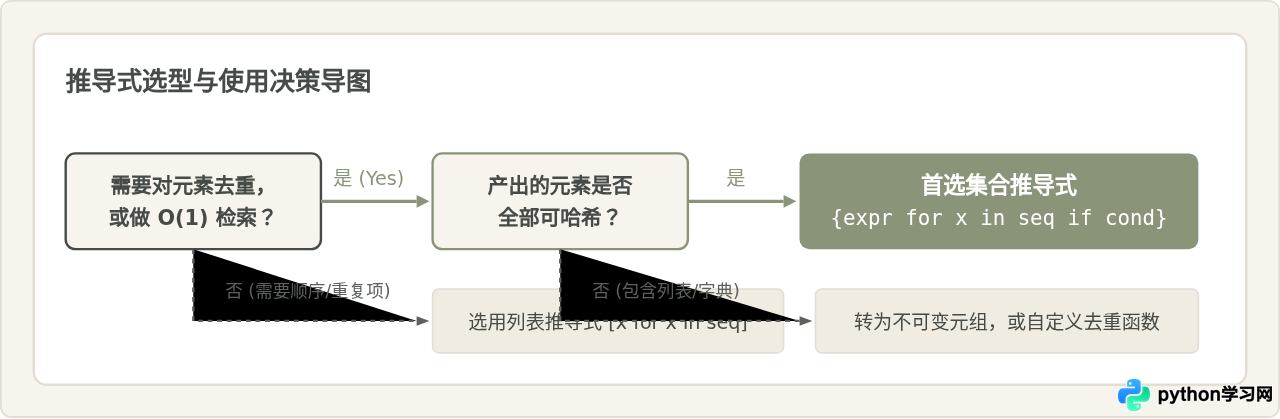
掌握集合推导式的核心并不复杂:记住其基本构造 {目标表达式 for 迭代项 in 数据源 if 过滤条件},利用 if 子句的安全短路特性保护转换表达式,并确保输出的数据项不可变且可哈希。在处理日志去重、标签抽取、关键字收集等现实任务中,集合推导式能够让你的 Python 代码在保证极高执行效率的同时兼具简洁清晰的表达力。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















