


Flask与Django中怎么管理Python数据库连接生命周期
在一台运行着高并发接口的 Web 服务器上,数据库连接日志中突然频繁出现 Too many connections 拒绝接入,或是业务低峰期偶发出现 MySQL server has gone away 异常。这类现象通常并非数据库参数设置不当所致,而是因为应用层对数据库连接的“创建、借出、归还与销毁”生命周期缺少精准把控。掌握 Flask 与 Django 这两个主流 Python 框架如何管理连接生命周期,是保证数据库连接高效复用且避免连接泄漏的核心能力。
一、核心机制差异:Django 的按请求管理与 Flask 的连接池化
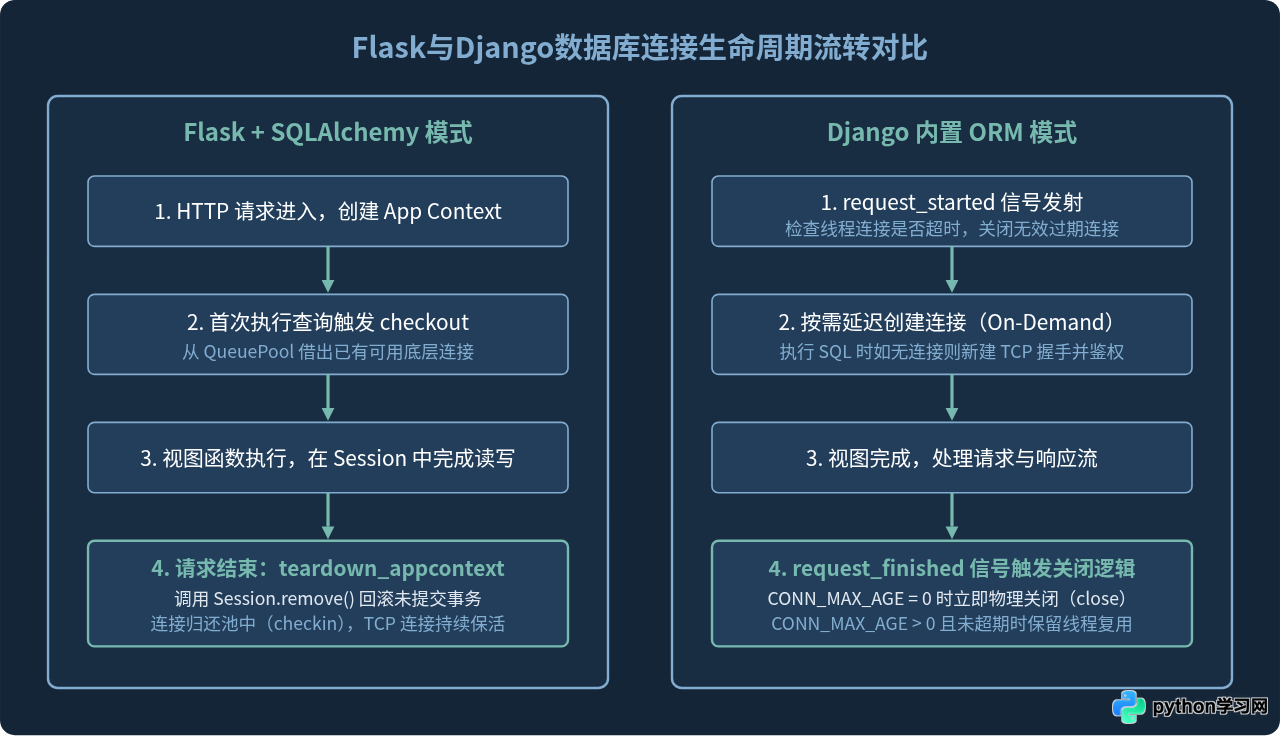
管理数据库连接的本质,是在 TCP 握手开销(频繁新建连接)与数据库连接数上限(连接长期闲置不释放)之间寻找平衡点。Flask 与 Django 在底层的架构设计存在显著区别:Django 内置了完整的 ORM 抽象,连接生命周期与请求-响应信号紧密耦合;而 Flask 作为微框架本身不绑定数据库,通常依赖 SQLAlchemy 等第三方库,通过连接池(Connection Pool)和应用上下文生命周期勾子来协同管理。
二、Django 中的数据库连接生命周期配置与优化
Django 的连接管理机制属于“单线程独占”模型,存储在 django.db.connections 映射中,每个线程在访问数据库时拥有属于自己的连接实例。
1. 默认行为(CONN_MAX_AGE = 0)
在默认设置下,CONN_MAX_AGE 值为 0。其生命周期表现为:
- 建立时机:不是在请求进入时,而是在当前请求第一次执行 ORM 操作或原生 SQL 查询时按需(Lazy Connection)建立。
- 关闭时机:当视图返回响应,Django 核心调度器发射
request_finished信号,信号接收器close_old_connections()会直接关闭该连接,执行实际的 TCP 断开动作。
这种模式适用于并发度较低或单个请求处理耗时极长的环境,绝不会出现连接滞留,但当 QPS 升高时,每个请求都产生一次 TCP 握手与数据库鉴权开销,数据库 CPU 会大量消耗在连接建立上。
2. 启用长连接复用(CONN_MAX_AGE > 0)
要降低频繁握手开销,可在 settings.py 中为相应数据库指定持久存活周期(单位为秒):
# settings.py
DATABASES = {
    'default': {
        'ENGINE': 'django.db.backends.postgresql',
        'NAME': 'production_db',
        'USER': 'db_user',
        'PASSWORD': 'secret_password',
        'HOST': '127.0.0.1',
        'PORT': '5432',
        'CONN_MAX_AGE': 60,  # 允许单个连接在当前线程内复用 60 秒
    }
}
开启后的关键生命周期改变:
- 在请求结束发出
request_finished时,Django 计算该连接的已存活时间。若未达到CONN_MAX_AGE,该连接保持打开,留给该线程后续接收的请求复用。 - 在下一个请求进入发出
request_started时,以及请求结束时,Django 会调用close_old_connections(),若发现连接已超过CONN_MAX_AGE秒,或者数据库服务端已单方面断开,则主动将其关闭并清理引用,下次查询时重新建连。
三、Flask(结合 SQLAlchemy)中的数据库连接池生命周期
Flask 开发中普遍使用 SQLAlchemy。SQLAlchemy 的连接架构分为三层:Engine(持有底层连接池 Connection Pool)、Connection(具体数据库物理连接的封装)、Session(ORM 会话与事务单元)。
1. scoped_session 与 teardown_appcontext
Flask 自身没有全局请求信号来处理 ORM,因此需要借助 teardown_appcontext。如果使用 Flask-SQLAlchemy 扩展,其内部已自动注入该逻辑;若是自行封装 SQLAlchemy,必须手动绑定以保证每次请求结束将连接归还至连接池:
from flask import Flask
from sqlalchemy import create_engine
from sqlalchemy.orm import scoped_session, sessionmaker

app = Flask(__name__)

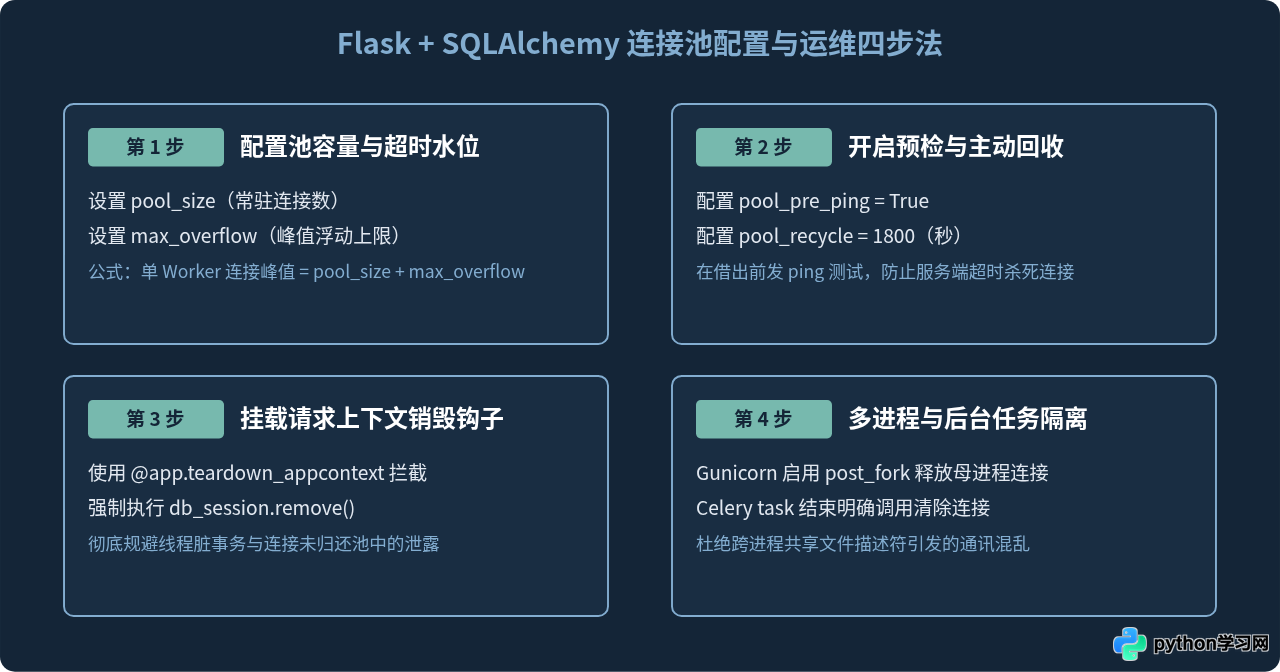
engine = create_engine(
    "postgresql://user:password@localhost/dbname",
    pool_size=10,          # 连接池维持的基础连接数
    max_overflow=20,       # 突发流量时允许额外创建的连接上限
    pool_timeout=30,       # 获取连接等待超时时间(秒)
    pool_recycle=1800,     # 连接存活 30 分钟后自动销毁重建,早于数据库 wait_timeout
    pool_pre_ping=True     # 每次借出前执行 SELECT 1 探活
)

SessionLocal = scoped_session(sessionmaker(autocommit=False, autoflush=False, bind=engine))

@app.teardown_appcontext
def shutdown_session(exception=None):
    # 核心动作:关闭当前线程绑定的 Session,清理事务,并将 Connection 归还给 QueuePool
    SessionLocal.remove()
SessionLocal.remove() 的关键意义在于:它并非关闭底层 socket,而是把借出的连接归还(checkin)到底层 QueuePool,并清除当前线程作用域内的缓存对象。如果不执行该操作,该线程将一直占用连接,导致连接池耗尽抛出 TimeoutError: QueuePool limit of size 10 overflow 20 reached。
四、跨进程部署(Gunicorn/uWSGI)与异步任务中的连接生命周期隔离
在生产环境中,Python 应用大多采用预派生(Pre-fork)模式启动(例如 Gunicorn、uWSGI),或者配合 Celery 消费异步任务。在此类场景中,连接生命周期如果管理不当,极易出现跨进程文件描述符共享冲突。
1. Gunicorn Pre-fork 陷阱与 post_fork 应对
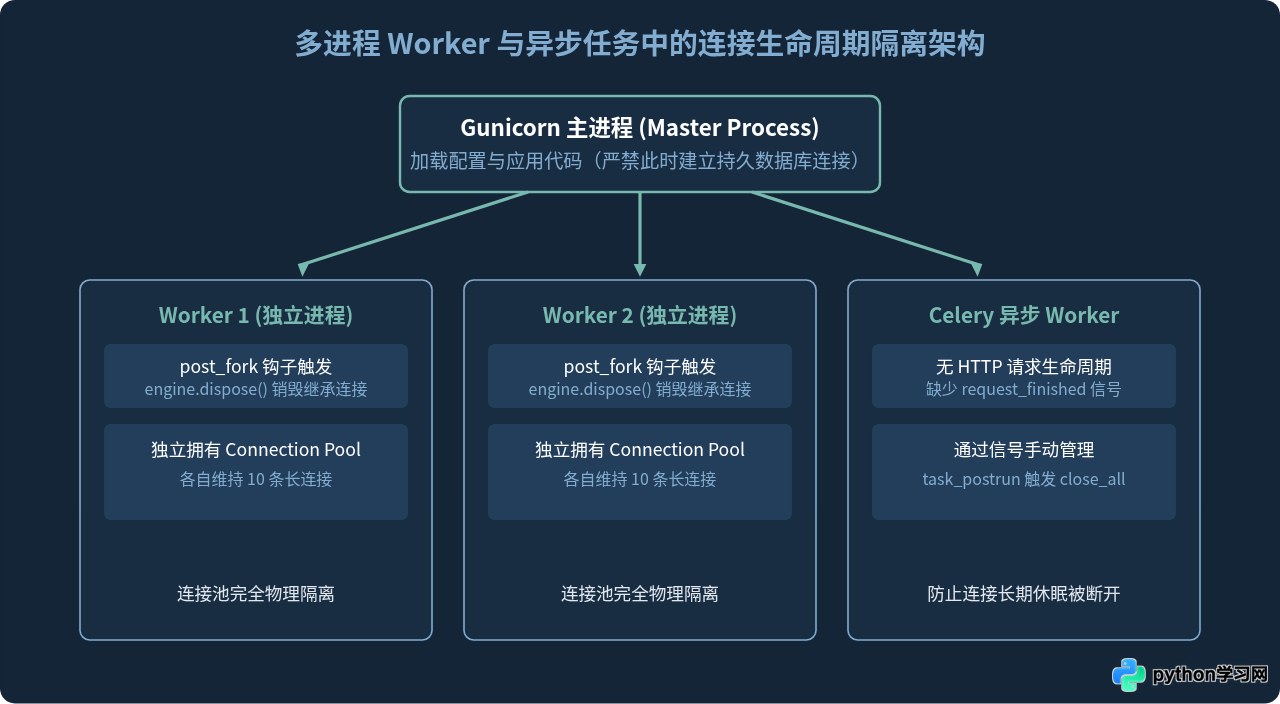
当 Gunicorn 以 --preload 模式启动时,主进程会先加载 Python 应用代码。若此时建立了数据库连接,随后的 os.fork() 会将套接字文件描述符复制给所有子 Worker,导致多个子进程同时使用相同的 TCP 连接向数据库读写数据,造成报文乱序与严重崩溃。解决方法是在 Gunicorn 配置中重置连接:
# gunicorn.conf.py
def post_fork(server, worker):
    # 子进程派生后立即触发
    # 对 Flask + SQLAlchemy:清空从主进程继承的连接池
    from my_flask_app import engine
    engine.dispose()
调用 engine.dispose() 不会影响母进程,它会将子进程内的现有连接池直接注销,使子进程在首次处理外部请求时重新创建属于自己私有的数据库连接。
2. Celery 异步任务中的生命周期管理
Celery Worker 执行任务属于常驻后台进程,不经历 Web 请求的生命周期。如果在 Celery 中直接导入 Django 或 Flask 的模型:
- 在 Django 中:由于没有 Web 请求,
request_started和request_finished信号不会被触发。长时间闲置的 Celery Worker 持有的连接会被数据库的wait_timeout单方面切断,下次任务执行时报OperationalError: (2006, 'MySQL server has gone away')。 - 解决办法:利用 Celery 的任务信号,在任务执行后主动关闭连接:
from celery.signals import task_postrun
from django.db import connections

@task_postrun.connect
def close_db_connections(**kwargs):
    # 任务完成后立即关闭当前任务线程持有的所有数据库连接
    connections.close_all()
五、参数调优与故障排查决策
理解连接生命周期后,针对高并发与生产环境的稳定性,可以参照以下选型与调优决策表进行排查与规避:
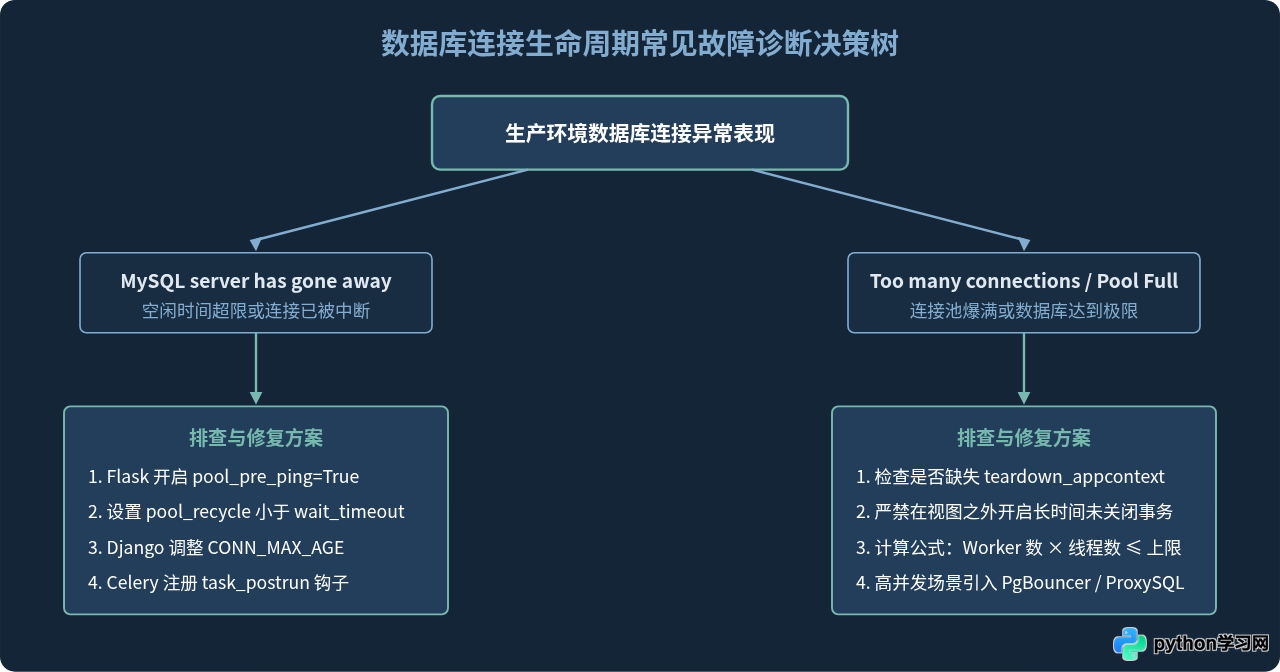
实战建议与选型总结
- 连接复用控制:在 Django 中,如果数据库位于同机房或同一虚拟网络,将
CONN_MAX_AGE设置为 30 到 120 秒,可以减少大约 60% 至 80% 的建连网络开销;但如果业务使用 Gunicorn 多进程部署且 Worker 数量较多(如 32 个 Worker),将CONN_MAX_AGE设为过大可能导致空闲连接常驻不降,这时必须计算Worker 数 × 线程数,确保其低于数据库的最大连接上限。 - 连接池探活(pre-ping):在 Flask + SQLAlchemy 体系中,务必设置
pool_pre_ping=True。虽然在借出连接时会额外产生一次微小的SELECT 1开销,但能彻底杜绝因网络闪断、数据库自动重启或云厂商 NAT 超时而造成的 500 错误。 - 长事务隔离:数据库连接归还连接池的前提是当前事务已结束。在编写包含第三方外部 API 调用、耗时文件写入的视图函数时,绝不能将外部 IO 操作包裹在数据库事务中,否则连接会被该请求持续占有,造成整个连接池阻塞排队。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















