


Python 3 asyncio任务并发控制:gather、wait与信号量
asyncio.gather、asyncio.wait 与 asyncio.Semaphore 三个核心工具,系统解析它们的运作机制、异常行为、代码实现及选型策略。
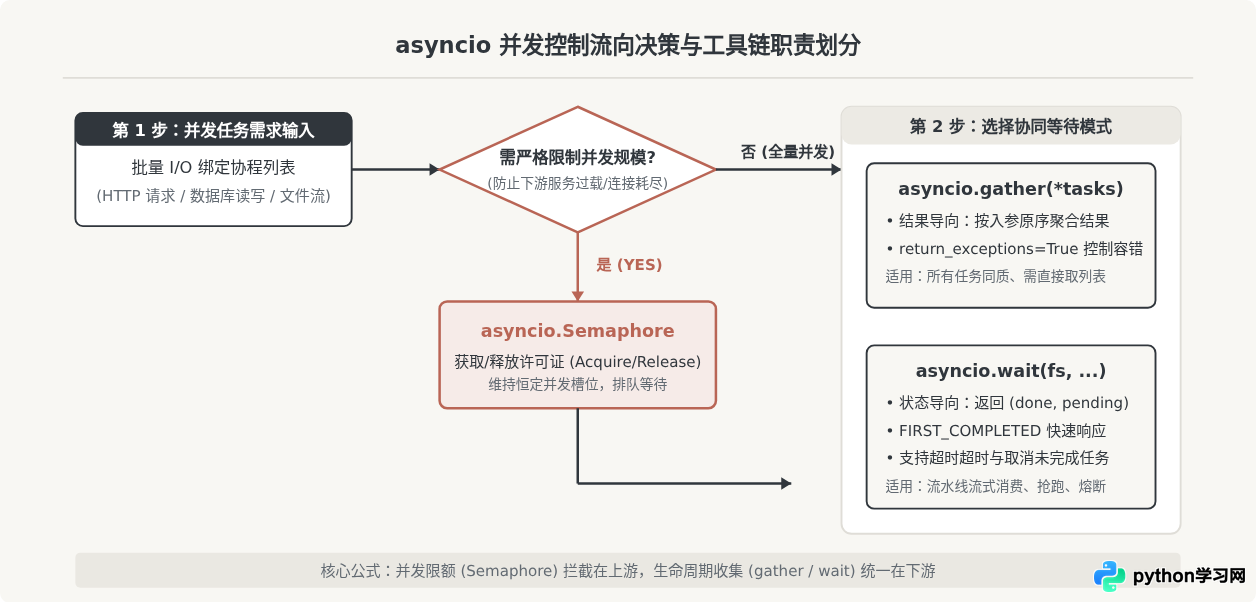
一、asyncio.gather:以“结果汇聚”为中心的并发聚合
asyncio.gather 是异步任务调度中使用频次最高的高层 API。它的核心设计目标非常纯粹:接收一组可等待对象(协程或 Task),并发调度并在全部任务执行完毕后,按照入参顺序完整返回各任务的返回值列表。
1. 运作特性与顺序保证
并发执行并不意味着执行时间完全一致。如果任务 2 比任务 1 先完成,gather 会在内部缓冲任务 2 的结果,直到所有被等待的对象都产出数据后,严格按照 [task1_result, task2_result, ...] 的原始排列输出。这种契约极大地减少了调用方重排结果的复杂度。
2. 异常处理机制与 return_exceptions 参数
asyncio.gather 默认参数为 return_exceptions=False。在此模式下,一旦其中某一个任务抛出异常,gather 会立即将该异常向外抛出。需要格外注意的是:抛出异常并不代表其他未完成的任务被自动取消。未完成的任务仍然会在事件循环中继续静默运行,这往往会导致资源泄漏或难以察觉的副作用。
若希望任务互相隔离、单点失败不影响整体汇总,必须显式指定 return_exceptions=True。此时异常对象会被视作一种合法的返回值存入结果列表,调用端通过 isinstance(res, Exception) 进行筛选与降级。
import asyncio

async def fetch_api(source_id: int, delay: float, fail: bool = False):
    await asyncio.sleep(delay)
    if fail:
        raise ValueError(f"数据源 {source_id} 响应超时或校验失败")
    return {"source": source_id, "data": f"content_{source_id}"}

async def main():
    # 模拟三个数据源并发读取
    coros = [
        fetch_api(1, 0.2),
        fetch_api(2, 0.1, fail=True),
        fetch_api(3, 0.3),
    ]

    # return_exceptions=True 确保单个异常不中断其他任务获取
    results = await asyncio.gather(*coros, return_exceptions=True)

    for idx, item in enumerate(results, start=1):
        if isinstance(item, Exception):
            print(f"[错误记录] 数据源 {idx} 异常: {item}")
        else:
            print(f"[成功抓取] 数据源 {idx} 返回: {item}")

if __name__ == "__main__":
asyncio.run(main())asyncio.gather 本身并不提供并发数量限制功能。如果你直接使用 *tasks 解包传入 10,000 个 HTTP 请求任务,事件循环会瞬间在同一轮迭代中初始化并激活所有任务,导致操作系统文件描述符耗尽或远程服务器直接拒绝连接。
二、asyncio.wait:以“状态变更”为中心的细粒度生命周期管理
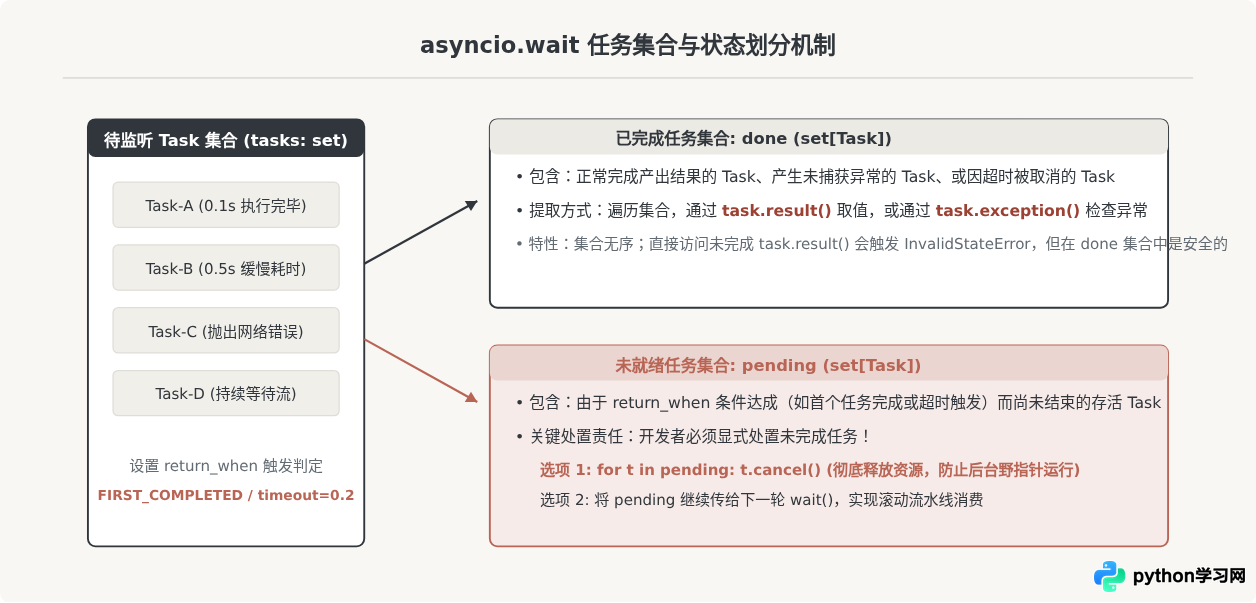
与 gather 专注收集最终值不同,asyncio.wait 是偏向底层状态观测的控制工具。它接收一个 Task 集合(从 Python 3.8 起,必须显式传递 Task 或 Future 集合),并返回一个元组 (done, pending)。
1. return_when 控制触发条件
asyncio.wait 的核心控制力来自于 return_when 参数,该参数支持以下三种常量:
asyncio.ALL_COMPLETED(默认值):等待集合中所有任务全部结束才返回。与gather类似,但返回的是(done, pending)集合,且无序。asyncio.FIRST_COMPLETED:只要集合中任意一个任务执行完毕或抛出异常,立即返回。此时done集合中至少包含一个任务,其余仍在执行的任务归入pending。asyncio.FIRST_EXCEPTION:当任意一个任务抛出未捕获异常时立即返回;若所有任务均正常执行,则效果等价于ALL_COMPLETED。适合需要快速熔断、一处报错即停止等待的场景。
2. 实战:基于 FIRST_COMPLETED 构建动态流水线
当任务数量庞大或处理耗时不均匀时,我们往往不希望阻塞等待整个批次结束,而是希望“完成一个、处理一个,并及时补充新任务”。通过 FIRST_COMPLETED 配合循环,可以实现高度弹性的流水线处理:
import asyncio
import random

async def worker(task_id: int):
    cost = random.uniform(0.1, 0.4)
    await asyncio.sleep(cost)
    return f"任务 {task_id} 处理完毕 (耗时 {cost:.2f}s)"

async def dynamic_pipeline(task_ids: list[int], max_concurrent: int):
    # 将首批任务封装为 Task
    pending = {asyncio.create_task(worker(tid)) for tid in task_ids[:max_concurrent]}
    remaining_ids = task_ids[max_concurrent:]

    while pending:
        # 当有任何一个任务完成时立即唤醒
        done, pending = await asyncio.wait(pending, return_when=asyncio.FIRST_COMPLETED)

        for finished_task in done:
            result = finished_task.result()
            print(f"[消费成果] {result}")

            # 动态填充新任务进流水线
            if remaining_ids:
                new_id = remaining_ids.pop(0)
                pending.add(asyncio.create_task(worker(new_id)))

if __name__ == "__main__":
    asyncio.run(dynamic_pipeline(list(range(1, 9)), max_concurrent=3))
三、asyncio.Semaphore:保护底层资源的并发信号量
无论是 gather 还是 wait,其职责均落在“任务产生后的调度与收集”。如果同时向网络或数据库抛出数千个协程,哪怕最终能被收集,瞬时的并发连接数也会将服务端连接池或本地 socket 端口打爆。
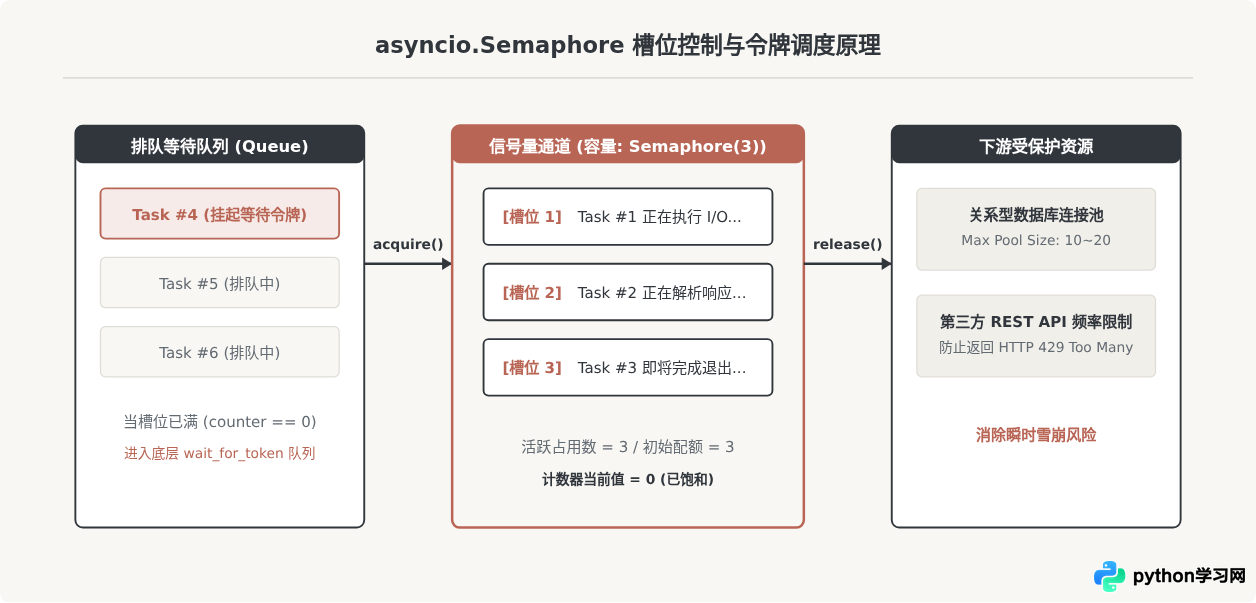
asyncio.Semaphore(信号量)用于从入口处限制并发协程的执行数量。它的内部维护着一个初始整型计数器:
- 进入临界区前调用
await sem.acquire():若计数器大于 0,计数减 1 并立即放行;若计数器为 0,当前协程被挂起并进入等待队列。 - 离开临界区后调用
sem.release():计数器加 1,并唤醒等待队列头部的下一个协程。 - 通常使用
async with semaphore:上下文管理器,确保发生异常时也能正确释放计数器,防止资源死锁。
四、工程实战:Semaphore 与 gather 组合模式
在实际生产环境中,最稳健的并发模型往往是将 asyncio.Semaphore 与 asyncio.gather 组合使用。这种模式将“限制并发连接数”与“保持结果顺序汇聚”两种需求完美解耦。
import asyncio
import time

async def bounded_request(sem: asyncio.Semaphore, item_id: int):
    # 使用上下文管理器自动调用 acquire() 与 release()
    async with sem:
        print(f"[{time.strftime('%X')}] 任务 {item_id} 获得令牌,开始发送网络请求...")
        await asyncio.sleep(0.5)  # 模拟网络延迟
        return f"item_{item_id}_data"

async def main():
    # 设定全局最大并发槽位数为 3
    sem = asyncio.Semaphore(3)

    # 模拟准备抓取 9 个资源
    tasks = [bounded_request(sem, i) for i in range(1, 10)]

    # gather 负责聚合,而内部的 sem 保证任何时刻并发数 <= 3
    start = time.perf_counter()
    results = await asyncio.gather(*tasks)
    elapsed = time.perf_counter() - start

    print(f"\n全部抓取完成!共收集 {len(results)} 条记录,总耗时: {elapsed:.2f}s")

if __name__ == "__main__":
    asyncio.run(main())
在上述代码中,尽管通过 gather 一次性注册了 9 个任务,但由于 async with sem 的卡口拦截,每批仅允许 3 个协程进入睡眠(模拟网络请求)状态,剩余 6 个协程优雅地排队等待前序任务执行完毕。总耗时约为 1.5 秒(3 批 × 0.5 秒),平稳地保护了下游服务。
五、全维度对比与选型指南
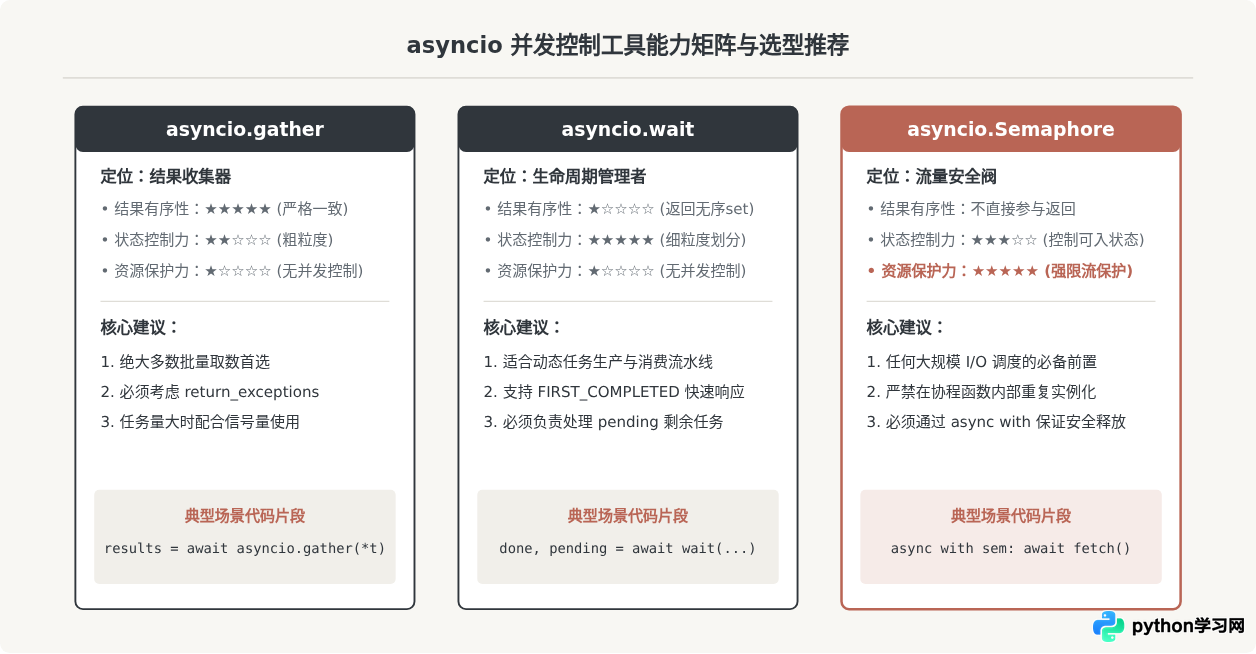
为帮助在实际项目中做出准确判断,以下表格与图表整理了这三个核心工具在功能维度的差异与典型选型场景:
| 对比维度 | asyncio.gather | asyncio.wait | asyncio.Semaphore |
|---|---|---|---|
| 设计核心 | 聚合结果列表 | 监控任务状态变更 | 控制活跃并发上限 |
| 返回形式 | 按传入顺序的 list |
无序的 (done, pending) 元组 |
无返回值(通过上下文管理) |
| 并发限流能力 | 无(全量激活) | 无(全量激活) | 有(计数器精确限制) |
| 提前退出/超时 | 不支持部分提前返回 | 支持(FIRST_COMPLETED) | 不适用 |
| 异常处理 | return_exceptions=True/False |
逐个检查 task.exception() |
异常时自动在 __aexit__ 中释放 |
| 典型应用场景 | 静态批量接口请求、多组件装配 | 动态流水线消费、带超时的抢跑任务 | 爬虫并发限流、数据库连接池保护 |
六、常见工程隐患与避坑要点
-
Semaphore 对象生命周期错误:
切勿在被调用的工作协程函数内部创建
sem = asyncio.Semaphore(10)。每次调用都会生成全新的计数器,完全失去跨协程排队限流的意义。信号量必须在外部初始化一次,并以参数形式注入到各协程中,或封装在单例类中共享。 -
忽视 pending 任务的协程泄漏:
当使用
asyncio.wait(..., return_when=FIRST_COMPLETED)时,返回的pending集合中的任务仍在继续运行。如果后续代码不再关心这些任务,必须显式调用task.cancel()并进行适当的异常收尾(如捕获CancelledError),否则后台未终结的协程会造成网络句柄与内存泄漏。 -
gather 异常吞没陷阱:
设置
return_exceptions=True后,gather不会向外抛出任何异常。如果调用者遍历结果时未编写类型检查分支,直接当作字典或对象解构,会将原本清晰的逻辑错误转化为后续链路的TypeError或AttributeError,增加排错成本。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















