


Python数据库连接池常见报错排查:连接泄露与超时处理
在Python后端与数据管道服务中,数据库连接池承担着复用底层TCP套接字、平抑瞬间并发峰值、降低握手开销的核心任务。然而,当服务承载量攀升或业务代码出现未受控分支时,QueuePool limit of size N reached 或 OperationalError: (2006, 'MySQL server has gone away') 等报错便会频繁浮现。处理这两类问题的根本路径只有两条:一是杜绝“借出未归还”的连接泄露,二是精确协调客户端连接池生命周期与数据库服务端超时断开规则。本文将围绕这两个核心故障展开端到端的原因剖析、抓包排查与工程修复方案。
一、连接池工作机制与生命周期状态模型
理解连接池报错的前提,是清晰把握连接在客户端与数据库服务端之间的状态流转。以广泛应用的 SQLAlchemy(基于 QueuePool)或 DBUtils 为例,连接池在内部维护着活跃检出集合、空闲队列与等待排队队列三个逻辑区域。
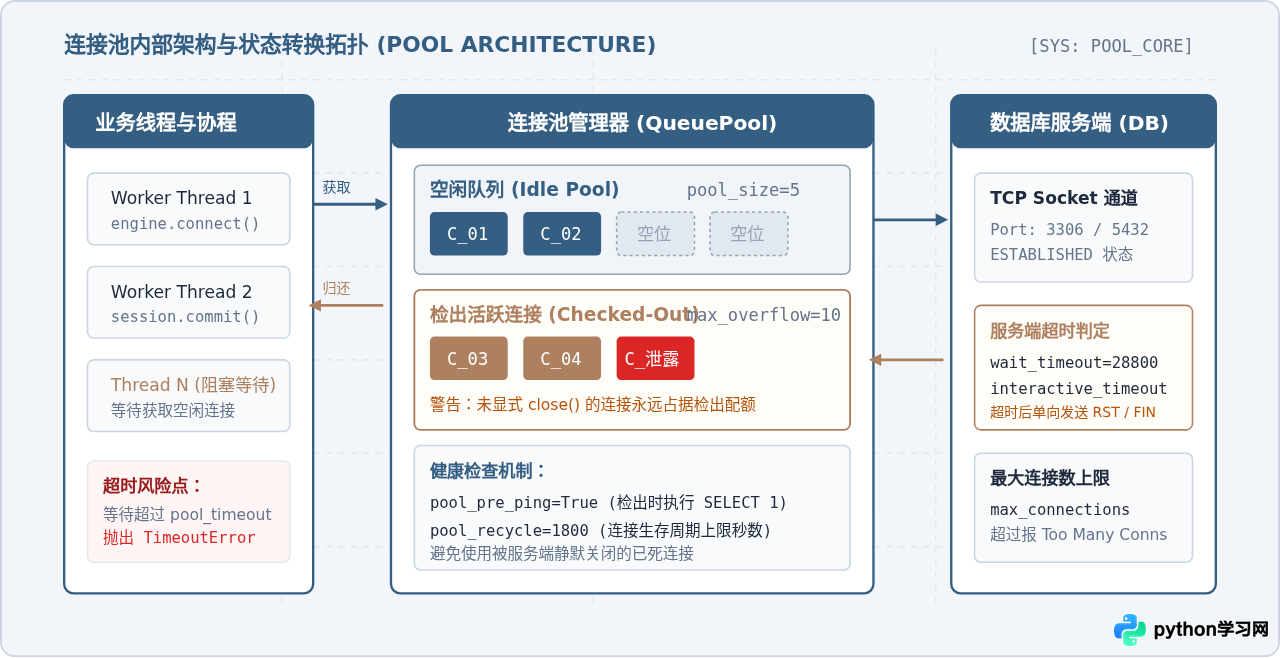
当一个工作线程调用连接方法时,连接池首先检查空闲队列是否有现成连接。若有且连接通过可用性验证,则直接出队交予业务代码;若空闲队列已空,连接池会根据 max_overflow 配置创建临时连接。当连接总量达到 pool_size + max_overflow 阈值后,后续请求线程只能进入阻塞等待状态。如果超过配置的 pool_timeout 仍未有连接归还,便会抛出超时异常。
二、典型报错特征与直接触发诱因
排查故障的第一步,是准确区分报错属于“客户端排队等待超时”还是“服务端主动断开连接”。下表列出了生产环境中最常见的两类报错信息及其技术诱因:
| 错误类型 | 典型异常日志摘要 | 根本诱因 |
|---|---|---|
| 连接池耗尽等待超时 (Pool Exhaustion) |
sqlalchemy.exc.TimeoutError: QueuePool limit of size 5 overflow 10 reached, connection timed out, timeout 30.00 |
存在连接泄露(未执行 close)、并发请求数突破上限,或慢查询导致连接长期被单个线程独占。 |
| 服务端空闲超时断开 (Server Idle Timeout) |
pymysql.err.OperationalError: (2006, 'MySQL server has gone away') 或 psycopg2.OperationalError: SSL SYSCALL error: EOF detected |
连接池中的物理连接闲置时间超过了 MySQL wait_timeout,连接池复用已失效的死连接发起查询。 |
| 连接建立握手超时 (Connect Handshake Timeout) |
OperationalError: (2003, "Can't connect to MySQL server on '...': timed out") |
数据库服务器达到 max_connections,TCP 队列满导致 SYN 包被丢弃,或宿主机网络延迟抖动。 |
三、连接泄露的根因剖析与标准排查四步法
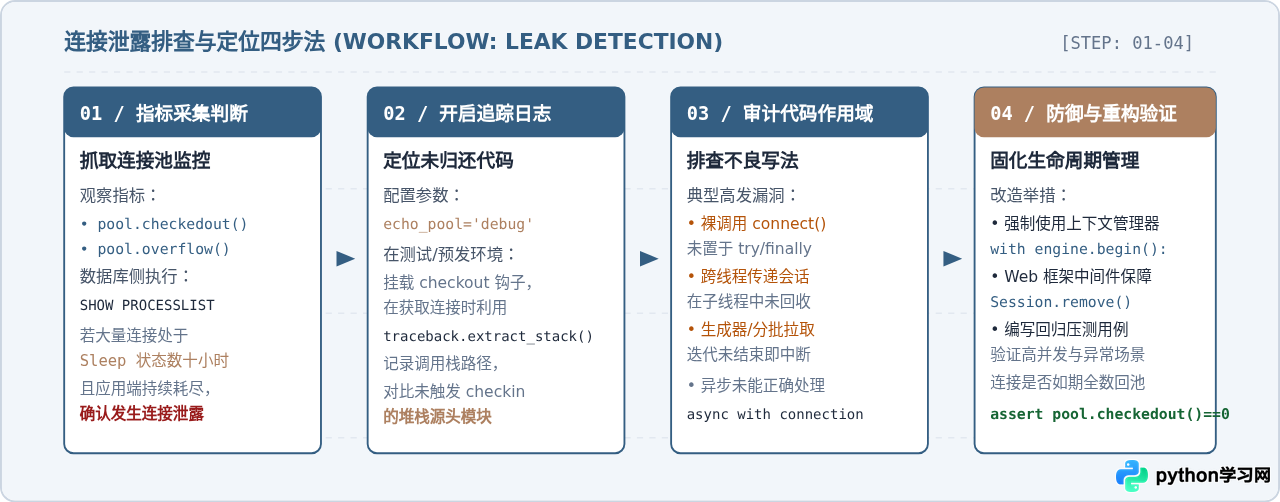
连接泄露是指应用程序从连接池借出连接后,由于异常处理缺失、作用域跨越长周期任务或垃圾回收延迟,导致连接始终处于 Checked-Out 状态,无法回归空闲队列。随着请求累积,连接池容量被不可用的“僵尸连接”完全挤占。
1. 错误代码与正确代码对比
最容易引起泄露的场景是在编写裸查询时发生未经捕获的异常,或是错误理解了 ORM 会话的自动提交行为。下面是一组典型反例与标准做法的对比:
反例(高危泄露):
from sqlalchemy import create_engine

engine = create_engine("mysql+pymysql://user:pwd@host/db", pool_size=5)

def bad_query_example(user_id):
    # 裸调用 connect() 获取连接
    conn = engine.connect()
    # 一旦在数据转换或网络交互中抛出异常,conn.close() 永远不会被执行!
    result = conn.execute("SELECT * FROM users WHERE id = %s", (user_id,))
    data = result.fetchall()
    process_data(data) # 如果此处抛出 ValueError,连接彻底泄露!
    conn.close()
正例(严格受控):
from sqlalchemy import create_engine
from sqlalchemy.orm import sessionmaker, scoped_session

engine = create_engine(
    "mysql+pymysql://user:pwd@host/db",
    pool_size=10,
    max_overflow=20,
    pool_timeout=30
)

# 做法 A:使用 Core 层的上下文管理器(推荐原子操作)
def safe_core_query(user_id):
    # with 块离开时自动调用 conn.close(),即使发生异常也能确保归还
    with engine.connect() as conn:
        result = conn.execute("SELECT * FROM users WHERE id = %s", (user_id,))
        return result.fetchall()

# 做法 B:在 Web 框架(如 Flask/FastAPI)中管理 ORM 会话
SessionFactory = sessionmaker(bind=engine)
ScopedSession = scoped_session(SessionFactory)

def web_request_teardown(exception=None):
    # 在每个 HTTP 请求结束钩子中强制清理线程本地的 Session
    ScopedSession.remove()
在调试复杂的连接池耗尽故障时,可通过监听 SQLAlchemy 的
checkout 事件,将借出连接时的 Python 堆栈(使用 traceback.format_stack())直接绑定到底层 DBAPI 连接对象的属性上。若发生耗尽,打印出所有正在借出状态的连接及其挂载的调用栈,即可在数秒内锁定遗漏 close() 的源头函数。
四、超时异常处理:检出等待与空闲回收的双重策略
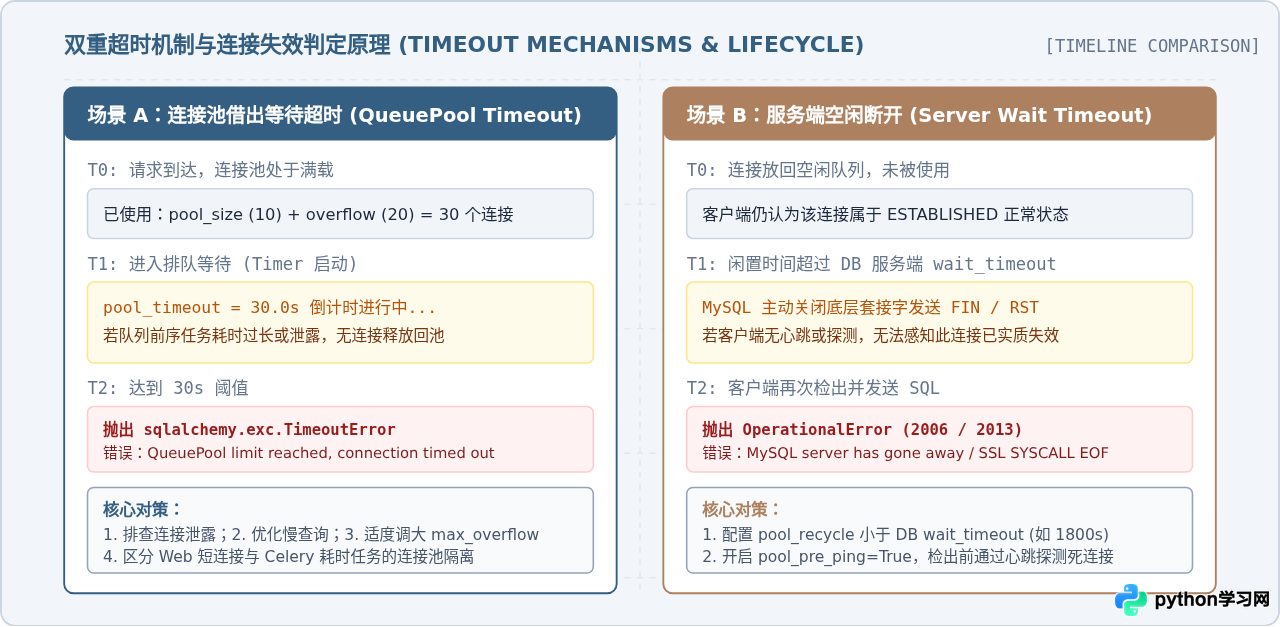
连接池相关的超时报错并非单一原因造成,它主要由两个不同维度的时钟计时器决定:连接池检出等待时钟(Pool Timeout)与服务端连接空闲闲置时钟(Server Wait Timeout)。
1. 解决 MySQL Server Has Gone Away:配置双重防护
在现代 Web 应用中,解决因连接闲置被云数据库、负载均衡器(L4 SLB)或 MySQL 主动终止的最有效做法,是在初始化连接池时组合配置 pool_recycle 与 pool_pre_ping:
from sqlalchemy import create_engine

# 生产级稳健连接池配置模板
engine = create_engine(
    "mysql+pymysql://app_user:StrongPassword@10.0.1.12:3306/production_db",
    # 1. 基础容量设定
    pool_size=15,             # 常驻连接池的核心连接数量
    max_overflow=25,          # 峰值流量允许额外创建的最大瞬时连接
    pool_timeout=20.0,        # 获取连接的最长阻塞等待时间(秒)

    # 2. 空闲失效预防:主动周期性回收
    # 设置为 1800 秒(30分钟),必须明显小于 MySQL 默认的 wait_timeout(通常为 8小时或中间网关的 3600秒)
    pool_recycle=1800,

    # 3. 悲观探测机制:检出前执行快速心跳
    # 每次检出连接时在内部隐式执行 'SELECT 1',若发现套接字已失效则自动丢弃并新建,彻底屏蔽 2006 报错
    pool_pre_ping=True,

    # 4. 可选:启用连接池详细调试(仅排查期开启)
    echo_pool=False
)
pool_pre_ping=True 会在每次调用 connect() 时带来微量开销(一次极简的网络往返),但对于网络偶发中断、主从切换或服务端长闲置断开的防御效果极其显著,是高可用微服务体系中的标准推荐配置。
五、生产环境防御与排查矩阵总结
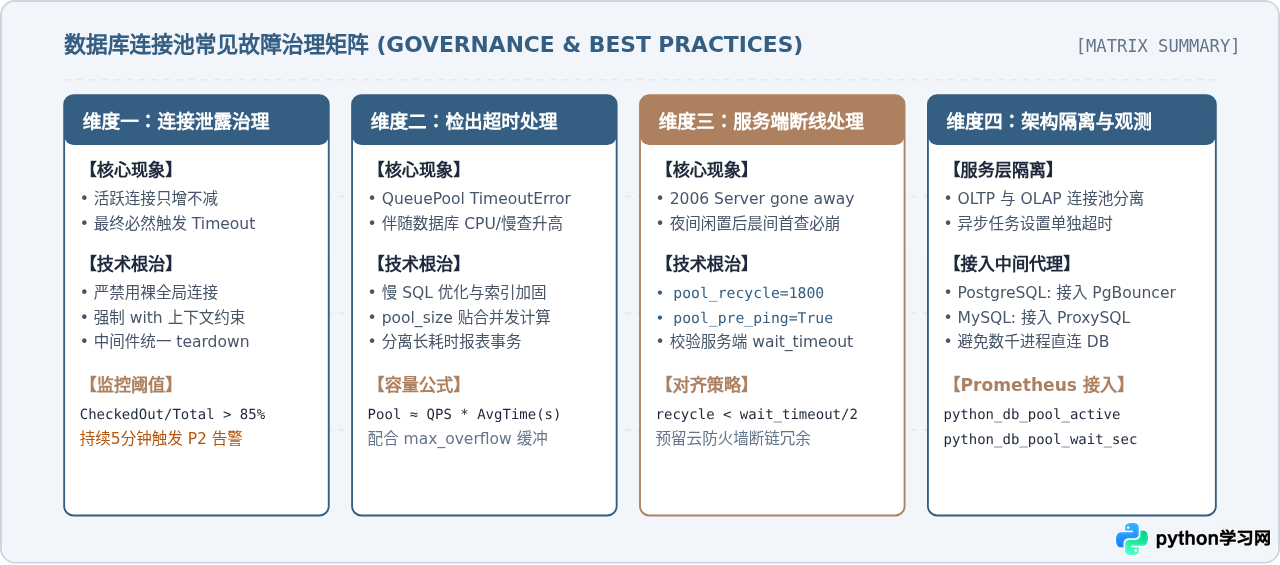
为了让运维与研发团队在遭遇连接池故障时具备体系化的应急手册,下述矩阵图归纳了从错误感知、指标诊断到代码加固的全流程治理方案。
六、总结与落地建议
在 Python 数据库编程中,连接池不是“设置一次即可遗忘”的黑盒组件。绝大多数的连接超时崩溃,其根源都是业务代码对连接作用域的粗放管理与基础设施底层网络策略的不匹配。通过严格规范上下文管理器语法防范连接泄露、开启 pool_pre_ping 与合理缩减 pool_recycle 消除服务端静默断开影响、并配合 Prometheus 指标对检出连接占比建立常态化告警,即可系统性消除绝大部分连接池报错,确保服务在高并发冲击与网络波动下的持续稳健运行。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















