


Python可视化编程工具有哪些?主流低代码与图形化平台盘点
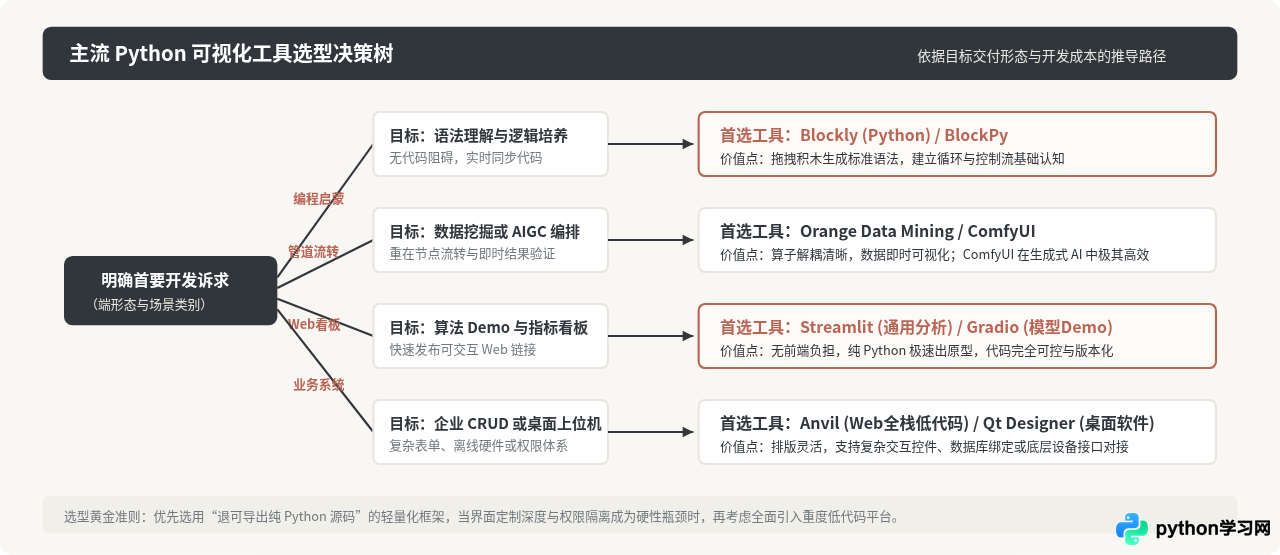
在 Python 技术体系中,“可视化编程”并非单一维度的单一工具,而是覆盖了从儿童编程启蒙、算法模型流转、数据敏捷看板到企业级全栈系统的庞大家族。判断哪款工具适用,核心在于明确你的核心目标是无代码逻辑探索、极速交付可交互界面,还是构建生产级业务软件。本文对当前活跃的主流 Python 可视化与低代码工具进行全景分类盘点,剖析其运行机制、代表工具与工程边界,提供一套接地气的技术选型决策方案。
一、核心分类:四类主流 Python 可视化工具定位与特征
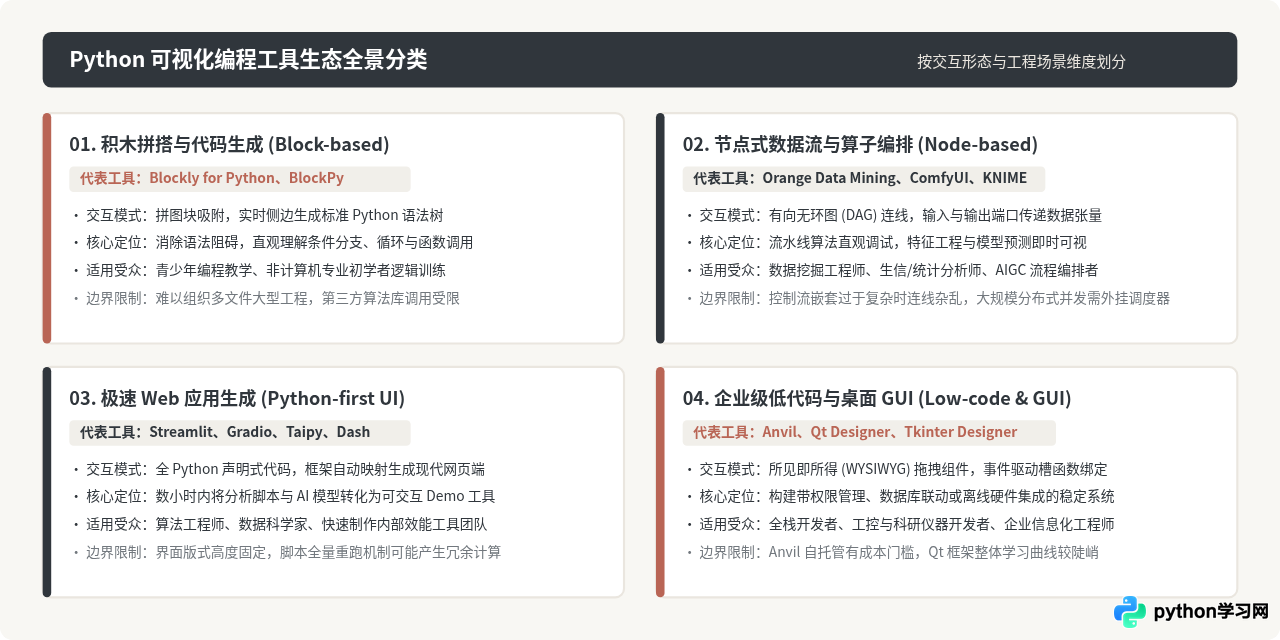
不同于通用前端开发,Python 的低代码与可视化生态高度贴合数据科学与脚本自动化习惯。根据底层逻辑与人机交互形态,主流工具可清晰地划分为四大类别:
- 积木拼搭与图形化代码生成(Block-based & Code-gen):以拖拽拼图模块组织控制流,直观呈现分支、循环与变量,并在后台实时输出合法的 Python 源码。典型代表为 Google Blockly(Python 生成器分支)与 BlockPy。该类工具主要承担教学引导与零基础语法入门职责。
- 节点式数据流与流水线编排(Node-based Dataflow):将算法函数、清洗步骤与数据源抽象为可拖拽的“算子节点”,通过端口连线形成有向无环图(DAG)。典型代表为 Orange Data Mining 与 ComfyUI。适合探索性数据分析、图像处理管道编排等重逻辑、轻前端界面的场景。
- 数据应用与极速 UI 框架(Python-first UI Frameworks):面向具备基础 Python 编码能力但不想折腾 HTML/CSS/JS 的工程师。开发者编写纯 Python 脚本,由框架底层引擎自动生成响应式 Web 界面。典型代表为 Streamlit、Gradio 与 Taipy。
- 企业级全栈可视化低代码与桌面 GUI(Low-code & GUI Builder):具备“所见即所得”(WYSIWYG)设计画布,支持拖拽表单组件并直接绑定后端 Python 数据库读写或事件槽函数。典型代表为 Anvil、Qt Designer 与 Tkinter Designer。
二、主流工具深度剖析:运作机制与能力边界
为了让不同场景下的选型有据可查,以下重点拆解六款具备代表性的主流工具,分析其底层运行逻辑与各自的短板。
1. Streamlit:数据应用与敏捷看板标杆
Streamlit 彻底改变了 Python 原生页面的开发模式。开发者无需设计 REST API,只需在普通 Python 脚本中调用 st.slider()、st.line_chart() 等 API,框架即可自动完成组件状态渲染。
- 运作机制:Streamlit 采用“从上至下执行”(Execution Top-to-Bottom)模型。用户在网页端拖动滑动条或输入文字时,整个 Python 脚本从第一行重新执行一遍,依赖
@st.cache_data装饰器缓存高耗时计算以维持流畅响应。 - 优势:学习成本极低,只要掌握基础 Python 语法,半小时内即可交付交互式报表。
- 短板:页面复杂度上升后,多组件联动下的全脚本重跑机制容易导致非预期刷新;自定义 CSS 样式与深度响应式排版较难介入。
2. Gradio:轻量级 AI 模型与算法交互神器
由 Hugging Face 维护的 Gradio 专注于快速为机器学习模型生成演示原型。它将交互范式高度提炼为“输入组件(Inputs) -> 推理函数(Function) -> 输出组件(Outputs)”。
- 运作机制:开发者定义好推理 Python 函数后,将其传入
gr.Interface(),Gradio 底层自动封装异步 FastAPI 服务并构建对应的前端表单与预览卡片。 - 优势:对音视频、图片上传、流式文本输出(Chatbot)提供原生开箱即用支持,一行代码即可生成跨公网穿透的分享链接。
- 短板:布局组件主要服务于演示验证(Demo),难以承载带角色权限体系、多路由导航的复杂企业级业务管理后台。
3. Orange Data Mining:纯图形化机器学习流水线
Orange 是一款基于 PyQt 开发的经典开源数据挖掘工具。它无需用户编写一行代码,提供了大量预置的数据清洗、特征筛选、分类回归以及无监督聚类节点。
- 运作机制:各 Widget 节点之间通过标准接口输出 Pandas DataFrame 或 Scikit-learn 模型对象。连线一旦建立,上游节点的数据变更会触发下游节点自动更新。
- 优势:可视化图表高度丰富(散点图矩阵、箱线图、决策树可视化拆解),特别适合教学演示、探索性数据预分析。
- 短板:无法直接打包为独立的轻量化云原生微服务,定制化复杂清洗规则依然受限于自带节点的表达能力。
4. ComfyUI:模块化 Python 节点流的新典范
在图像生成与深度学习流水线领域,ComfyUI 证明了 Python 节点图在专业领域的工程威力。它将复杂的 PyTorch 模型调度抽象为高度可复用的 DAG 节点图。
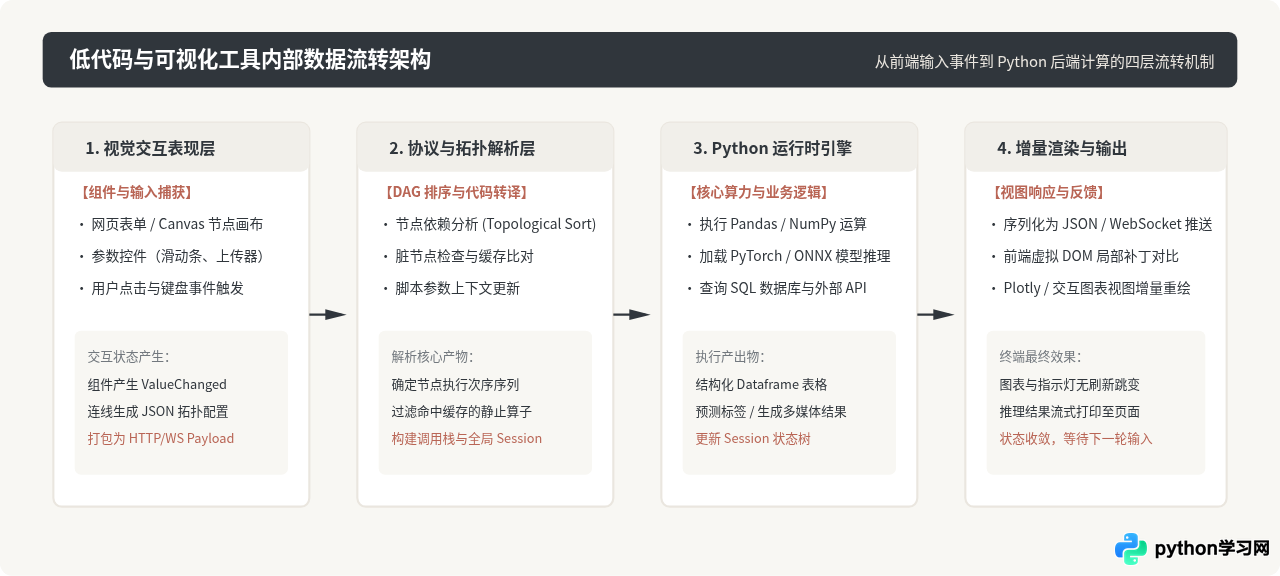
- 运作机制:后端采用轻量级 Python 执行引擎,前端使用基于 HTML5 Canvas 的 LiteGraph 连线。图结构直接导出为 JSON 工作流,Python 运行时根据拓扑排序逐级调度 GPU 张量计算。
- 优势:执行过程支持精准缓存,未变更的管道节点无需重复计算,内存释放控制极其精细。
- 短板:连线数量庞大时逻辑追踪困难,对使用者的底层算法模型原理有较高要求,并非面向纯零基础用户的傻瓜式工具。
5. Anvil:全栈纯 Python 可视化低代码平台
Anvil 提供了一个接近 Visual Studio 的所见即所得 Web 设计器,允许开发者在浏览器中拖拽按钮、下拉框、表格并完成排版。
- 运作机制:前端运行经由 Skulpt 转译的客户端 Python 代码,后端执行服务端标准 Python 运行时。前后端通过
anvil.server.call()像调用本地函数一样通信,原生内置了用户鉴权、数据表(PostgreSQL)与文件存储。 - 优势:开发真正的全栈 Web 业务系统(包含增删改查、用户登录、邮件通知)无需任何 JavaScript 参与。
- 短板:开源自托管版配置较繁琐,部分高阶运维功能与多环境流水线倾向于商业云托管订阅。
6. Qt Designer / Tkinter Designer:桌面 GUI 排版助手
对于工业控制、实验室仪器上位机开发,桌面应用依然是不可替代的载体。Qt Designer 允许开发者使用图形化界面设计 .ui 布局文件。
- 运作机制:排版完成后通过
pyuic5或pyside6-uic工具将 XML 格式的.ui编译为纯 Python 界面类,业务代码通过继承方式与界面类解耦,利用信号与槽(Signals & Slots)驱动事件。 - 优势:桌面级性能顶尖,与本地硬件驱动、串口通信无缝对接,支持完全离线部署。
- 短板:界面开发采用经典 MVC/MVVM 架构,逻辑分离严格,代码编写量显著大于轻量级 Web 框架。
三、实战工作流:使用低代码工具搭建应用的四个阶段
无论是使用 Streamlit 编写看板,还是基于 Anvil 拖拽企业系统,高效落地可视化应用都应当遵循一套标准化的工程实施路径,避免进入后期难以维护的泥潭:
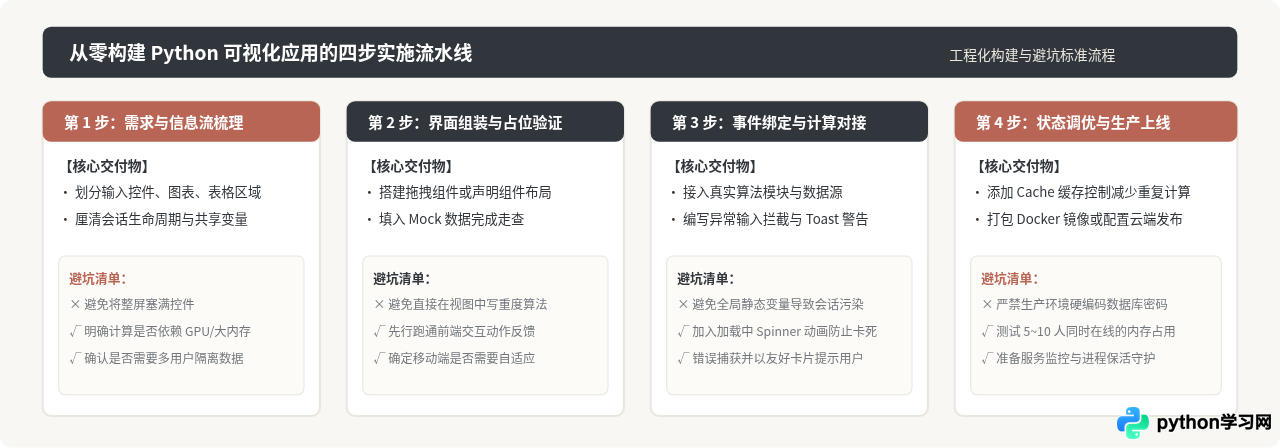
- 阶段一:划分组件与信息流布局。在动手编写代码或拖拽组件前,先在白纸上划定“参数输入区”、“状态展示区”与“核心产出区”。明确哪些字段由用户动态输入,哪些需要长期持久化保存。
- 阶段二:画布搭建与界面组装。选择匹配的控件库快速拼装界面骨架。此阶段以视觉结构与占位信息为主,不急于接入繁重的大型算法,优先验证人机交互体验是否顺畅。
- 阶段三:业务函数与事件钩子绑定。将组件的输入事件与纯 Python 函数挂接。务必保持界面逻辑与计算逻辑分离,即业务计算编写在独立的
.py模块中,可视化工具仅作为调用入口。 - 阶段四:状态缓存调优与发布验证。加入数据缓存控制(如针对重复文件读取和模型初始化的缓存设置),进行多用户并发访问测试,排查是否有全局变量污染会话的现象。
实操示例:以 Streamlit 快速实现参数化数据分析工具
以下示例展示了如何在短短十余行 Python 中,实现包含参数滑动条、数据计算和自动图表渲染的完整应用:
import streamlit as st
import pandas as pd
import numpy as np

# 1. 页面元信息配置
st.set_page_config(page_title="数据分析快速看板", layout="wide")
st.title("指标敏感度模拟分析看板")

# 2. 侧边栏参数输入区
st.sidebar.header("实验参数设置")
sample_count = st.sidebar.slider("抽样点数量", min_value=100, max_value=2000, value=500, step=100)
volatility = st.sidebar.slider("波动率系数", min_value=0.1, max_value=1.0, value=0.3, step=0.05)

# 3. 业务计算逻辑(建议使用缓存避免重复运算)
@st.cache_data
def generate_simulation_data(n: int, vol: float) -> pd.DataFrame:
    np.random.seed(42)
    steps = np.random.normal(loc=0.0, scale=vol, size=n)
    values = 100.0 + np.cumsum(steps)
    return pd.DataFrame({"时间序列周期": range(1, n + 1), "模拟估值指标": values})

# 4. 执行计算并渲染视图
data = generate_simulation_data(sample_count, volatility)

col1, col2 = st.columns([1, 2])
with col1:
    st.subheader("关键统计摘要")
    st.metric(label="最终指标估值", value=f"{data['模拟估值指标'].iloc[-1]:.2f}")
    st.metric(label="最高回撤幅度", value=f"{data['模拟估值指标'].min():.2f}")
    st.dataframe(data.head(8), use_container_width=True)

with col2:
    st.subheader("指标变化趋势曲线")
    st.line_chart(data, x="时间序列周期", y="模拟估值指标")
四、选型对比矩阵与决策指南
任何可视化或低代码工具的引入,都是“开发敏捷度”与“架构掌控力”之间的权衡。为了避免“前期一时爽,后期重构推翻”的窘境,建议围绕以下三个关键指标进行权衡:
- 厂商锁定与代码纯度:当业务复杂到低代码画布无法满足时,项目能否无缝导出为标准 Python 代码继续维护?例如 Streamlit 脚本就是标准的 Python 代码,迁移阻力极小;而平台型工具如果高度依赖闭源运行时,二次开发往往受限。
- 并发性能与服务端负载:数据看板类工具大多将计算直接压在后端服务进程上。如果单个任务占用 2GB 内存且耗时 10 秒,在多用户同时访问时很容易把单节点内存打满,需提前规划工作线程隔离或异步队列。
- Git 协同与版本管理:图形化拖拽生成的界面若保存为体积庞大、带有排版坐标的非可读 JSON 或二进制配置,团队协同开发时极易产生合并冲突(Merge Conflict)。纯脚本驱动的工具(Streamlit/Gradio)在 Git 审查方面天然优于拖拽式画布。
| 工具名称 | 交互核心 | 前端要求 | 典型适用场景 | 首要劣势 / 边界 |
|---|---|---|---|---|
| Streamlit | 纯 Python 声明式 | 零前端代码 | 数据看板、指标监控、分析报告 | 全局重新执行机制,复杂排版受限 |
| Gradio | 函数输入输出映射 | 零前端代码 | AI 算法演示、模型评测、HuggingFace | 企业后台多路由与细粒度表单支持弱 |
| Orange | DAG 节点流水线 | 无(桌面端) | 教学实验、探索性数据分析与挖掘 | 无法轻量发布 Web,拓展算法需打包 |
| ComfyUI | 模块化有向图 | 无(Web画布) | AIGC 图像/视频生成、复杂管道调度 | 连线过多认知负荷高,学习曲线陡峭 |
| Anvil | 拖拽式 WYSIWYG | 零前端代码 | 企业 CRUD 管理系统、内部业务工具 | 深度自托管依赖许可,生态相对封闭 |
| Qt Designer | 桌面拖拽生成 .ui | 无(C++/Python) | 上位机控制、离线桌面软件、高刷图表 | 代码量较大,架构分层严格,门槛较高 |
五、总结:把握可视化编程的边界与价值
Python 可视化编程工具与低代码平台的核心价值,在于将开发者从繁琐的机械性代码(如绘制原生 HTML 标签、处理 HTTP 跨域配置、编写原生窗口循环)中解脱出来,让精力聚焦于算法设计、数据洞察和业务逻辑本身。
在实际工程选型中,无需盲目追求“全无代码化”。对于数据团队而言,采用 Streamlit 或 Gradio 作为日常模型与报表的交付界面,通常是收益成本比最高的选择;而在工业控制、离线部署或成熟业务系统场景下,Qt Designer 或 Anvil 则能提供更坚固的工程底座。理解各工具的底层运作机理,合理界定业务边界,方能最大化释放 Python 生态的高效生产力。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















