


Python自然语言处理入门:核心概念与学习路径指南
一、文本预处理:让机器理解文本的第一步
人类书写的自然语言充满歧义、错别字、标点与语法变形,计算机无法直接读取裸文本。所谓文本预处理,就是通过标准化流水线,将原始字符序列清洗并切割为离散的语义单元(Token)。
一个标准的工业级预处理流程通常包含四个步骤:
- 文本清洗(Cleaning):剔除 HTML 标签、特殊控制符、无意义的标点符号及非法字符。
- 文本分词(Tokenization):英文通过空格与规则词尾分割,中文由于词语之间无空格分隔,需要依赖词典与统计算法(如 HMM、CRF 或深度学习分词器)切分词汇。
- 停用词过滤(Stopwords Removal):过滤掉“的”、“了”、“在”、“is”、“the”等高频但承载语义极低的虚词。
- 词形归一化(Normalization):在英文中体现为词干提取(Stemming)与词形还原(Lemmatization),中文中则通常包含繁简转换与大小写归一。
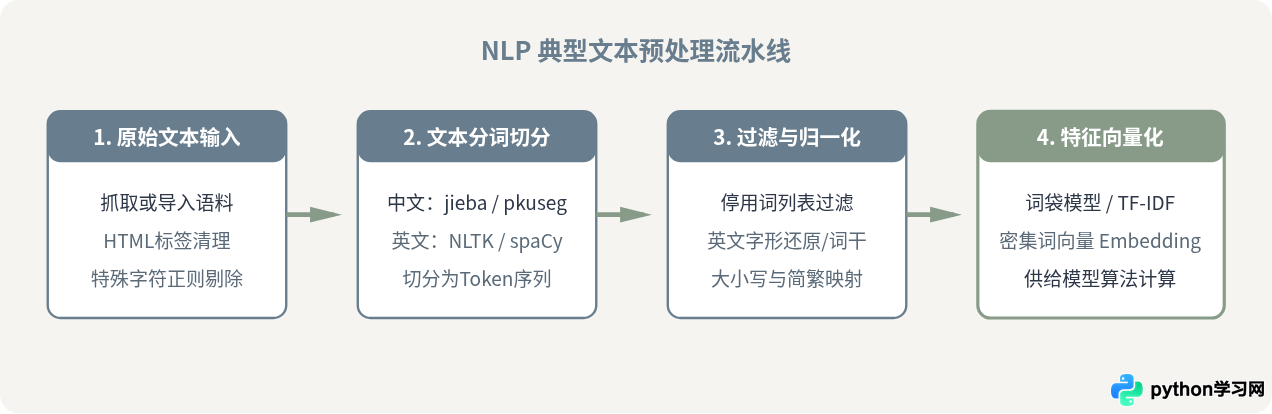
图1:从原始非结构化文本到数值特征向量的标准预处理流程
实操示例:在 Python 中完成中文分词与过滤
在 Python 环境中,中文文本最常用的分词工具是 jieba。以下是一个涵盖分词、停用词过滤和词频统计的完整最小可执行代码:
import re
import jieba

# 1. 原始文本
raw_text = "自然语言处理是计算机科学领域与人工智能领域中的一个重要方向。"

# 2. 清洗非中文字符
clean_text = re.sub(r"[^\u4e00-\u9fa5]", "", raw_text)

# 3. 使用 jieba 精确模式分词
words = list(jieba.cut(clean_text, cut_all=False))

# 4. 定义停用词表并过滤
stopwords = {"是", "中的", "一个", "与"}
filtered_words = [w for w in words if w not in stopwords]

print("分词结果:", words)
print("过滤后结果:", filtered_words)
示例输出:
分词结果: ['自然语言', '处理', '是', '计算机科学', '领域', '与', '人工智能', '领域', '中的', '一个', '重要', '方向']
过滤后结果: ['自然语言', '处理', '计算机科学', '领域', '人工智能', '领域', '重要', '方向']
二、核心概念对比:离散稀疏表示 vs 连续密集向量
自然语言处理技术演进的分水岭,在于“如何将词语映射为数字”。理解离散特征表示与连续密集词向量之间的关键差异,是掌握现代 NLP 的核心基石。
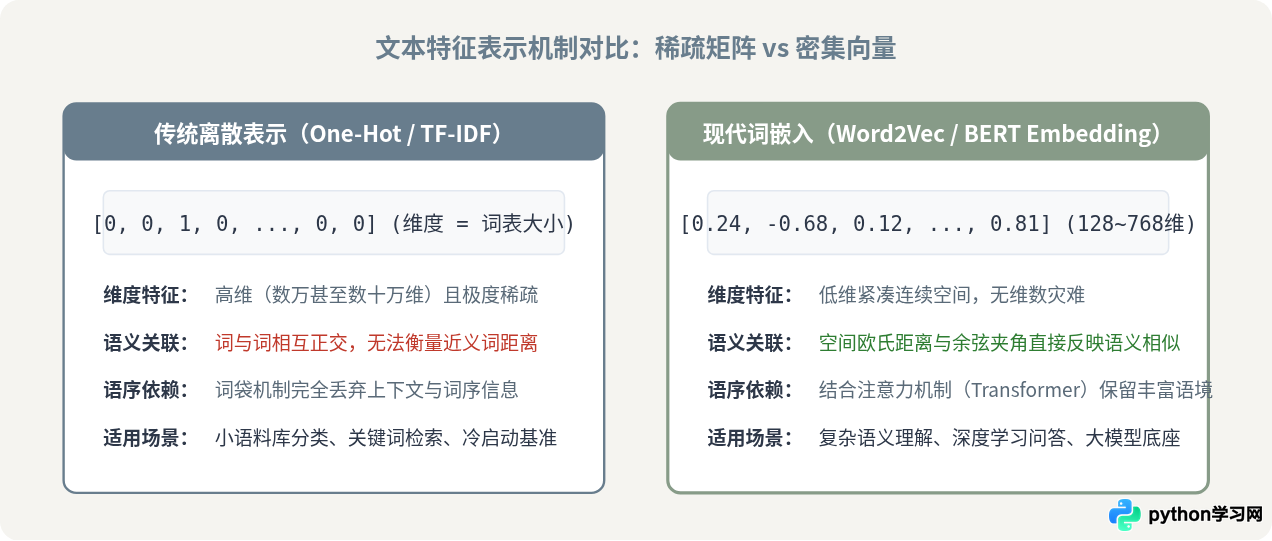
图2:传统离散稀疏表示与现代连续词嵌入的数学本质与应用差异对比
关键差异为什么重要?
在 One-Hot 或纯词袋表示下,“苹果”和“香蕉”是两个彼此垂直的向量,向量点积恒等于 0。机器无法从中获知它们都是“水果”的共性。
而在词嵌入(Word Embedding)技术中,算法通过词语的上下文共现关系(分布假说:“根据一个词周围的邻居来理解它的意义”),将词语投射到一个低维连续向量空间。“苹果”与“香蕉”在该空间中的向量余弦相似度非常接近 1,机器由此首次具备了推断语义接近性的能力。
三、经典 NLP 任务分类与技术选型
自然语言处理并非单一应用,而是根据输入与输出结构划分为若干标准任务体系。明确任务类型,才能选用正确的评价指标与模型架构。
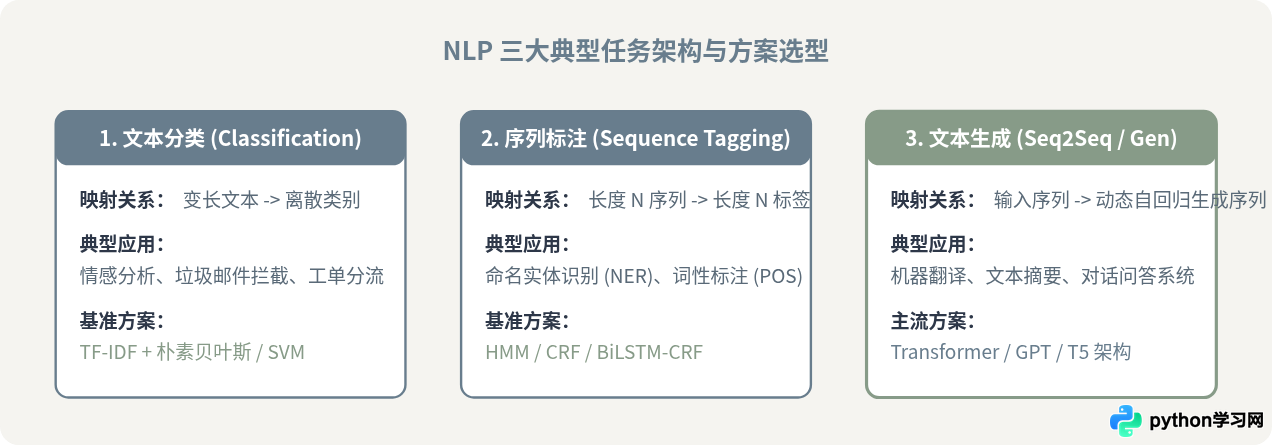
图3:NLP 核心任务维度与对应主流建模架构
四、Python NLP 三阶段系统化学习路径
许多初学者在进入 NLP 领域时,容易直接调用 Hugging Face 的庞大预训练模型,却对基础文本处理与特征矩阵一无所知;或者陷入数学推导中无法自拔,难以写出工业级代码。推荐遵循循序渐进的“三阶段递进法”。
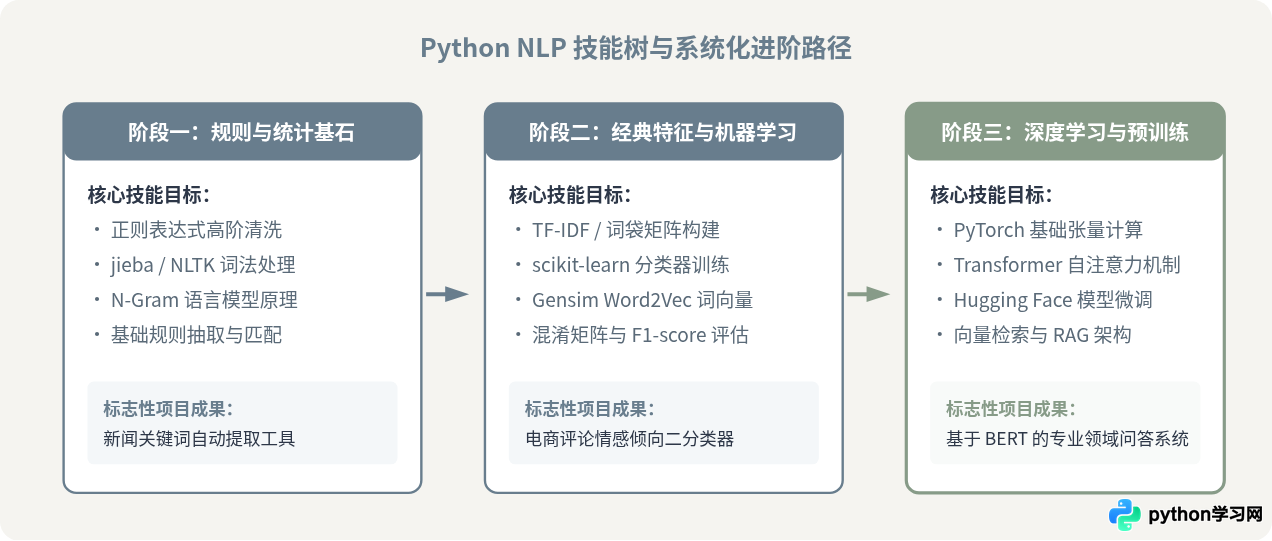
图4:Python 自然语言处理从统计规则到深度学习的三阶段成长指南
实操落地:阶段二经典机器学习分类完整流水线
在工程实践中,scikit-learn 的 Pipeline 能够将文本特征提取与分类模型无缝连接,防止训练集与测试集间发生数据泄露(Data Leakage)。以下是一段可直接运行的完整分类示例:
from sklearn.feature_extraction.text import TfidfVectorizer
from sklearn.linear_model import LogisticRegression
from sklearn.pipeline import Pipeline
from sklearn.metrics import classification_report

# 1. 训练数据与测试数据(中文语料通常需提前完成分词)
train_texts = [
    "质量 非常 好 , 物流 很快 , 包装 完好",
    "商品 瑕疵 严重 , 卖家 态度 恶劣 , 差评",
    "性能 稳定 , 外观 漂亮 , 体验 极佳",
    "用了 两天 就 坏了 , 无法 开机 , 很 失望"
]
train_labels = [1, 0, 1, 0]  # 1: 好评, 0: 差评

test_texts = [
    "物流 很 迅速 , 体验 很好",
    "质量 太差 了 , 根本 无法 使用"
]
test_labels = [1, 0]

# 2. 构建处理与建模 Pipeline
pipeline = Pipeline([
    ("tfidf", TfidfVectorizer(max_features=1000)),
    ("classifier", LogisticRegression(solver="liblinear"))
])

# 3. 拟合训练
pipeline.fit(train_texts, train_labels)

# 4. 预测与评估
predictions = pipeline.predict(test_texts)
print("测试集预测类别:", predictions)
示例输出:
测试集预测类别: [1 0]五、初学者常见误区与避坑建议
jieba.load_userdict() 引入领域专有名词词典,否则后续所有特征提取效果都将大打折扣。
utf-8 编码。在切分训练集与测试集时,特征工程的词典构建(如 fit_transform)只能作用于训练集,测试集只允许执行 transform,以杜绝数据信息泄露。
掌握 Python 自然语言处理是一项循序渐进的系统工程。从掌握基础切词与清洗规则起步,夯实特征矩阵与统计机器学习基础,再逐步进阶至 Transformer 与大语言模型(LLM)生态,才是兼具深度与工程落地能力的正确学习路径。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















