


Python正则表达式常见语法错误与避坑指南
在 Python 中使用 re 模块处理文本时,开发者常遇到两类阻碍:一类是编译期抛出的 re.error 显式语法异常,另一类是代码正常运行却因匹配边界、转义机制或分组歧义引发的“静默逻辑陷阱”。本文梳理最核心的报错诱因与逻辑漏洞,剖析深层机制并给出清晰可行的规避标准。
一、编译期硬错误:re.error 的典型根源与定位
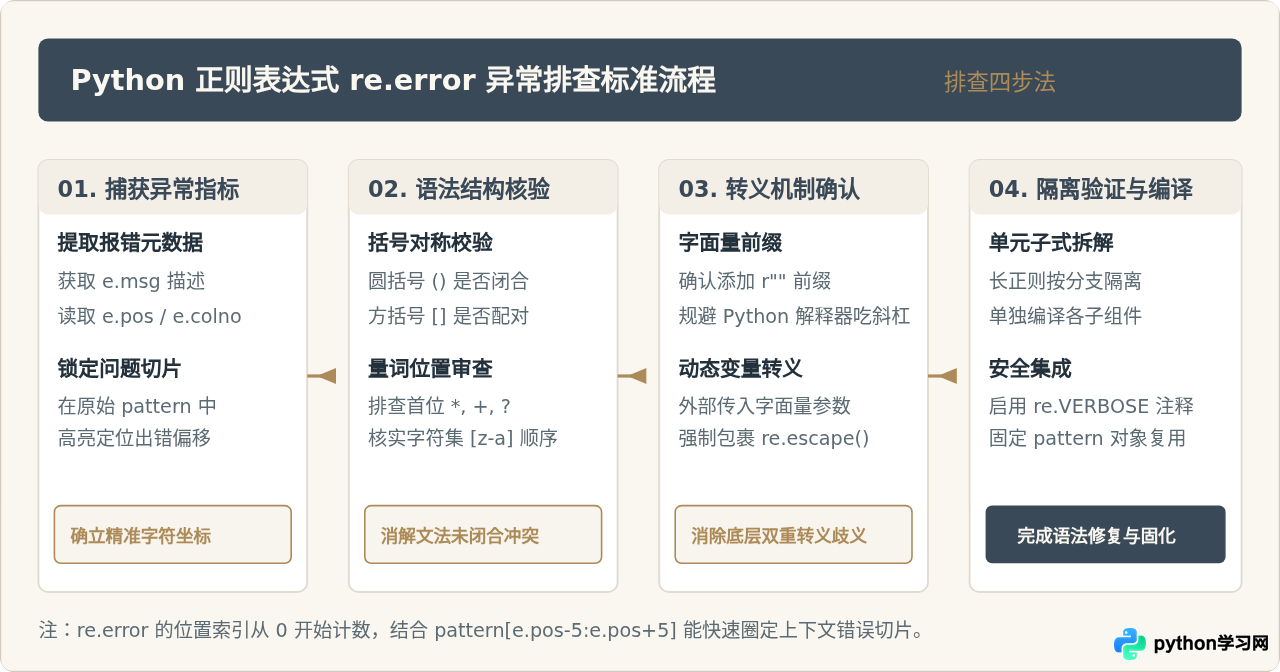
当传递给 re.compile()、re.search() 或 re.findall() 的模式字符串不符合正则文法时,Python 正则引擎在词法解析阶段便会抛出 re.error。这类错误通常包含具体的错误描述与出错位置偏移(colno),排查时切忌盲目猜测,应当根据报错信息针对性纠错。
1. 结构未闭合:missing ), unterminated subpattern
当表达式中缺少匹配的右半边括号时触发。最常见的场景是在复杂的嵌套捕获组、前瞻断言或多选分支中漏写右圆括号 ),或者在字符集 [...] 中遗漏右方括号 ]。
import re

# 错误示例:末尾缺少闭合右括号
try:
    pattern = re.compile(r"(\d{4})-(\d{2}-(\d{2})")
except re.error as e:
    print(f"报错详情: {e.msg}, 出错位置: {e.colno}")
    # 示例输出:报错详情: missing ), unterminated subpattern at position 0, 出错位置: 0

# 正确写法:补全对应的闭合圆括号
correct_pattern = re.compile(r"(\d{4})-(\d{2})-(\d{2})")
2. 量词孤立与冲突:nothing to repeat
量词(如 *、+、?、{m,n})必须紧跟在其所修饰的字符、元字符或子表达式之后。若量词直接出现在表达式开头,或者直接出现在分组起始符 ( 之后,正则引擎找不到重复作用的对象,就会抛出 nothing to repeat。此外,连续书写非法双重量词(如 ++、*+ 在默认模式下)也会引发该错误。
# 错误示例:表达式开头直接使用量词 +
# pattern = re.compile(r"+[a-zA-Z0-9]")  # 抛出 re.error: nothing to repeat at position 0

# 正确写法:为量词指定前置作用实体
correct_pattern = re.compile(r"[a-zA-Z0-9]+")
3. 字符区间倒置或短横线冲突:bad character range
方括号字符集 [...] 中的连字符 - 具备范围表示语义(如 [a-z] 代表 ASCII 码从 a 到 z 的连续区间)。若区间的起始字符编码值大于终止字符(例如写错为 [z-a] 或 [9-0]),引擎解析区间失败即抛出 bad character range。若本意是匹配字面量连字符,却未将其置于首尾或未加转义,也会导致前后字符被误解析为范围。
# 错误示例:顺序颠倒
# pattern = re.compile(r"[z-a]")  # 抛出 re.error: bad character range z-a at position 1

# 错误示例:短横线连接了非预期的两端字符
# pattern = re.compile(r"[0-9-a-z]") # 此处的 -a 可能导致意料之外的区间解析

# 正确写法:字面量连字符置于最前或最后,或显式反斜杠转义
correct_pattern_1 = re.compile(r"[-0-9a-z]")
correct_pattern_2 = re.compile(r"[0-9\-a-z]")
二、转义的双重地狱:Python 字符串与正则引擎的交互
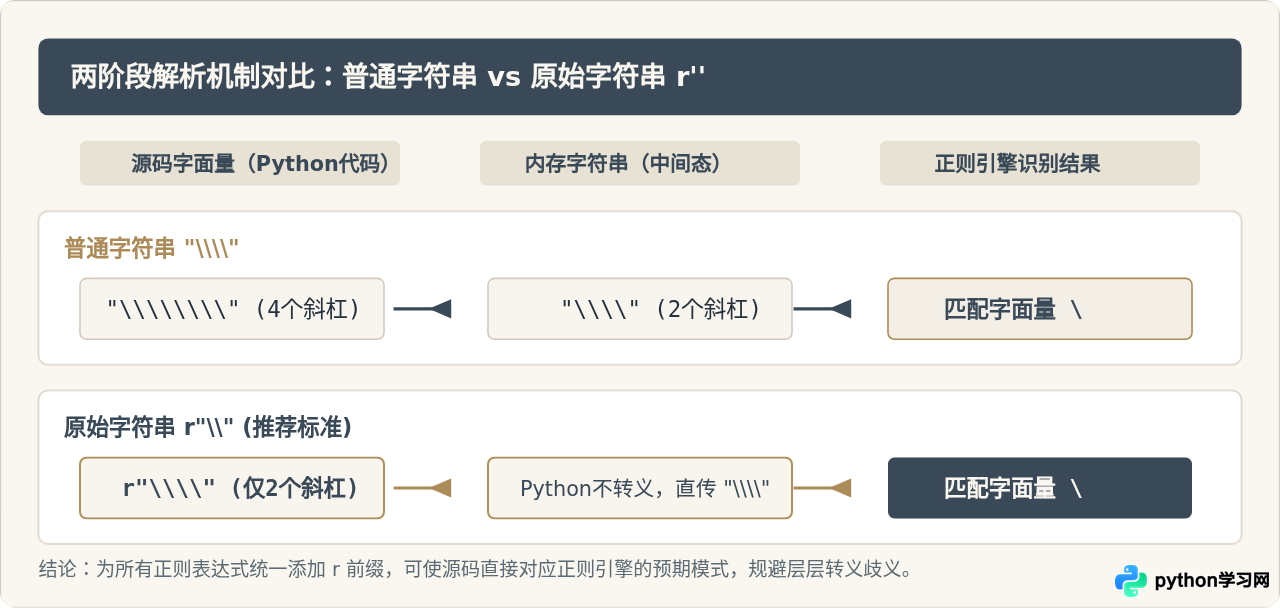
许多初学者对反斜杠 \ 产生的困惑,本质上是因为忽略了代码从源码文本传递到正则引擎时经历的两阶段解析。
第一阶段是 Python 词法分析器。当 Python 读取一个普通的双引号或单引号字符串(如 "\\d")时,它会首先按照 Python 语言标准处理转义。字符串中的 "\\" 会被解析为一个单独的反斜杠字符传给内存。
第二阶段是 Regex 正则引擎。正则引擎接收到 Python 传递过来的内存字符串后,再次以正则语法解析其中的反斜杠。如果想要在正则引擎中匹配一个真实的字面量反斜杠 \,正则引擎本身需要接收到两个反斜杠 \\;而为了让 Python 解释器输出两个反斜杠,开发者在普通字符串中就必须书写整整四个反斜杠 "\\\\"。
1. 为什么必须无条件使用 r"..."
原始字符串(Raw String)通过在字符串引号前增加前缀 r,通知 Python 解释器关闭对其内部反斜杠的特殊转义。例如 r"\n" 在内存中保存的是字符 \ 与 n 两个字符,而不是换行符(ASCII 10)。在编写正则时,由于元字符 \d、\w、\s、\b 均以反斜杠开头,如果不使用 r"",如 "\b" 会被 Python 预先解析为退格键(ASCII 8),直接破坏正则中“单词边界”的语义。
2. 动态字符串拼接时的转义遗漏:re.escape()
当正则表达式中的某些部分来自用户输入、动态配置或外部数据源时,如果直接用 f-string 拼接,一旦变量中包含 .、*、?、$、( 等符号,就会改变整个正则表达式的结构甚至导致语法崩溃。
import re

user_query = "c++(v2.0)"

# 错误示例:直接拼接,导致正则引擎将 ++ 视作双重量词,将括号视作捕获组
# pattern = re.compile(f"tag:{user_query}")  # 抛出 re.error: nothing to repeat

# 正确做法:使用 re.escape 自动对所有元字符进行安全转义
safe_query = re.escape(user_query)
pattern = re.compile(rf"tag:{safe_query}")
match = pattern.search("tag:c++(v2.0) released")
# 成功匹配到对应文本字面量
三、逻辑静默陷阱:没有报错但结果不符合预期
相比于直接中断程序的 re.error,逻辑层面的静默错误更难察觉。这类问题往往表现为返回 None、漏掉匹配项或提取了非预期的切片。
1. 方法选型误区:re.match() 与 re.search()
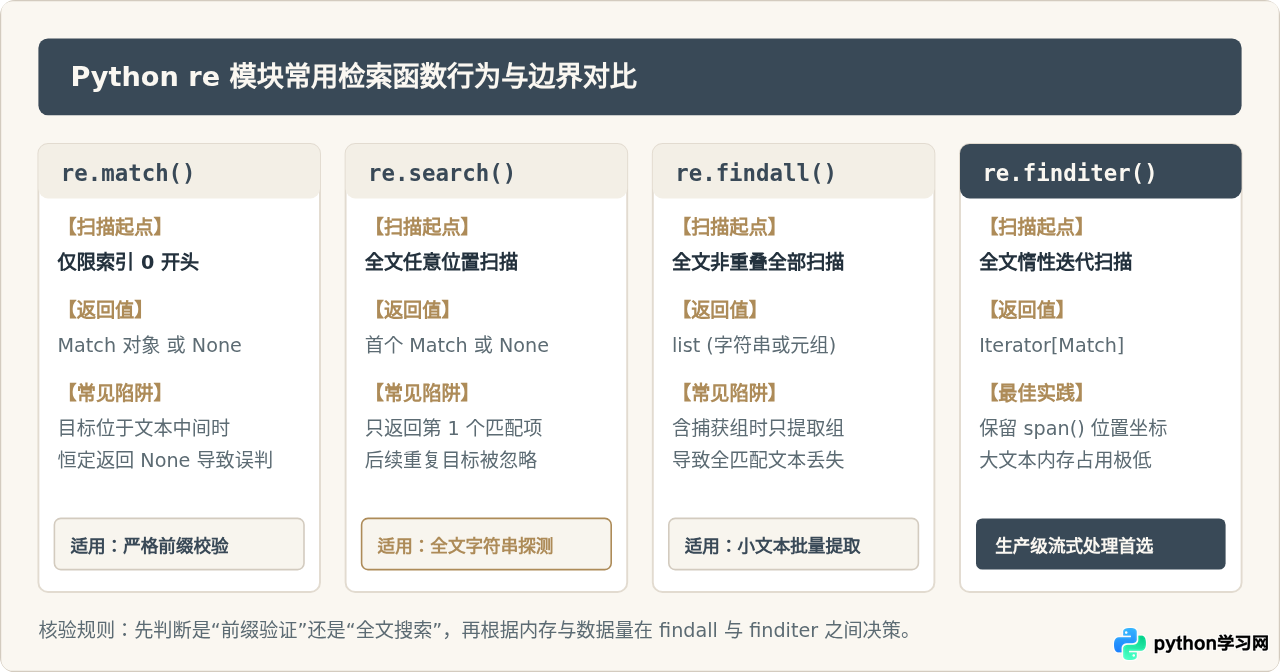
很多开发者习惯性调用 re.match(),随后困惑于为何明明包含目标字符却始终返回 None。这是因为 re.match() 严格要求从字符串起始索引 0 处开始匹配;只要开头第一个字符不符合模式,它便立即停止扫描并返回 None。如果需要在字符串任意位置查找符合条件的子串,必须使用 re.search()。
2. findall() 遇到捕获组时的“隐形降维”
在不包含圆括号分组时,re.findall() 会返回完整匹配到的字符串列表。但是,一旦表达式中包含圆括号捕获组 (...),findall() 的返回行为会发生突变:它将不再返回完整匹配文本,而是仅返回捕获组内的内容;若存在多个捕获组,则返回元组列表。
import re

text = "2026-10-25 and 2027-01-01"

# 预期提取完整日期,但误用了捕获组用于逻辑限定
pattern = re.compile(r"\d{4}-(\d{2})-\d{2}")
result = pattern.findall(text)
# 输出结果不是完整的日期,而是只有月份:['10', '01']

# 解决方案:将不需要提取的括号转为非捕获组 (?:...)
pattern_fixed = re.compile(r"\d{4}-(?:-\d{2})-\d{2}") # 或保持无括号
# 或提取全部:
correct_pattern = re.compile(r"\d{4}-\d{2}-\d{2}")
print(correct_pattern.findall(text))
# 得到完整日期:['2026-10-25', '2027-01-01']
3. 贪婪匹配(Greedy)与过度吞噬
正则表达式中的量词 *、+、{m,n} 默认均是贪婪的,它们会尽可能多地吞噬字符,直到匹配失败再发生回溯。这在提取成对标记(如 HTML 标签、双引号内部内容)时经常导致逻辑灾难。
import re

html_snippet = "<b>Python</b> and <b>Regex</b>"

# 错误示例:贪婪匹配 .* 一路吞噬到最后一个 >
greedy_pattern = re.compile(r"<b>.*</b>")
print(greedy_pattern.search(html_snippet).group())
# 输出了完整字符串:<b>Python</b> and <b>Regex</b>

# 正确写法:在量词后添加 ? 声明非贪婪(惰性)匹配
lazy_pattern = re.compile(r"<b>.*?</b>")
print([m.group() for m in lazy_pattern.finditer(html_snippet)])
# 正确分别提取出:['<b>Python</b>', '<b>Regex</b>']
4. 模式标志位误用:re.M (多行) 与 re.S (单行/全通配)
-
re.MULTILINE(re.M):仅改变^和$的行为,使其能够分别匹配每一行的开头和结尾(即以\n换行处为边界),并不改变点号.的通配范围。 -
re.DOTALL(re.S):仅改变点号.的行为,使其能够匹配包括换行符\n在内的任意字符。
很多开发者在期望点号跨行匹配时误传了 re.M,导致匹配失败却百思不得其解。
四、工程避坑矩阵与全景速查
在实际生产环境中,除了语法正确性,还需要兼顾可维护性与运行效率。特别是防范恶意构造字符串引起的“灾难性回溯”(ReDoS),以及规范动态正则表达式的生命周期。
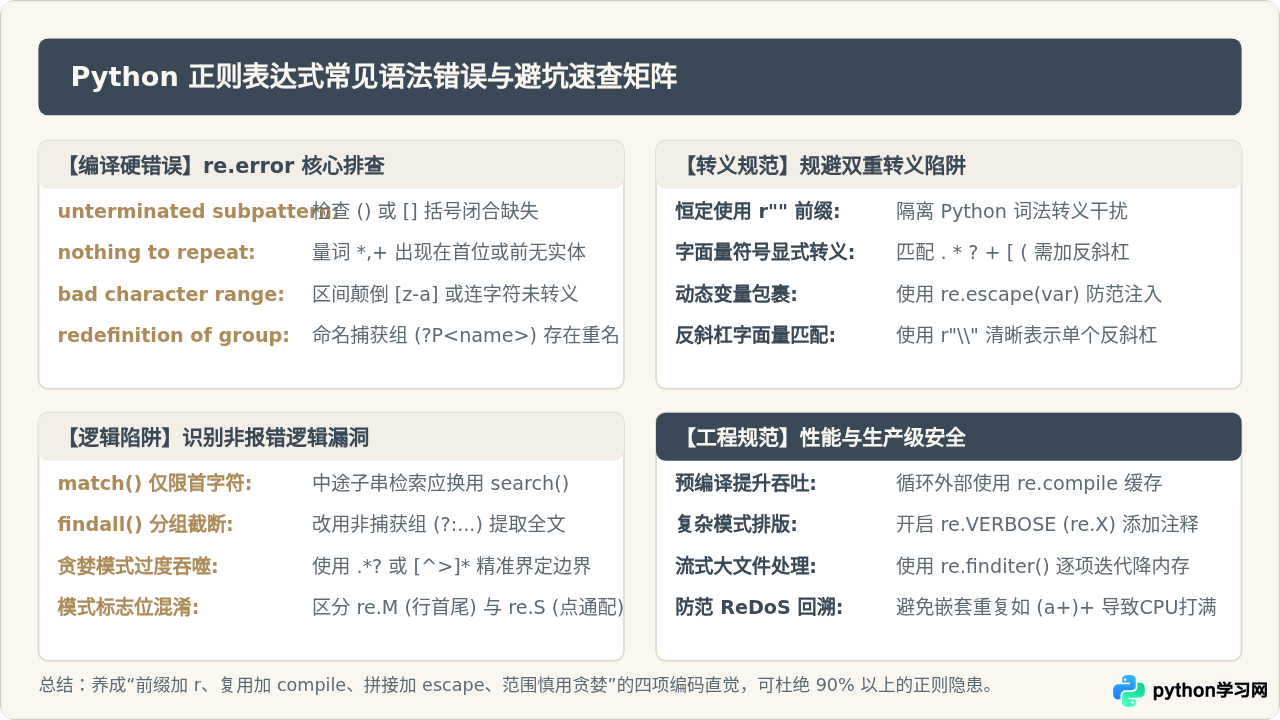
工程落地:使用 re.VERBOSE 编写自解释长正则
随着匹配规则日益严密,长单行正则表达式极难审查和维护。Python 提供了 re.VERBOSE(简写为 re.X)模式,该模式会忽略模式中未转义的空白符与换行符,并允许使用 # 在模式内撰写注释,极大降低了由于多人协作或后期维护引入语法错误的风险。
import re

# 使用 re.VERBOSE 拆解复杂邮箱/用户标识匹配模式
clean_email_pattern = re.compile(r"""
    ^                   # 匹配行首
    (?P<username>       # 命名捕获组:用户名
        [a-zA-Z0-9_.+-]+
    )
    @                   # 分隔符 @
    (?P<domain>         # 命名捕获组:域名
        [a-zA-Z0-9-]+
        (?:\.[a-zA-Z0-9-]+)+
    )
    $                   # 匹配行尾
""", re.VERBOSE)

target = "service.support@internal-sub.corp.net"
match = clean_email_pattern.match(target)
if match:
    print("解析成功:")
    print("用户名:", match.group("username"))
    print("域名:", match.group("domain"))
- 加前缀:所有正则表达式字符串字面量是否全部带有
r前缀? - 对括号:括号
()、[]、{}是否全部成对且闭合,有无颠倒区间? - 查函数:全文搜索是否错误调用了仅前缀匹配的
re.match()? - 看分组:
re.findall()的结果是否因普通括号丢失了整串数据?是否需改用(?:...)? - 防贪婪:提取区间内容时是否将贪婪的
.*换成了非贪婪的.*?或排除字符集? - 护变量:来自外部参数的变量拼接是否包裹了
re.escape()?
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















