


Python读取含中文JSON文件出现UnicodeDecodeError怎么解决
核心结论:Python 读取含中文的 JSON 文件时报出 UnicodeDecodeError,根本原因在于 open() 函数未显式声明 encoding 参数,导致程序调用了操作系统的默认编码(Windows 下默认为 GBK/ANSI)去解析 UTF-8 格式的中文多字节序列。解决该问题只需在打开文件时显式传入 encoding='utf-8';若文件由 Windows 记事本等工具生成并带有 UTF-8 BOM,则传入 encoding='utf-8-sig'。
一、常见报错现象与成因分析
在日常开发中,许多开发者习惯写出如下两行读取代码:
import json

# 未指定 encoding 参数的简写方式
with open('data.json', 'r') as f:
    data = json.load(f)
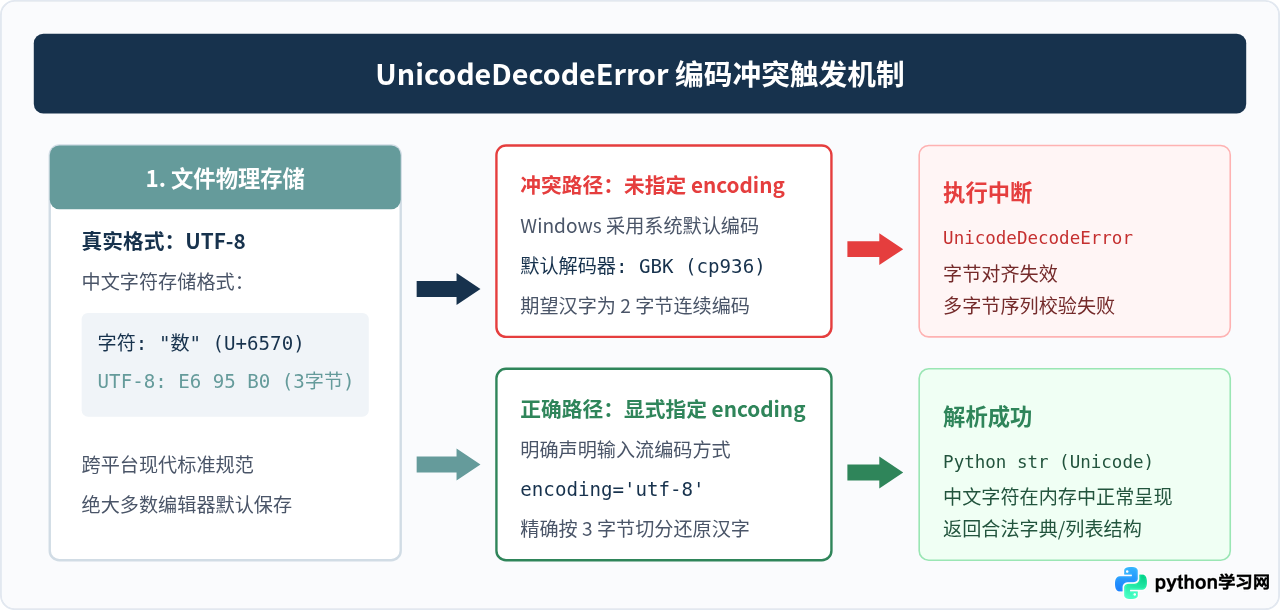
在 Linux 或 macOS 系统上,默认编码通常为 UTF-8,上述代码大概率能正常执行;但在中文 Windows 环境下,Python 默认采用系统的 ANSI 代码页(即 cp936 / gbk)。当遇到以 UTF-8 编码保存的中文文本时,控制台便会抛出类似以下的错误:
UnicodeDecodeError: 'gbk' codec can't decode byte 0x80 in position 14: illegal multibyte sequence中文汉字在 UTF-8 编码下通常占用 3 个字节(例如中文字符“中”的 UTF-8 字节序为 0xE4 0xB8 0xAD),而在 GBK 编码规则中汉字仅占 2 个字节。当 GBK 解码器按两字节一组去解读 UTF-8 字节流时,高位字节与后续字节的组合会破坏 GBK 编码表的有效区间,最终引发“非法多字节序列”崩溃。
二、标准修复方法与完整代码
修复此问题的核心是在内置的 open() 函数中加入 encoding='utf-8' 关键字参数。标准写法如下:
import json

# 明确指定 encoding='utf-8'
with open('data.json', 'r', encoding='utf-8') as f:
    data = json.load(f)

print(data)
特殊情况:带 BOM 的 UTF-8 文件
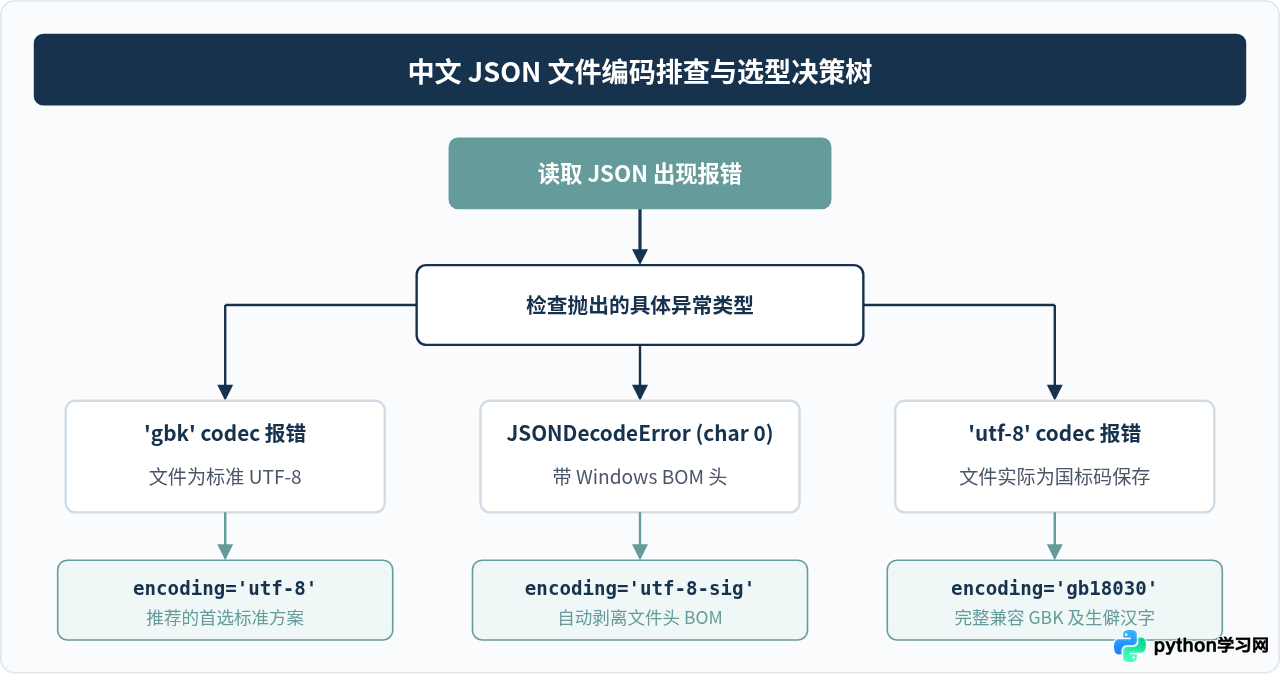
在 Windows 环境下使用微软“记事本”或部分旧版软件创建并保存为 UTF-8 时,文件开头可能会隐式插入 3 个字节的 BOM(Byte Order Mark,十六进制序列为 \xef\xbb\xbf)。若使用常规 encoding='utf-8' 读取,这 3 个字节会被作为普通字符读入,导致 JSON 解析器在首字符处报出 json.decoder.JSONDecodeError: Expecting value: line 1 column 1 (char 0)。
遇到此类文件,将编码参数改为 encoding='utf-8-sig'。Python 的 utf-8-sig 解码器会自动检测并剔除文件首部的 BOM 标记:
import json

# utf-8-sig 会自动跳过开头的 BOM 标记
with open('data.json', 'r', encoding='utf-8-sig') as f:
    data = json.load(f)
三、编码排查决策路径
当开发者面对来源多样的外部 JSON 数据时,错误信息可能并非固定为 'gbk' codec,有时也会出现 'utf-8' codec can't decode byte ...。这说明原始文件的实际编码并非 UTF-8,而是 ANSI/GBK/GB18030。按照以下决策路径可以快速锁定正确的读取方式:
四、标准化操作流程与关键步骤
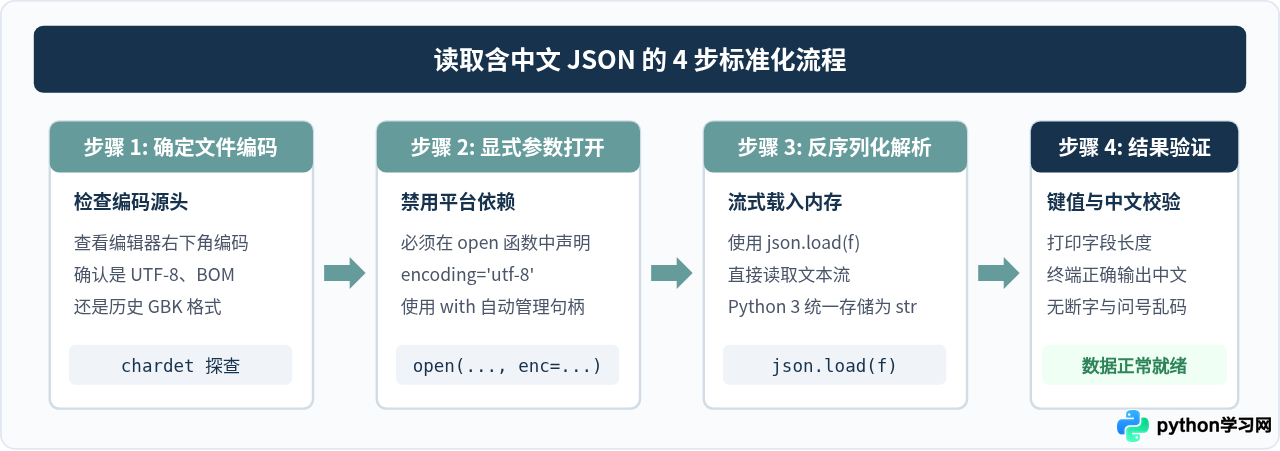
为了保证程序在各类操作系统及微服务容器中具备一致的鲁棒性,读取含中文 JSON 文件应遵循严格的 4 步标准化操作流程:
在实际工程代码中,若面临极其动态或复杂的第三方输入,建议封装容错加载函数:
import json

def safe_load_json(file_path):
    # 优先使用 utf-8-sig,兼容标准 UTF-8 以及带 BOM 的 UTF-8
    try:
        with open(file_path, 'r', encoding='utf-8-sig') as f:
            return json.load(f)
    except UnicodeDecodeError:
        # 回退至 gb18030(gb18030 兼容 gbk 与 gb2312 且支持生僻汉字)
        with open(file_path, 'r', encoding='gb18030') as f:
            return json.load(f)
五、容易混淆的误区与注意事项
-
不要滥用
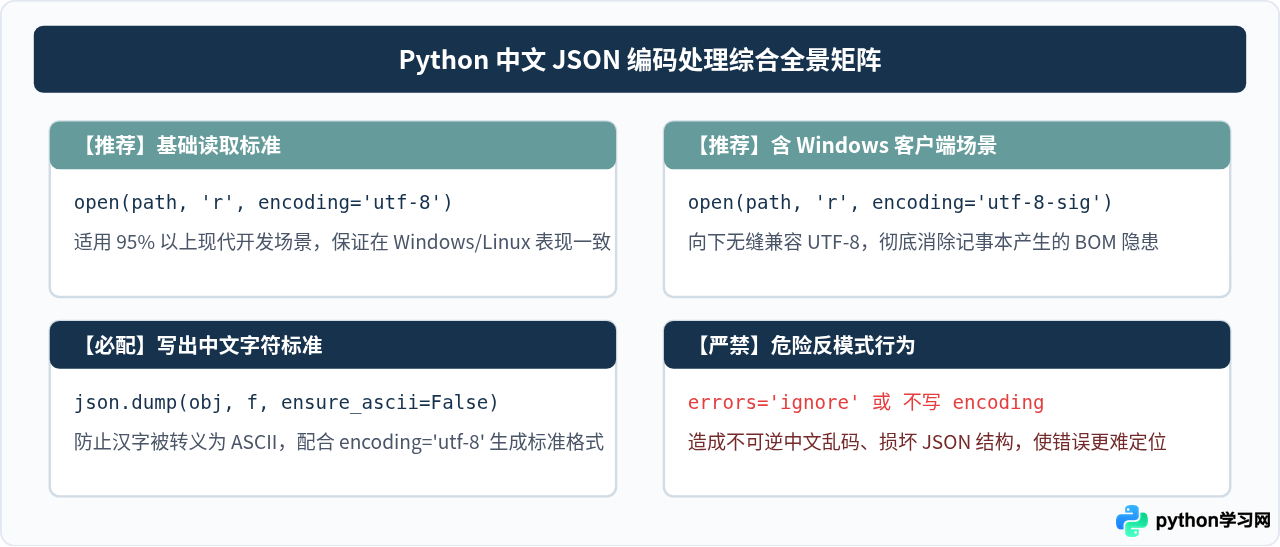
errors='ignore': 在open()中设置errors='ignore'虽然能压制报错,但它是通过直接丢弃无法解析的字节实现的。这将导致中文字符被截断变异、丢失甚至造成后面的双引号错位,使整个 JSON 文档出现语法解析错误。 -
写入 JSON 时务必搭配
ensure_ascii=False: 读取中文 JSON 只是第一步。如果将数据处理后重新存入 JSON 文件,json.dump()默认配置了ensure_ascii=True,会将中文转义为\u4e2d\u6587形式。若希望生成可读的中文文件,必须设置ensure_ascii=False并指定encoding='utf-8':with open('output.json', 'w', encoding='utf-8') as f: json.dump(data, f, ensure_ascii=False, indent=2) -
二进制模式与
json.loads()的差异: Python 3.6+ 起,json.loads()支持直接接收bytes类型,并会根据 RFC 7159 规范自动检测 UTF-8、UTF-16 或 UTF-32。因此使用二进制读取也是一种避免字符解码器提前干预的途径:with open('data.json', 'rb') as f: data = json.loads(f.read()) # 仅适用于合法标准的 UTF-8/16/32 格式
六、方案全景对比与速查矩阵
下表归纳了不同场景下读取与保存中文 JSON 的配置组合:
| 场景分类 | 典型文件来源 | 推荐 open 参数 | 核心作用与保障 |
|---|---|---|---|
| 标准跨平台 JSON | VS Code、现代 Web API、Linux 服务生成 | encoding='utf-8' |
符合现代工业标准,消除跨系统平台默认编码干扰 |
| Windows 文本编辑器生成 | Windows 记事本、部分 Office 导出工具 | encoding='utf-8-sig' |
自动跳过 0xEFBBBF 开头字节,避免第一行解析失败 |
| 历史系统/本地遗留数据 | 老旧企业管理系统、旧版 Excel 导出 | encoding='gb18030' |
囊括繁体及生僻中文,比纯 gbk 具备更广字库覆盖面 |
| 中文数据回存/写出 | 处理完成后保存为新 JSON | encoding='utf-8' + ensure_ascii=False |
防止汉字被转义为 \uXXXX 字符序列,保持文件清晰易读 |
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















