


怎么用Python items()遍历字典的键和值
在 Python 中,如果需要同时获取字典中的“键(Key)”与“值(Value)”,最直接且规范的方式是调用字典的 items() 方法并配合 for 循环进行元组解包。本文介绍 items() 的标准语法、执行机制、与下标索引访问的差异,以及在实际开发中修改字典和排序时的注意事项。
一、基本用法:结合 for 循环解包键与值
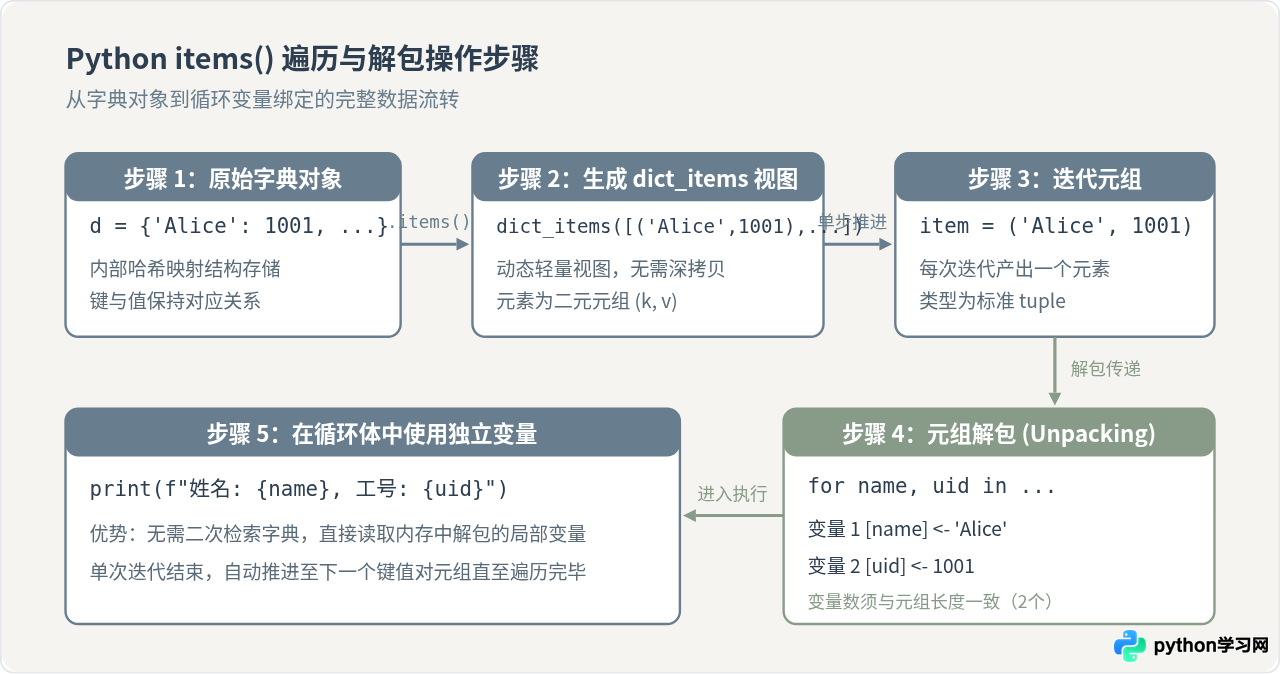
字典的 items() 方法会返回一个由 (键, 值) 二元元组组成的视图对象。在 for 循环中,可以使用两个变量分别接收元组的第一个元素(键)与第二个元素(值)。
# 示例:遍历员工与其对应的工号
user_ids = {
    "Alice": 1001,
    "Bob": 1002,
    "Charlie": 1003
}

# 使用 items() 同时遍历键和值
for name, uid in user_ids.items():
print(f"员工姓名: {name}, 工号: {uid}")员工姓名: Alice, 工号: 1001
员工姓名: Bob, 工号: 1002
员工姓名: Charlie, 工号: 1003在这段代码中,每次循环开始时,items() 产出一个形如 ("Alice", 1001) 的元组。Python 会将元组中的第一项赋值给变量 name,第二项赋值给变量 uid。这种机制称为“序列解包(Unpacking)”。
二、底层原理:动态视图对象 dict_items 的特性
在 Python 3 中,d.items() 返回的不是一个静态的列表(list),而是一个 dict_items 视图对象(Dictionary View Object)。理解这一特性有助于避免常见的内存占用与运行时异常。
1. 动态与原字典保持联动
视图对象不复制字典内的键值数据,它只是底层哈希表的一个动态窗口。如果底层字典的内容发生变更,视图对象会实时体现出该变化。
data = {"x": 10, "y": 20}
items_view = data.items()

# 修改原字典
data["z"] = 30

# 查看视图内容
print(list(items_view))[('x', 10), ('y', 20), ('z', 30)]可以看到,向 data 添加新键 "z" 后,之前获取的 items_view 自动同步包含了新的元组,无需重新调用 .items()。
2. 遍历中禁止修改字典大小
由于视图直接绑定底层结构,如果在遍历 items() 的过程中增删字典键,会导致内部迭代器状态紊乱,Python 会立即抛出 RuntimeError:
scores = {"Math": 90, "English": 85, "History": 70}

# 错误操作:在遍历中删除键
for subject, score in scores.items():
    if score < 80:
del scores[subject] # 抛出 RuntimeError: dictionary changed size during iterationlist(scores.items()) 制作一份静态快照进行遍历,或者使用字典推导式生成新的字典:
# 方案一:通过 list() 固化快照后安全删除
for subject, score in list(scores.items()):
    if score < 80:
        del scores[subject]

# 方案二:使用字典推导式直接生成过滤后的字典
scores = {k: v for k, v in scores.items() if v >= 80}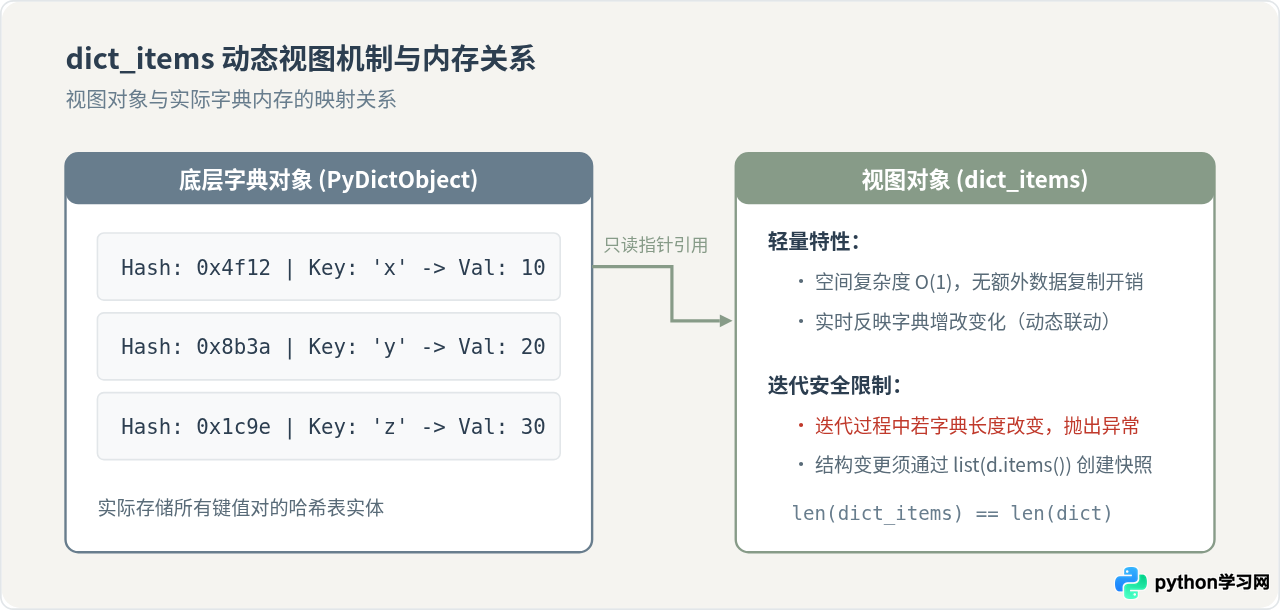
三、关键差异:items() 与 keys() 配合下标访问对比
在需要同时使用键和值的场景下,初学者常写出 for k in d: v = d[k] 这样的代码。虽然结果一致,但这两种实现方式在底层机制、执行效率与代码语义上存在显著差异。
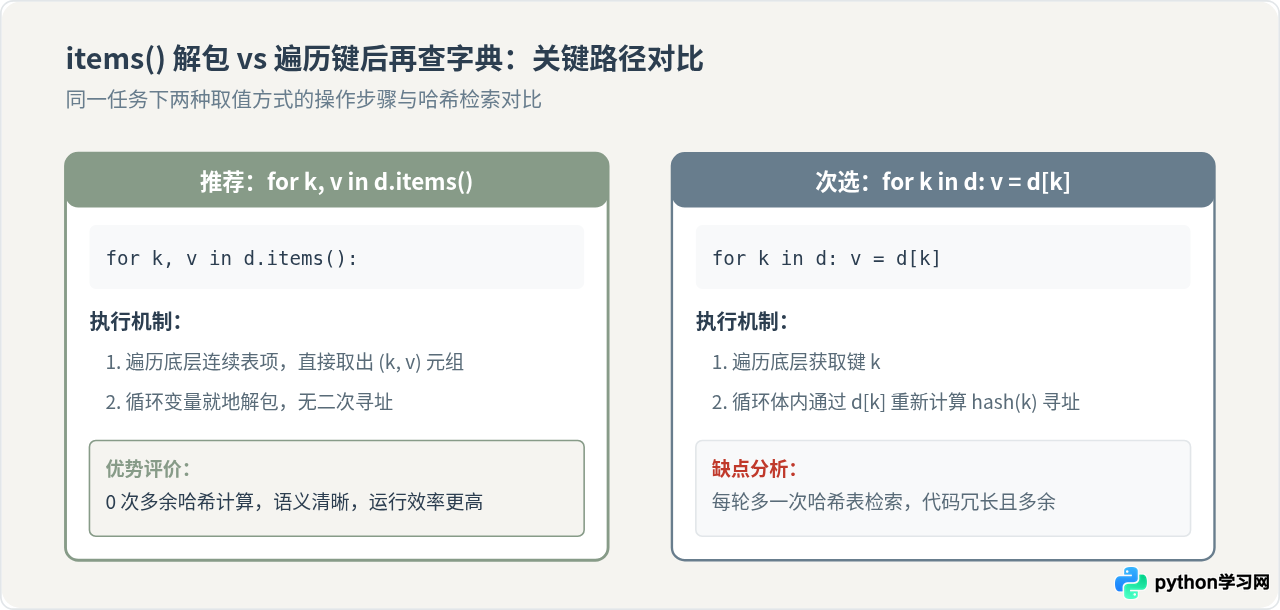
为了直观展示两者的区别,我们从四个维度进行归纳:
| 对比维度 | for k, v in d.items() | for k in d: v = d[k] |
|---|---|---|
| 哈希检索次数 | 0 次额外检索:底层遍历键值数组直接解包 | N 次额外检索:每次循环执行一次 hash(k) 与哈希桶匹配 |
| 代码表达意图 | 直接表明“本循环同时依赖键和值” | 表面仅声明遍历键,在循环体中才暴露对值的需求 |
| 运行效率 | 在大多数 Python 解释器实现中更快更紧凑 | 存在重复查表开销,大规模数据遍历时耗时更长 |
| 适用边界 | 必须同时用到键与值 | 仅在只使用键时推荐(此时省略 d[k]) |
四、常用场景与扩展技巧
1. 结合 enumerate() 获得遍历索引
有时除了键和值,还需要知道当前是第几个元素(即序号)。可以将 d.items() 传递给 enumerate(),此时解包结构变为 index, (key, value):
config = {"host": "localhost", "port": 8080, "protocol": "https"}

# 使用 enumerate 并指定起始序号为 1
for index, (key, val) in enumerate(config.items(), start=1):
print(f"[{index}] 参数名: {key} -> 参数值: {val}")[1] 参数名: host -> 参数值: localhost
[2] 参数名: port -> 参数值: 8080
[3] 参数名: protocol -> 参数值: https(key, val) 的圆括号不能省略。若写为 for index, key, val in enumerate(...),Python 会尝试将 enumerate 返回的二元结构解包为三个变量,从而触发 ValueError: not enough values to unpack 错误。
2. 按字典的值进行排序遍历
字典本身无序或仅保持插入顺序。若需要按照“值”的大小排序输出,可以配合 sorted() 函数:
scores = {"张三": 78, "李四": 95, "王五": 88}

# 按照分数从高到低排序遍历
for name, score in sorted(scores.items(), key=lambda item: item[1], reverse=True):
print(f"{name}: {score}分")李四: 95分
王五: 88分
张三: 78分五、字典遍历方式选型总结
根据具体的业务需求选择最精简的遍历方式,不仅能提升代码可读性,还能规避不必要的性能开销:
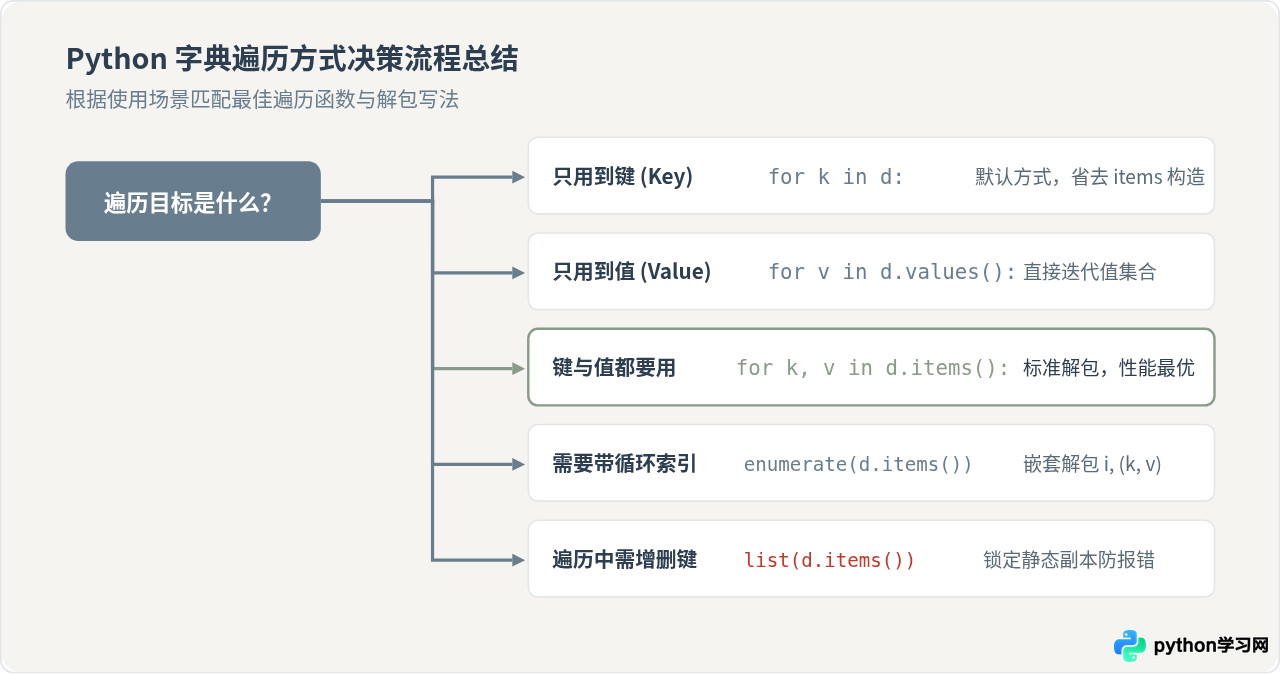
综上所述,遍历字典键和值的规范操作即是 for key, value in dict_object.items():。掌握序列解包对应规则以及 dict_items 动态视图在迭代时的保护限制,能够帮助我们在日常开发中写出更加健壮、高效且易于阅读的 Python 程序。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















