


GitHub上值得下载的Python实战项目源码与教程

学习Python语法并不困难,但在脱离练习题并走向实际业务时,许多开发者常面临工程组织松散、依赖难以管理以及代码扩展困难等问题。在GitHub上阅读和调试优质开源项目,是理解专业软件架构与工程规范最直接的途径。本文将梳理如何筛选真正有学习价值的Python实战源码,推荐几个涵盖不同技术场景的代表性项目,并演示如何在本地搭建隔离环境进行单步调试与代码精读。
一、筛选高质量Python实战项目的四个评估维度
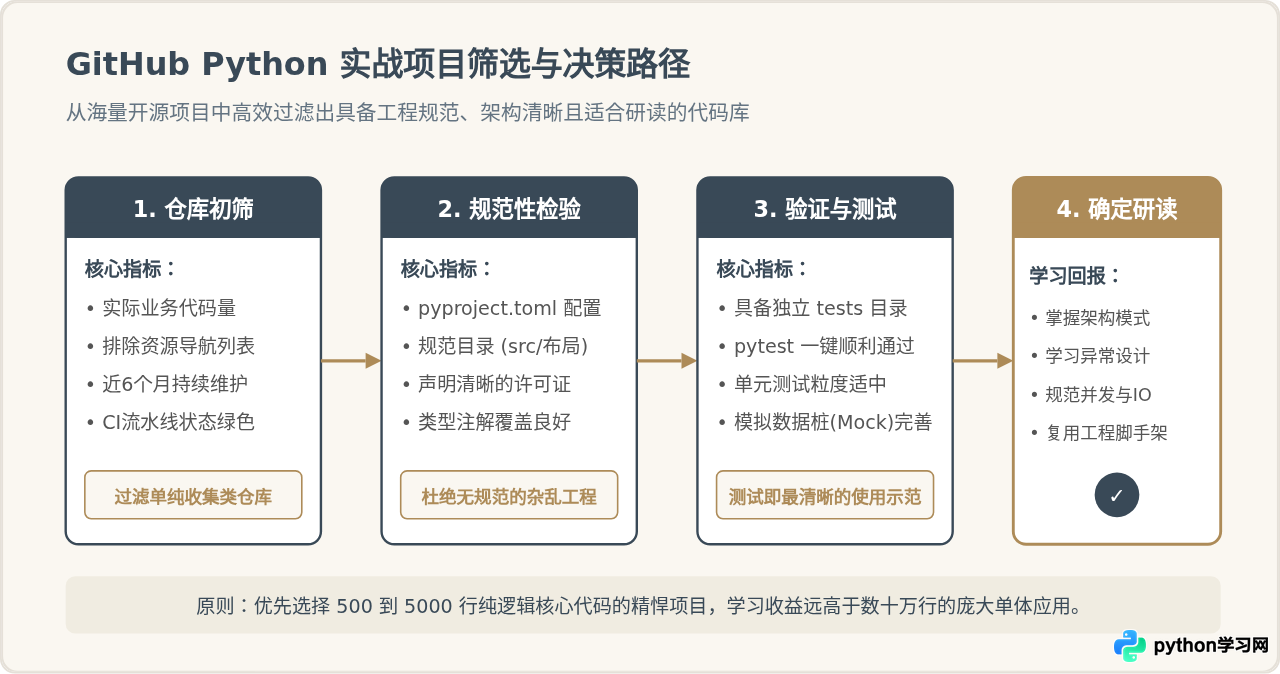
GitHub上的Python仓库数以百万计,但并非所有高星项目都适合作为精读材料。许多仓库属于资源汇总(Awesome List)或教学Demo,缺乏真实的工程全貌;另一些项目年代久远,仍停留在过时的依赖管理方式中。挑选适合下载研读的代码,建议聚焦以下四个关键维度:
- 依赖与工程规范统一性:检查根目录是否包含现代化的配置文件,如
pyproject.toml或清晰的setup.py。规范的项目通常会严谨声明构建系统(如 Hatch、Poetry、Flit 或 uv),并配置有代码格式化(Black/Ruff)与类型检查(Mypy)规则。 - 自动化测试用例覆盖度:成熟的工程必定包含
tests/目录。测试用例是理解项目对外接口和内部边界最真实、最详细的“活文档”,能为初学者指明代码设计的预期输入与边界响应。 - 模块解耦与目录层级:优秀项目的核心逻辑通常保持低耦合。以单一职责原则划分模块(如拆分为驱动层、业务层、工具层),避免数千行的大单体文件,利于循序渐进地精读局部逻辑。
- 维护活跃度与CI状态:查看近半年的提交记录与Issue响应,确认持续集成(GitHub Actions)构建状态为通过,确保下载到本地后能够无障碍安装和执行。
二、四类值得精读的典型Python实战项目推荐
针对不同的成长目标,读者应当针对性地挑选对应领域的经典项目。以下推荐的项目在代码规范、设计模式和可维护性方面均具有行业代表性:
1. 现代化命令行工具:Textual 与 Rich
仓库定位:构建终端富文本、表格以及交互式控制台应用(TUI)。
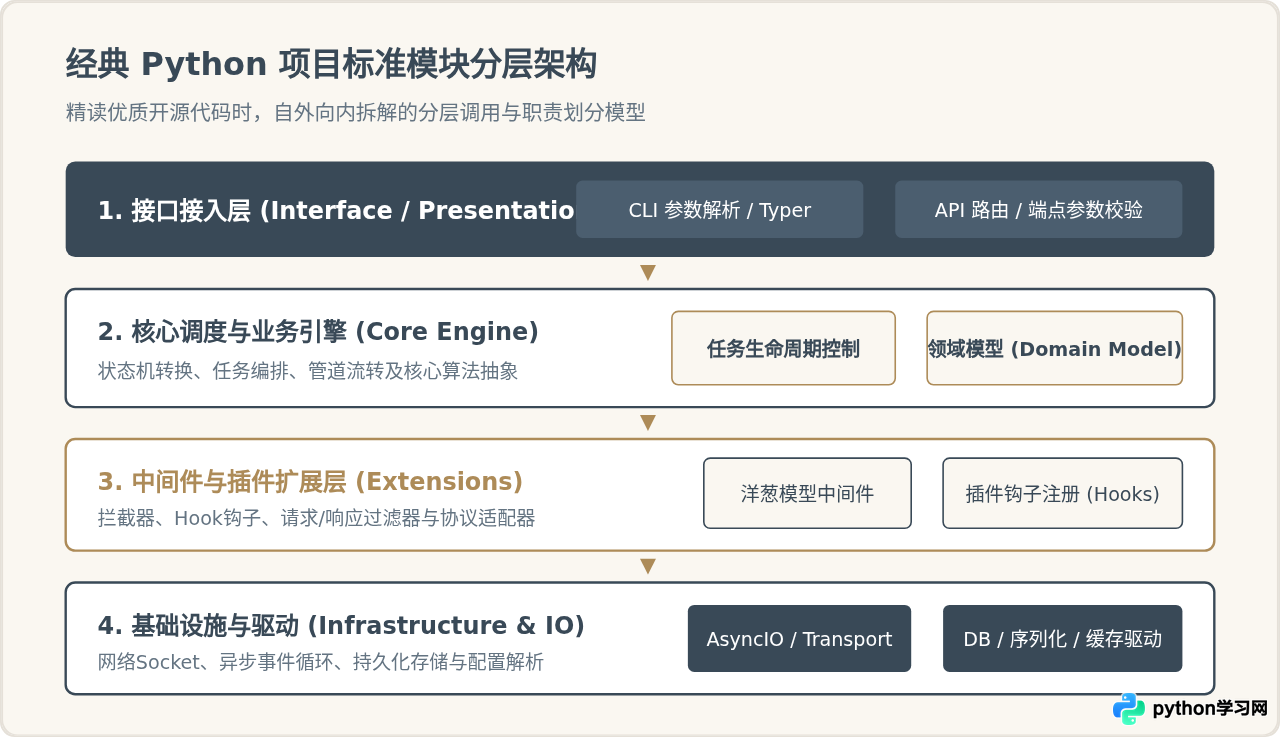
精读价值:初学者往往通过简单的 print() 与终端交互,而在阅读 Rich 源码时,可以系统学习面向对象的封装思想:从底层的字符缓冲(Buffer)、终端色彩转义协议(ANSI Sequences),到高层的布局渲染树(Renderable Protocol)。其内部大量运用了 __rich_console__ 等协议魔术方法,是理解 Python 鸭子类型(Duck Typing)与协议编程(Protocol)的极佳范例。
2. 高性能异步网络与Web微服务:HTTPX 与 FastAPI
仓库定位:全功能异步HTTP客户端与现代异步Web框架。
精读价值:HTTPX 实现了与 Requests 高度兼容的API,同时底层原生支持 asyncio 与 trio 双引擎异步驱动。通过阅读 HTTPX 的连接池管理(Transport层)与状态机调度,可以透彻掌握 Python 异步并发模型;而 FastAPI 的源码展示了如何将 Pydantic 的类型校验与 Python 类型注解优雅融合,其依赖注入系统(Dependency Injection)是构建复杂业务解耦的标准设计范式。
3. 自动化任务与解析引擎:Scrapy 与 BeautifulSoup4
仓库定位:高扩展网络数据抓取系统与文档解析工具。
精读价值:Scrapy 展现了成熟的事件驱动架构(基于 Twisted 引擎或 asyncio)。其流水线(Pipeline)、中间件(Downloader/Spider Middleware)设计是学习洋葱模型和插件化架构的教科书级代码。深入其源码,能够深刻理解请求如何在调度器、下载器、解析器之间穿梭。
4. 深度学习与基础计算内核:Tinygrad
仓库定位:极简轻量级深度学习框架。
精读价值:PyTorch 代码量庞大且夹杂大量 C++/CUDA 原生扩展,普通开发者难以通读。而 Tinygrad 用数千行纯 Python 代码清晰实现了自动求导(Autograd)、张量操作(Tensor)以及计算图编译。对于希望理解计算图、懒加载(Lazy Evaluation)和抽象语法树转换的读者而言,这是不可多得的硬核项目。
三、本地克隆、环境隔离与源码调试的实操步骤
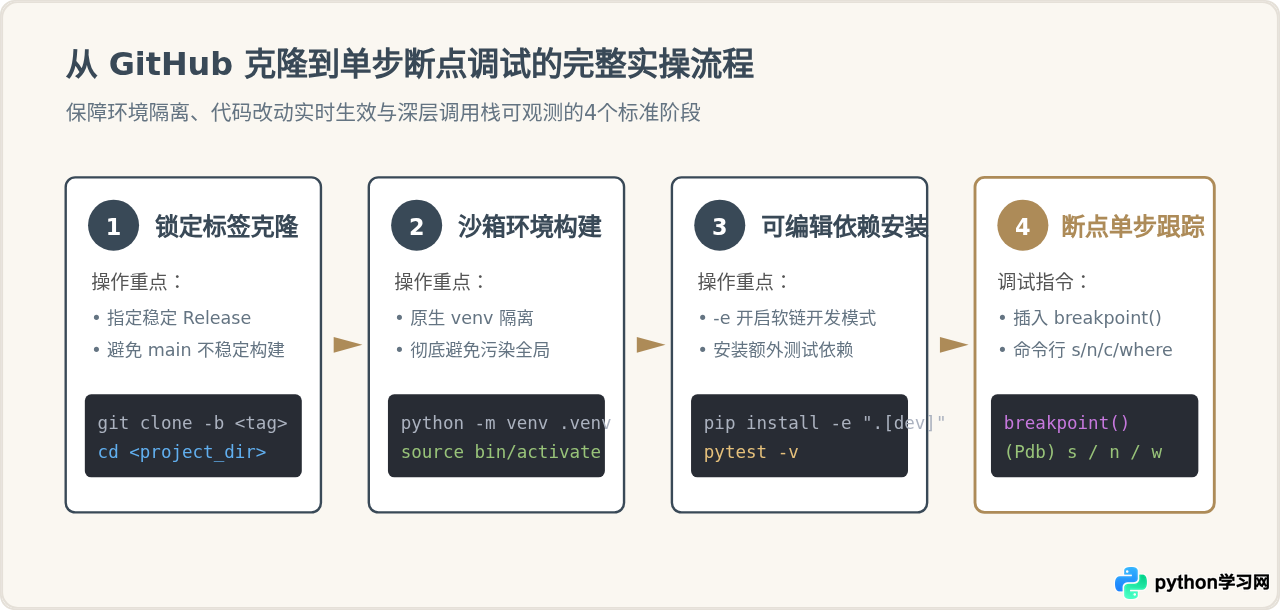
直接在主开发环境中安装项目容易造成依赖冲突(Dependency Hell)。学习开源项目的标准姿势,必须始终在干净隔离的环境中以可编辑模式(Editable Mode)进行安装,以便随时在源码中插入断点或打桩输出。
步骤 1:克隆指定发行标签(Release Tag)
默认克隆主分支(main 或 master)可能包含未发布的半成品代码或不稳定的构建脚本。建议先查看 Release 列表,拉取经过严格测试的稳定发布标签:
# 以克隆 HTTPX 稳定版本为例
git clone --depth 1 --branch 0.27.0 https://github.com/encode/httpx.git
cd httpx
步骤 2:创建并激活独立隔离沙箱
利用 Python 原生模块 venv 创建项目专用的沙箱目录,避免全局污染:
# 创建独立的虚拟环境
python3 -m venv .venv

# 激活环境 (Linux/macOS)
source .venv/bin/activate

# 激活环境 (Windows PowerShell)
# .venv\Scripts\Activate.ps1
步骤 3:以可编辑模式安装项目及测试依赖
使用 -e 参数安装当前仓库源码,并将依赖安装到激活的虚拟环境中。这一步至关重要,它会在虚拟环境中建立指向源码目录的符号链接(.pth 文件)。修改源码后无需重新编译安装,即可实时生效:
# 升级本地 pip 保证兼容标准 pyproject.toml
pip install --upgrade pip

# 以可编辑模式安装当前项目与开发测试依赖组
pip install -e ".[dev,test]"

# 验证测试套件是否能正常运行
pytest tests/ -k "test_get"
步骤 4:通过内置断点单步跟踪核心调用链
在项目示例或测试文件中插入 Python 3.7+ 原生支持的 breakpoint()。当运行测试或示例脚本时,程序会在指定位置挂起并进入 pdb 交互界面:
# 在想要探索的核心入口处插入断点
import httpx

def test_trace():
    # 插入断点:终端将在此处暂停
    breakpoint()
    client = httpx.Client()
    response = client.get("https://httpbin.org/get")
    print(response.status_code)

if __name__ == "__main__":
test_trace()pdb 交互模式后,输入 s(Step Into)可单步进入被调用的函数内部;输入 n(Next)单步执行下一行;输入 w(Where/Stack)打印当前函数调用栈。这是观察参数传递与状态变更最直观的途径。
四、大项目源码逆向学习法与关键避坑指南
很多开发者在面对数万行开源项目时感到挫败,根本原因在于采用了“从第一个文件按字母顺序从头读到尾”的错误方式。对于经过严密架构设计的项目,推荐采用逆向切入法:
- 从入口定义切入:首先打开
pyproject.toml或setup.py,查看[project.scripts]或entry_points配置。它指明了项目作为可执行程序启动时的首个函数位置(例如main.py:cli)。直接由此处作为阅读起点。 - 由测试用例反推接口设计:进入
tests/目录,找寻命名最基础的单元测试(如test_client.py)。测试用例通常由三部曲组成:准备数据(Arrange)、调用方法(Act)、断言校验(Assert)。通过阅读 Assert,可以最直接地得知开发者设计的预期结果,免去了凭空猜测数据结构的过程。 - 自顶向下跟踪单一调用链:挑选一个最常用的最小功能(例如发起一次 GET 请求,或者解析一个 HTML 节点),使用前文所述的断点调试,自顶向下观察调用栈的深入过程。忽略掉分支异常逻辑与日志处理,仅记录主干流程跨越了哪些类和方法。
- 避免在复杂动态元编程中迷失:部分大型项目(如 SQLAlchemy、Django)大量使用了元类(Metaclass)、装饰器堆叠与动态属性挂载(
__getattr__)。初读时切勿过早在这些黑魔法细节上纠缠,应先勾勒出骨架数据流,待掌握整体轮廓后再深入探究具体实现机制。
五、总结:从阅读源码到工程能力落地的跃升模型
下载并研读 GitHub 上的 Python 开源项目,其最终目的并非单纯记忆某个第三方库的内部实现,而是将优秀的软件工程规范内化为自身的编程本能。从“跑通源码”、“读懂设计”到“能力转化”,形成一个完整的正向反馈闭环:
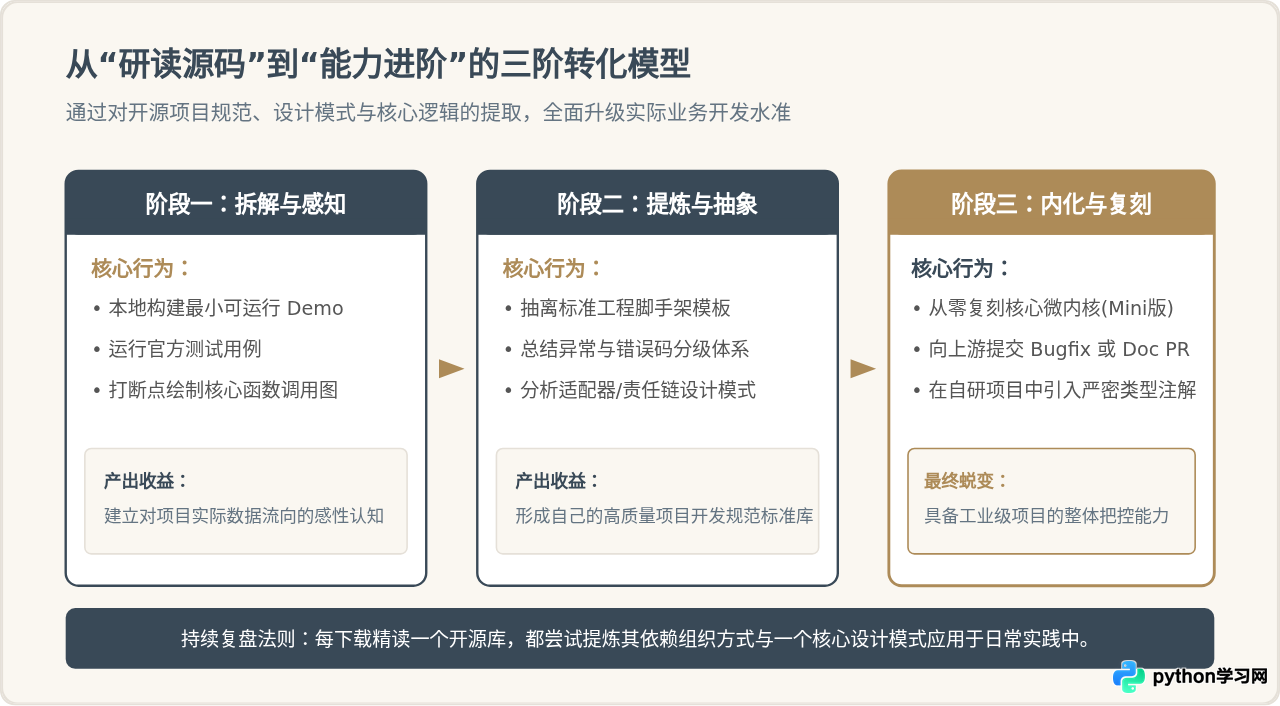
通过遵循规范的评估流程、搭建干净的本地调试环境、并配合测试驱动的逆向追踪方式,阅读开源源码将不再是一项枯燥的任务,而会成为开发者快速汲取前人智慧、建立严谨工程思维的最有效捷径。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















