


Python集合求并集:|运算符与union()方法详解
在Python中计算多个集合的并集,最主要的方式有两种:使用按位或管道运算符 |,或者调用集合对象的 union() 方法。它们的核心功能完全相同——汇总所有参与运算的集合元素并剔除重复项,返回一个全新的集合。但两者在操作数类型支持、可读性及容错度上存在关键差别。
一、集合并集的概念与底层去重逻辑
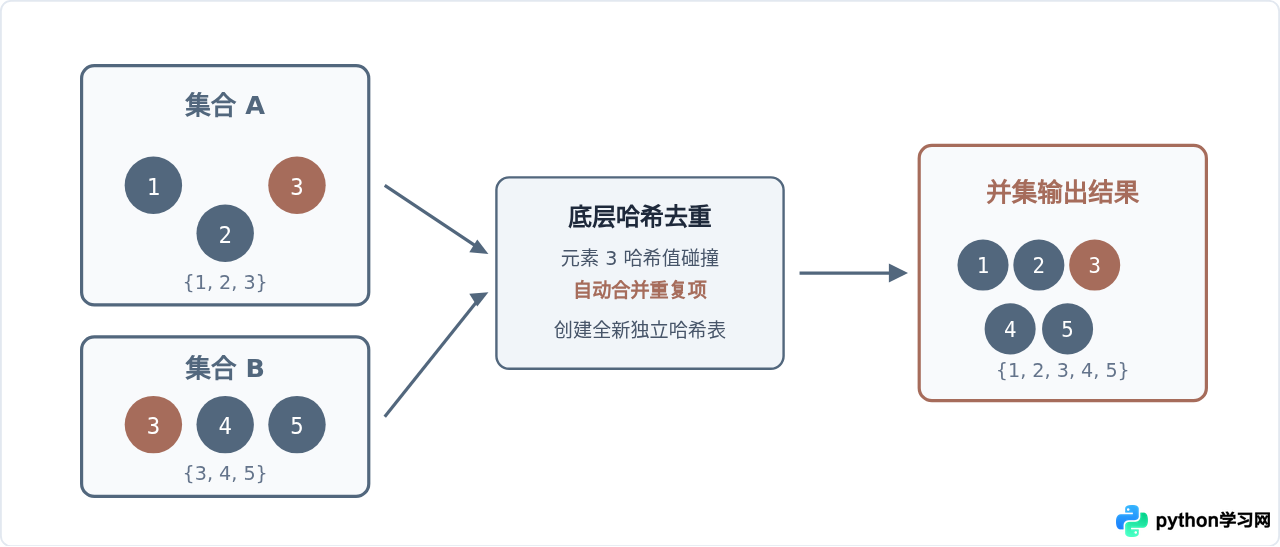
在数学集合论中,两个集合 A 和 B 的并集表示包含所有属于 A 或属于 B 的元素组成的集合。在Python中,集合(set)是以哈希表为底层实现的可变容器,其核心特征之一便是元素的互异性(唯一性)。
当执行求并集操作时,Python解释器会遍历各个输入对象中的元素,将其键值依次插入到新开辟的哈希表中。哈希表依靠对象的哈希值(Hash Code)进行位置寻址,一旦遇到哈希值与已有元素一致且通过相等性检查(==)为真的值,便会自动忽略该重复项。这一过程保证了最终生成的集合中每个元素仅出现一次,且平均时间复杂度为 O(len(A) + len(B))。
二、使用 | 运算符求并集
| 符号借用了按位或运算的操作符,在Python集合上下文中被重载为集合并集运算。这种书写形式极为简明直观,贴近数学符号风格,非常适合用于集合间的快速逻辑运算。
基础语法与多集合链式运算
使用 | 运算符时,只需将两个或多个集合用 | 连接即可。当存在三个及以上集合时,可以通过链式表达式连续合并:
# 定义三个集合
group_a = {"apple", "banana"}
group_b = {"banana", "orange"}
group_c = {"grape", "apple"}

# 双集合求并集
result_ab = group_a | group_b

# 多集合链式求并集
result_all = group_a | group_b | group_c

print("A与B的并集:", result_ab)
print("A、B、C的完整并集:", result_all)严格的操作数类型限制
| 运算符对操作数类型有严格限制:所有参与运算的对象必须都是集合类型(set 或 frozenset)。如果尝试将集合与列表、元组或字典直接使用 | 连接,Python会立即抛出 TypeError。
set_data = {1, 2, 3}
list_data = [3, 4, 5]

# 错误示例:混合类型使用 | 运算符
try:
    bad_result = set_data | list_data
except TypeError as error:
print("捕获异常:", error)三、使用 union() 方法求并集
union() 是 set 对象内置的原生方法。其方法签名为 set.union(*others),支持传入零个或多个可迭代对象作为参数。
宽容的参数类型支持
与 | 运算符最核心的差异在于:union() 方法只要求调用者本身是集合,而其后所跟的参数可以是任何可迭代对象(Iterable),包括列表(list)、元组(tuple)、字典(dict)、字符串、集合以及生成器推导式等。Python会自动遍历传入的可迭代对象,并将各个元素加入到新生成的并集集合中。
base_set = {10, 20}
data_list = [20, 30]
data_tuple = (30, 40)
data_dict = {40: "value", 50: "value"}  # 字典默认迭代其键(keys)

# 同时传入多种不同类型的序列
result = base_set.union(data_list, data_tuple, data_dict)
print("union方法合并多种序列的结果:", result)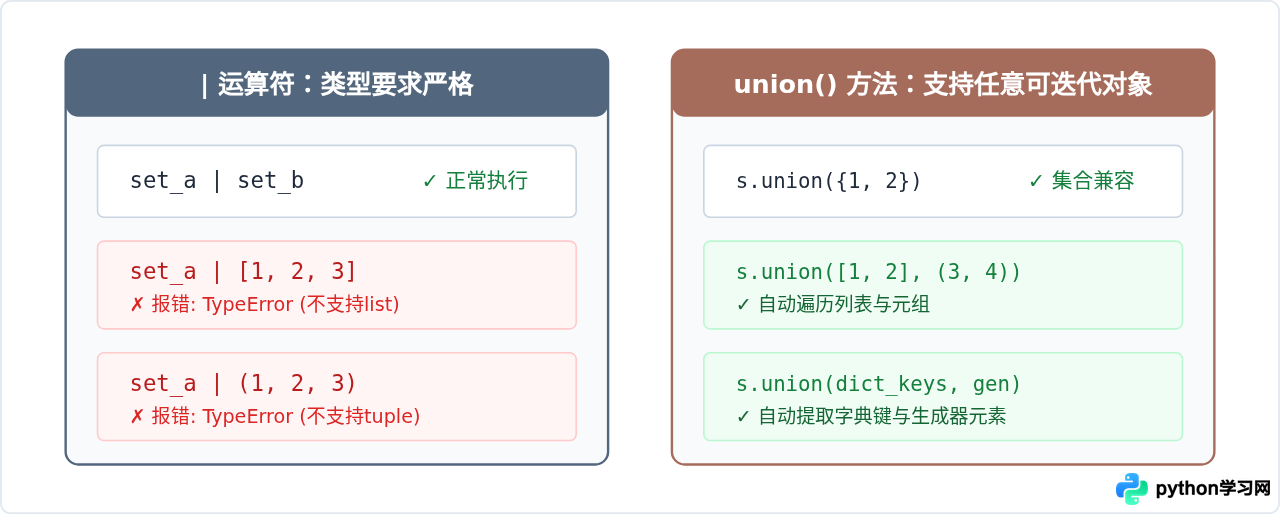
四、集合求并集的操作步骤与实现细节
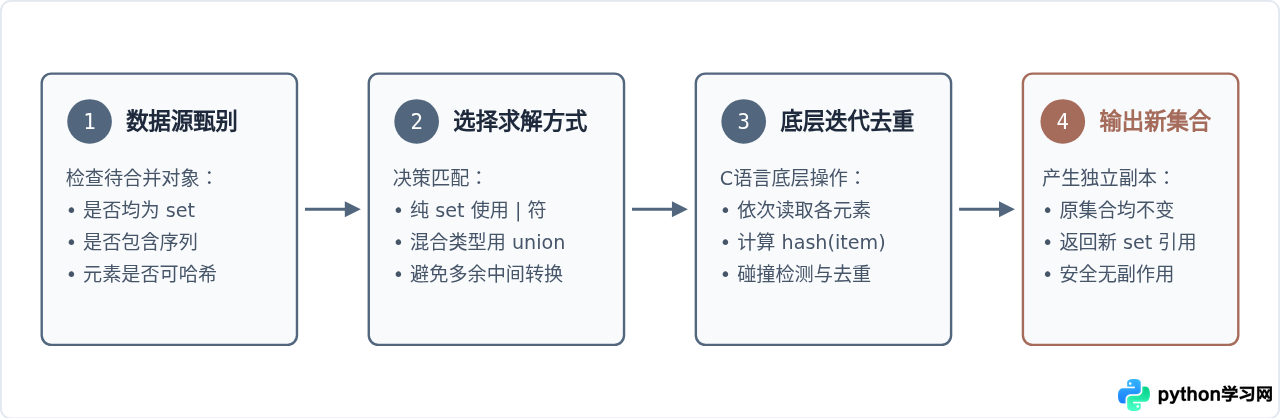
在工程实践中,为了确保代码健壮且兼顾性能,通常遵循一套标准的执行流程:从识别输入源的数据结构开始,按需选择最合适的运算方式,再利用哈希去重生成目标对象。
重要细节一:原集合对象的不变性
无论是 A | B 还是 A.union(B),它们都会开辟一块全新的内存空间存放结果,绝不会对原有集合 A 或 B 产生任何修改。这在函数式编程和避免副作用的场景中至关重要。
original_set = {1, 2}
another_set = {3, 4}

new_set = original_set.union(another_set)

# 验证原集合是否保持独立与不变
print("原集合是否发生变化:", original_set)
print("新生成的并集:", new_set)
print("内存地址是否不同:", original_set is not new_set)重要细节二:不可哈希(Unhashable)元素的约束
集合中的每个元素必须是可哈希的不可变对象(如数字、字符串、元组、frozenset)。当使用 union() 传入包含可变对象(如列表、字典)的可迭代对象时,虽然外层容器能被顺利遍历,但在逐个放入集合时仍会触发错误:
s = {1, 2}
invalid_items = [[3, 4], [5, 6]]  # 包含列表的可迭代对象

try:
    s.union(invalid_items)
except TypeError as error:
print("错误提示:", error)五、补充延伸:就地更新已有集合(|= 与 update)
如果不需要保留原集合,而是希望直接将其他集合或序列的元素追加到当前集合中,Python提供了对应的“就地修改”(In-place update)语法:
|=运算符(按位或赋值):等价于s.__ior__(other),要求右侧操作数同样必须是set。update(*others)方法:直接修改原集合,接收任意多个可迭代对象作为参数。
# 演示 update() 就地修改
main_pool = {"user_1", "user_2"}
new_registered = ["user_2", "user_3", "user_4"]

# 直接将新用户列表合并进主池中
main_pool.update(new_registered)
print("就地更新后的主池:", main_pool)六、选择策略与总结
在编写日常代码时,选用 | 还是 union() 取决于实际的应用场景与数据输入来源:
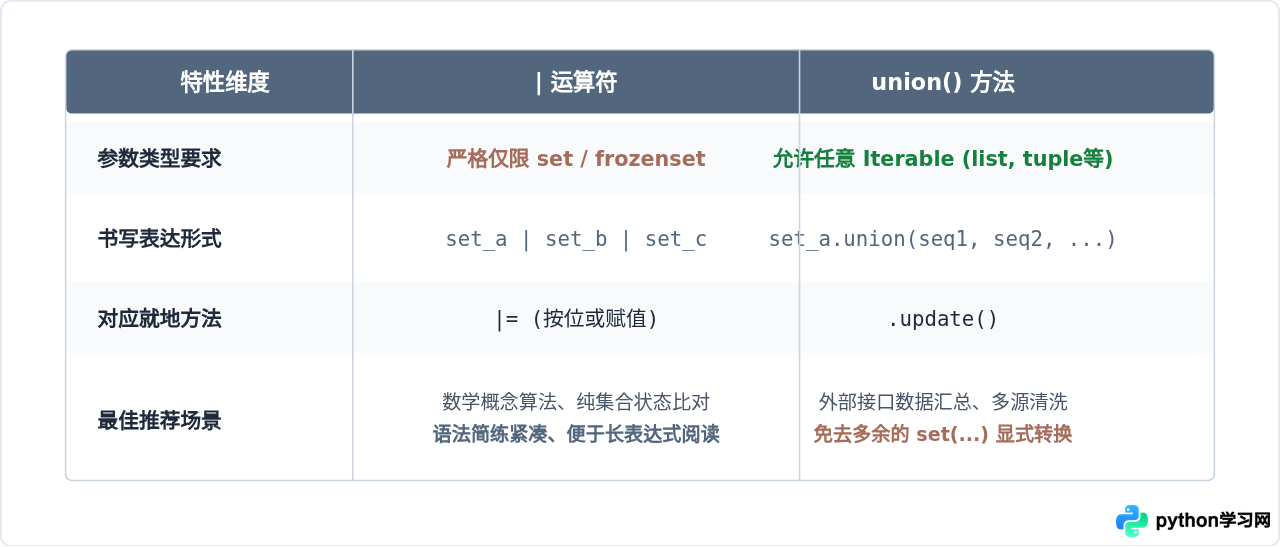
当所有操作数已知均为集合且偏好简练的代码风格时,优先选用 | 运算符;而当合并的数据源来自函数返回值、数据库查询列表、文件读取等不可控类型时,选用 union() 方法能够省去多余的类型转换步骤,并提供更强的鲁棒性。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















