


Python字符串切片返回空字符串的常见情况

s[start:stop:step] 截取字符串时,如果指定的区间在指定方向上无法选出任何字符,解释器不会抛出 IndexError 异常,而是直接返回一个空字符串 ""。这种“容错设计”虽然避免了程序中断,但也容易掩盖索引计算或方向推导中的逻辑偏差。
一、切片的底层工作机制与取值规则
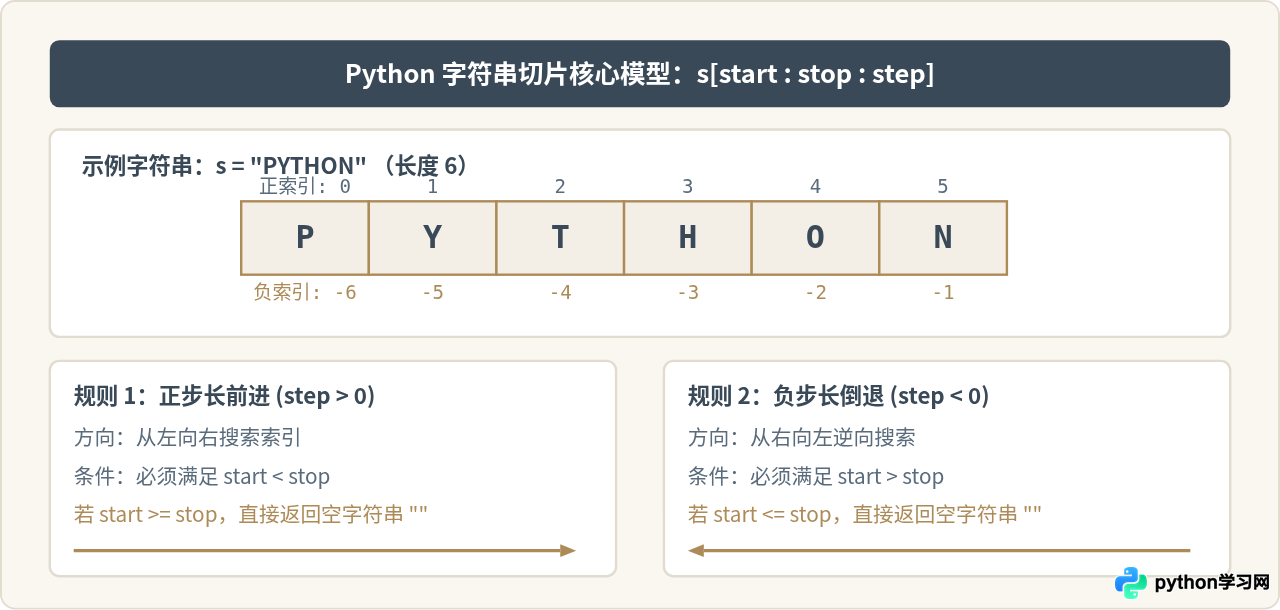
要理解切片为何返回空字符串,首先需要明确 Python 切片的核心取值机制。切片通过三元组 [start:stop:step] 定义截取规则:
- 起始位置
start:包含在抽取结果中的第一个字符索引(默认为字符串开头或末尾,由步长符号决定)。 - 结束位置
stop:截取的终止边界,采用左闭右开(或方向上的开区间)原则,该位置字符不包含在结果中。 - 步长
step:每次递增或递减的偏移量,默认为 1。它的正负符号决定了切片的搜索方向。
切片提取本质上是一个循环过程:从 start 开始,每次将当前索引累加 step,只要当前索引尚未跨越或达到 stop 边界且位于有效字符串范围内,就取出对应字符。如果初始条件即不满足递进方向,循环直接终止,输出即为空字符串。
二、导致切片返回空字符串的四大典型情况
1. 正步长下起始位置不小于结束位置(start >= stop)
这是初学者最容易遇到的情况。当未指定 step(默认为 1)或指定 step > 0 时,切片期望沿着从左向右(索引递增)的方向截取。如果此时给定的 start 在物理位置上位于 stop 的右侧,截取区间即为空。
s = "Python"

# start=4, stop=2,正步长要求从索引4往右走到2,无法到达
result = s[4:2]
print(repr(result))  # 示例输出:''

# 即使只差1个位置,只要 start >= stop 依然为空
print(repr(s[3:3]))  # 示例输出:''
2. 负步长下起始位置不大于结束位置(start <= stop)
当使用负步长(如 step = -1)反向截取时,搜索顺序转变为从右向左递减。此时要求 start 必须在 stop 的右边。如果误按常规思维将较小的索引写在前面,就会返回空字符串。
s = "Python"

# 期望倒序截取前3个字符,但误写为 1:4:-1
result = s[1:4:-1]
print(repr(result))  # 示例输出:''

# 正确写法:起点必须大于终点
correct = s[4:1:-1]
print(repr(correct))  # 示例输出:'oht'
3. 起始与结束索引完全重合(start == stop)
因为切片采用左闭右开区间 [start, stop),数学上区间长度为 stop - start。当两端数值相等时,所包含的离散元素个数严格为 0。无论步长为正还是负,结果必然为空字符串。
s = "Hello"
print(repr(s[2:2]))     # 示例输出:''
print(repr(s[0:0]))     # 示例输出:''
print(repr(s[-2:-2]))   # 示例输出:''
print(repr(s[3:3:-1]))  # 示例输出:''
4. 正负索引混用导致逻辑区间倒置
Python 允许负数索引,负数索引会被自动转换为 index + len(s)。在混合使用正数和负数时,如果换算后的实际绝对索引与步长方向发生冲突,就会得到空字符串。
s = "abcdef"  # len(s) = 6

# start = 4, stop = -4
# -4 等价于 6 + (-4) = 2
# s[4:-4] 实际相当于 s[4:2],默认步长+1向右移动,无法取值
print(repr(s[4:-4]))  # 示例输出:''

# 同理,负步长下混用错误:
# start = 1, stop = -1 (-1 等价于 5)
# s[1:-1:-1] 相当于 s[1:5:-1],负步长向左移动,起点小于终点
print(repr(s[1:-1:-1]))  # 示例输出:''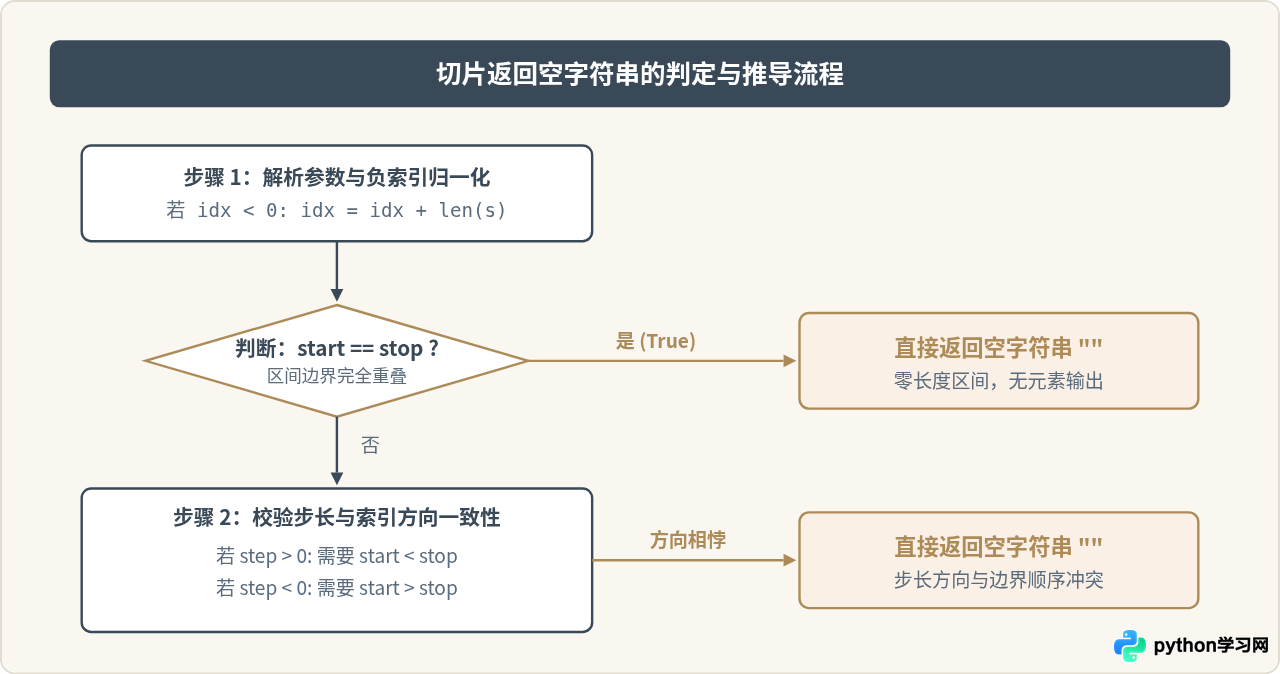
三、边界截断机制与越界切片
Python 对直接索引与切片截取的容错策略完全不同。如果尝试通过单索引访问超出范围的位置(如 s[100]),程序会触发 IndexError: string index out of range。但在切片语法中,Python 会自动将超出范围的边界截断(Clamp)到合法的字符串边界上:
- 如果
start或stop超过字符串最大正向有效范围,会被视为字符串末尾位置len(s)。 - 如果负索引换算后绝对值过大且位于最左侧外,会被截断为 0。
当两个切片参数同时越界在同一侧时,截断后的两端重合,就会静默返回空字符串:
s = "Python"  # len(s) = 6

# 两端均超过长度 6,Python 将 start 截断为 6,stop 截断为 6
# 实际执行 s[6:6]
print(repr(s[10:20]))  # 示例输出:''

# 负向同理:两端都在最左侧之外
# 实际截断为 s[0:0]
print(repr(s[-20:-10]))  # 示例输出:''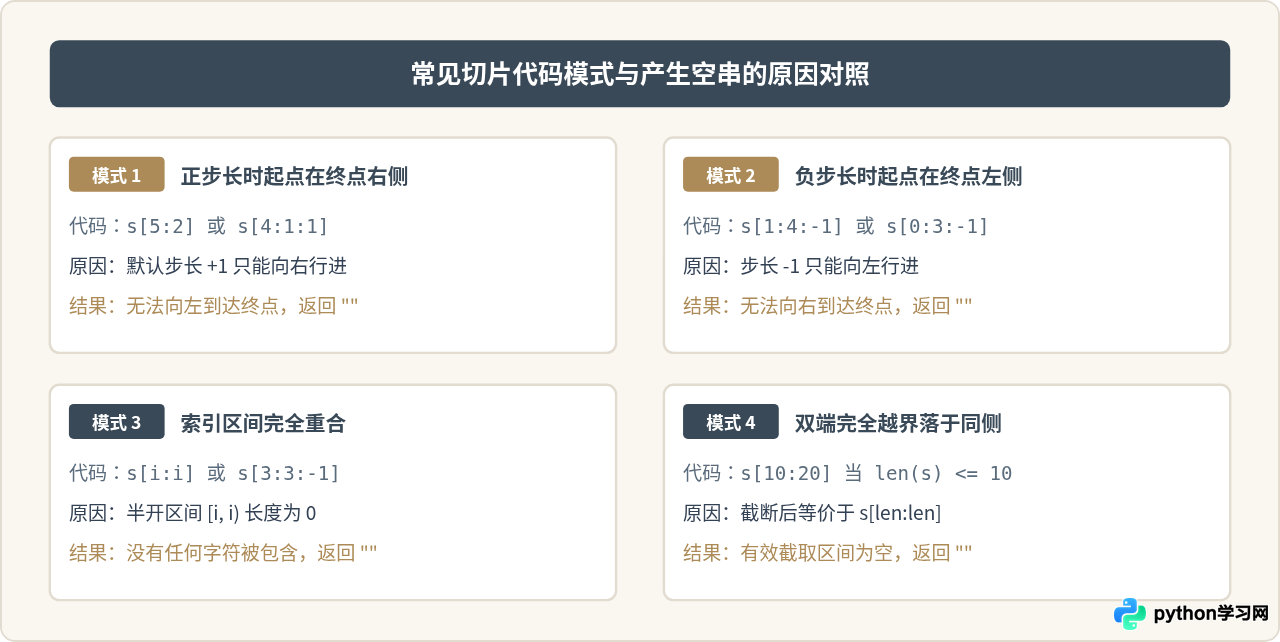
四、容易忽略的边界陷阱与修正技巧
1. 逆序截取到字符串开头的陷阱
当想要逆序截取并包含索引 0 处的字符时,初学者常犯的一个错误是显式指定 stop=0。例如希望逆序提取前 3 个字符(索引 2, 1, 0),误写成:
s = "Python"

# 错误写法:因为开区间不包含 stop,索引 0 的字符被排除
print(repr(s[2:0:-1]))  # 示例输出:'yt'(缺少了 'P')

# 更严重的误写:如果起点写成 0,终点写成 0
print(repr(s[0:0:-1]))  # 示例输出:''(直接为空)

# 正确写法:逆序截取至开头时,必须省略 stop 参数
print(repr(s[2::-1]))   # 示例输出:'tyP'(完整包含索引 0)
2. 动态计算长度时的“静默空串”排查
在实际项目中,切片的 start 和 stop 往往不是硬编码常量,而是通过 str.find()、正则表达式匹配或函数动态传入的。
例如,使用 s.find(sub) 查找子串位置时,若子串不存在会返回 -1。如果不加判断直接放入切片:
text = "user_name_prefix"
idx = text.find("invalid_token")  # 返回 -1

# 开发者本意是从 token 之后截取,结果写了 text[idx:5]
# 实际上由于 idx = -1,-1 对应最后一个字符的前面,导致区间倒置
result = text[idx:5]
print(repr(result))  # 示例输出:''
这种情况下,由于 Python 并没有抛出异常,错误可能在下游模块中以“数据缺失”或“内容未生成”的形式隐蔽出现,增加了排查成本。
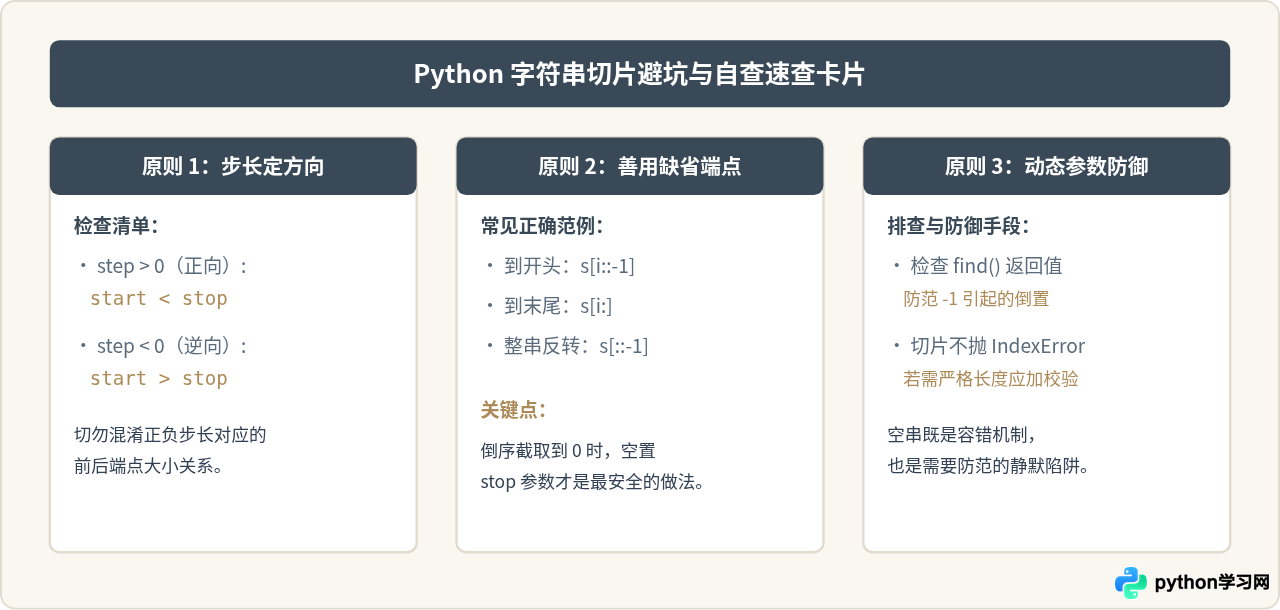
在对动态索引进行切片操作前,先断言或检查 start 与 stop 的逻辑大小关系;对于可能返回 -1 的查找函数,必须先判断返回值是否有效再进行切片。
五、总结
Python 字符串切片返回空字符串,核心在于截取区间与步长行进方向无法闭合出有效的离散字符集合。最普遍的三种原因是:
- 正步长(默认向前)下,
start >= stop; - 负步长(逆向行进)下,
start <= stop; - 在两端索引均越界落在字符串同一侧时,经过 Python 边界截断后区间退化为长度为 0 的区间。
由于切片天然具备容错性,不会因为超出范围或方向错误而崩溃,在编写依赖外部输入或动态索引的切片逻辑时,务必注意显式校验边界,并在需要逆序截取到起始处时利用好省略 stop 的语法特性。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















