


Python可变与不可变数据类型有什么区别
在 Python 中,所有数据都以对象的形式存在,变量本身不存储数值,而是持有对目标对象的内存引用。判断一个数据类型是可变还是不可变,关键在于:当对象包含的内容发生改变时,该对象在内存中的物理地址(即 id())是否保持不变。如果可以在不改变内存地址的前提下就地修改内部数据,就是可变类型;如果任何修改都会迫使 Python 解释器在内存中创建全新对象并赋予新的地址,就是不可变类型。本文将通过内存分析、代码示例、应用场景以及经典陷阱,全面解析两者的核心差异。
一、常见数据类型分类与内存基础
在深入机制前,我们先对 Python 常用的内置数据类型进行归类:
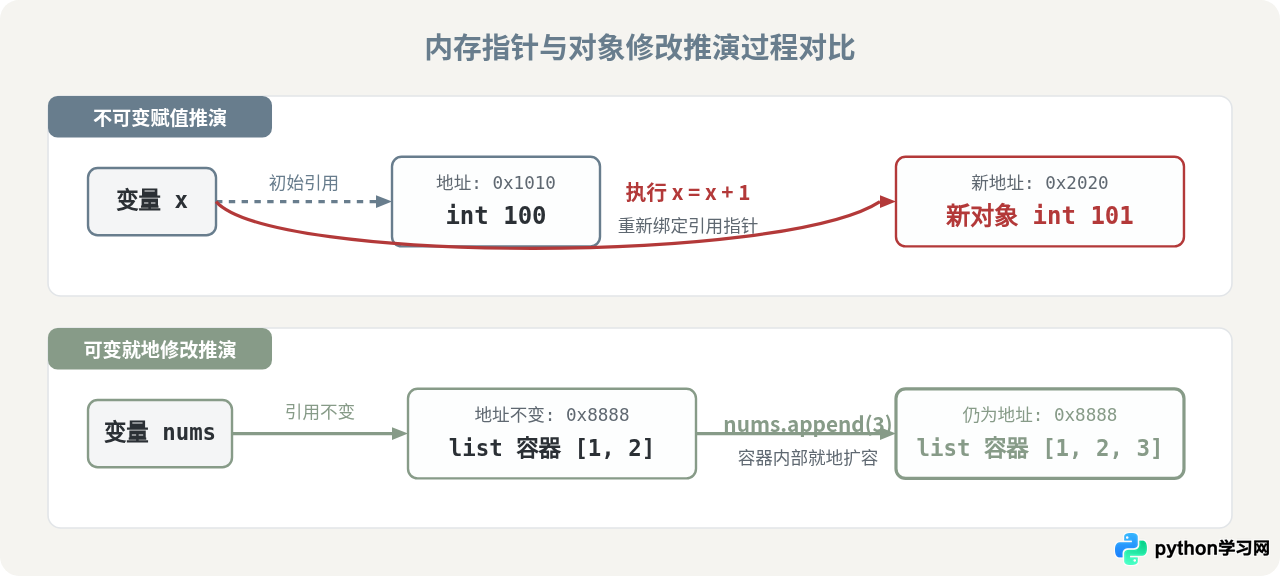
- 不可变类型(Immutable): 整数(
int)、浮点数(float)、布尔值(bool)、字符串(str)、元组(tuple)、冻结集合(frozenset)。 - 可变类型(Mutable): 列表(
list)、字典(dict)、集合(set)、用户自定义的大多数类实例。
Python 提供了内置函数 id(),用来返回对象在运行时的唯一标识符(在 CPython 实现中通常直接对应对象的内存物理地址)。通过观察操作前后 id() 的变化,我们可以直观验证对象的变动情况。
二、内存机制推演与代码对比
为了让读者直观理解修改发生的本质,我们分别用整数(不可变)与列表(可变)进行对比验证。
1. 不可变类型的内存行为(以整数为例)
# 示例代码:观察整数重新赋值过程
x = 100
print("初始 id:", id(x))

x = x + 1
print("修改后 id:", id(x))

# 示例输出:
# 初始 id: 140723901420424
# 修改后 id: 140723901420456
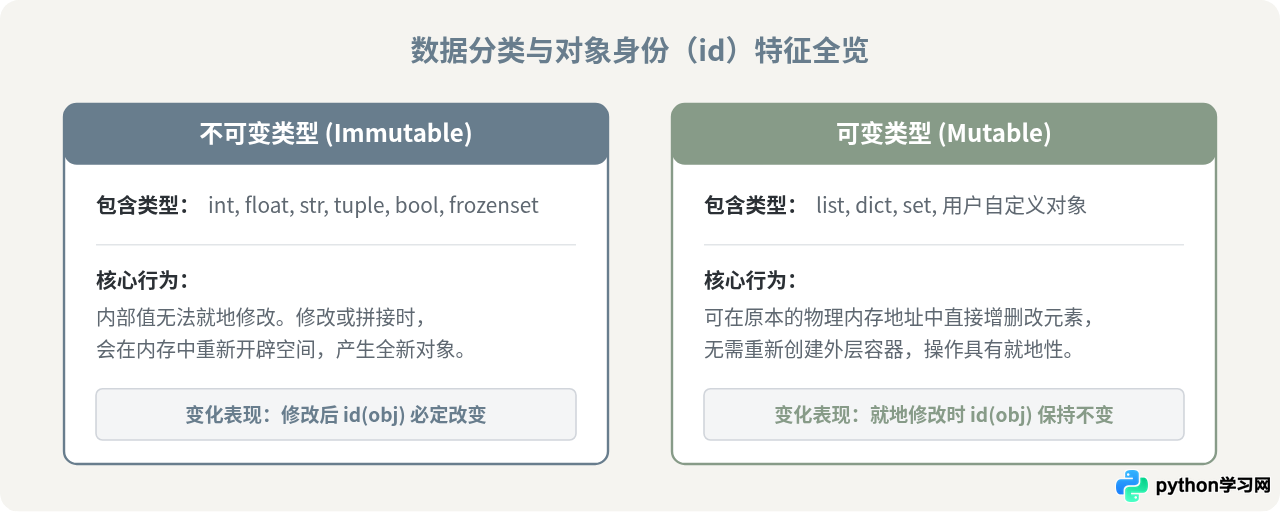
在上述代码中,当执行 x = x + 1 时,并非将原地址中的数值 100 改成了 101,而是 Python 创建了新数值对象 101,并将变量标签 x 重新绑定到了新对象上。原有的 100 对象由于不再被 x 引用,可能会在后续被垃圾回收机制处理。
2. 可变类型的内存行为(以列表为例)
# 示例代码:观察列表就地追加元素过程
nums = [1, 2]
print("初始 id:", id(nums))

nums.append(3)
print("追加后 id:", id(nums))

# 示例输出:
# 初始 id: 2451928014528
# 追加后 id: 2451928014528
可以看到,调用 append() 方法后,nums 的 id 依然完全相同。这表明列表在同一块内存物理结构中扩展了元素,属于真正的“就地变更”。
三、核心区别与特性对比
理解可变与不可变类型的差异,不仅有助于写出符合预期的代码,也是理解 Python 字典键限制、集合运算和参数传递的前提。两者的关键对比如下表所示:
| 对比维度 | 不可变数据类型 (如 int, str, tuple) | 可变数据类型 (如 list, dict, set) |
|---|---|---|
| 就地修改能力 | 不支持。任何修改都会产生新对象 | 支持。直接在原内存区域增删改内部元素 |
| 作为 Dict 的键 | 可以作为键(因为具有哈希值且哈希不可变) | 不可以。会引发 TypeError: unhashable type |
| 作为 Set 的元素 | 可以存入集合 | 不可以存入集合 |
| 多变量引用的安全性 | 极高。不存在一个变量修改污染另一个变量的问题 | 需警惕别名副作用。多个变量指向同一对象时会互相影响 |
| 频繁修改的内存开销 | 频繁微小拼接(如循环 str += ...)会产生大量临时对象 |
预先分配空间并就地扩容,频繁增删效率更高 |
四、极易混淆的进阶场景
1. 包含可变元素的元组:“外壳不可变,内容可变”
元组是不可变的,但这仅意味着元组内部存储的各个元素的内存指针不可被替换。如果元组中的某个元素本身是可变对象(如列表),那么这个列表内部的内容是可以被修改的:
# 示例代码:元组包含列表
tp = (1, [10, 20])
print("修改前元组:", tp)

# 对元组内部的列表进行就地追加
tp[1].append(30)
print("修改后元组:", tp)

# 示例输出:
# 修改前元组: (1, [10, 20])
# 修改后元组: (1, [10, 20, 30])tp 记录的是 1 的地址和列表 [10, 20] 的地址。修改列表后,列表自身的物理地址没有发生变化,因此元组的引用指针并没有被修改,并未违背元组不可变的定义。但正因如此,包含列表的元组是不可哈希的(unhashable),不能作为字典的键。
2. 函数默认参数陷阱:可变类型的长期残留
在定义函数时,如果把可变类型(如 list)作为默认参数,该默认列表只会在函数定义加载时被初始化一次。后续所有使用默认参数的调用,都会共享同一个列表实例:
# 错误示例:默认参数使用可变类型
def add_item_bad(val, target_list=[]):
    target_list.append(val)
    return target_list

print(add_item_bad(1))  # 示例输出: [1]
print(add_item_bad(2))  # 示例输出: [1, 2](并非预期的 [2]!)

# 正确示例:使用不可变对象 None 作为占位符
def add_item_good(val, target_list=None):
    if target_list is None:
        target_list = []
    target_list.append(val)
    return target_list

print(add_item_good(1))  # 示例输出: [1]
print(add_item_good(2))  # 示例输出: [2]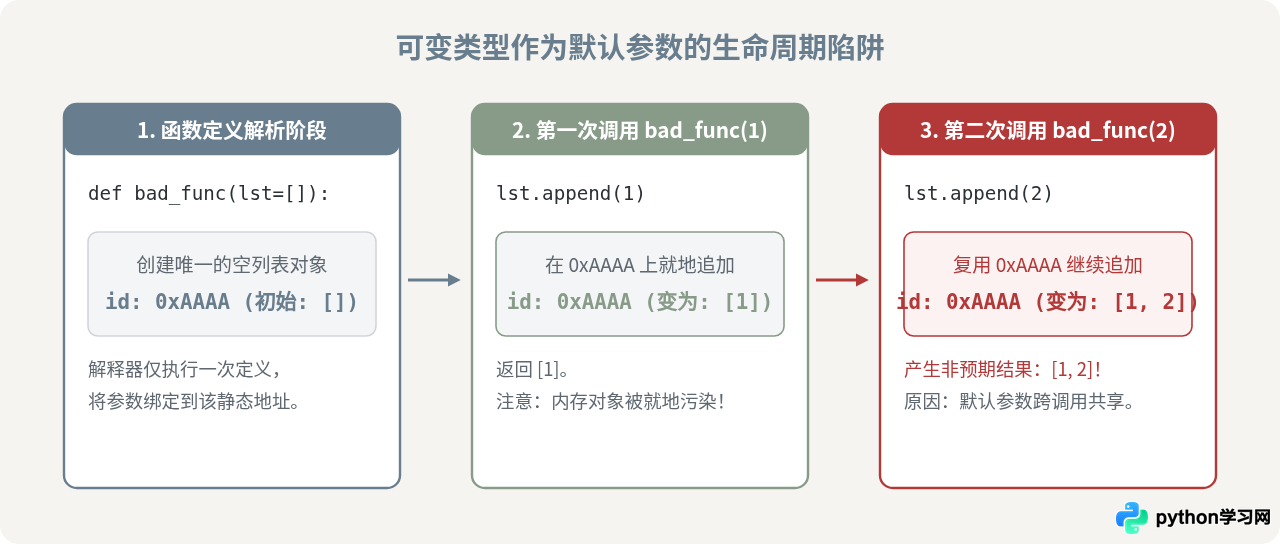
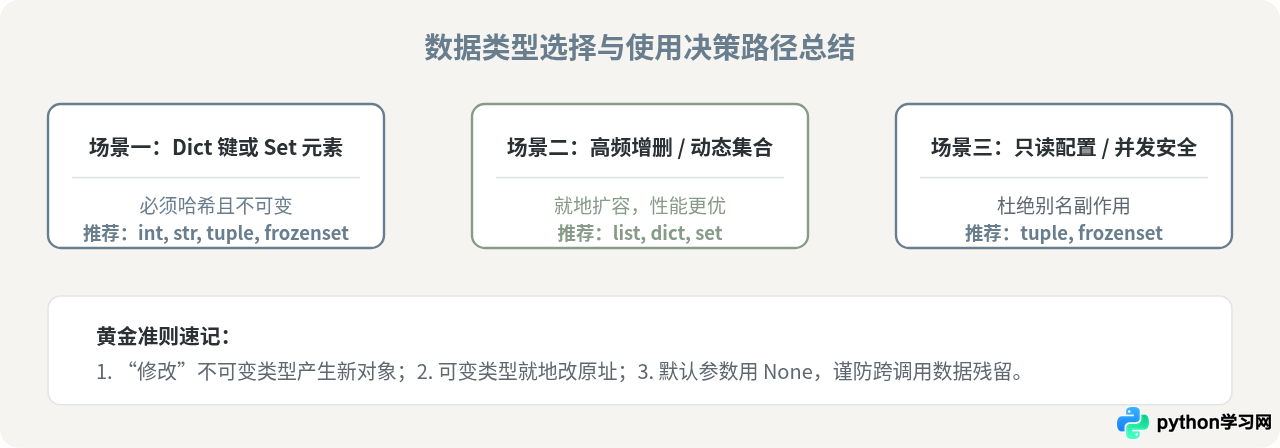
五、日常开发中的安全使用与选择指南
在掌握了机制之后,如何正确运用这两类数据结构?我们可以遵循以下工程建议:
- 作为状态传递与只读数据时:优先使用不可变类型。元组和字符串天然防篡改,在多线程并发读场景下无需锁机制即可保证安全;同时也是作为哈希键的唯一选择。
- 需要频繁批量更新数据集合时:使用可变类型。可变类型避免了频繁申请内存与垃圾回收的开销。例如,当需要循环拼接字符串时,不要使用
str += s,而应将字符收集到列表(list)中,最后使用"".join(list)一次性生成。 - 需要独立隔离可变对象时:使用深浅拷贝。直接赋值
b = a仅复制指针,任何一方修改都会影响另一方。若需隔离顶层容器,使用b = a.copy();若容器内部嵌套了可变子对象,应使用copy.deepcopy(a)。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















