


为什么C语言比Python快?内存管理与执行效率的底层原理
一、执行机制差异:原生机器指令与字节码解释循环
计算机的中央处理器(CPU)只能识别并执行具体的机器指令序列(如 x86-64 或 ARM 指令集)。C 语言与 Python 在将人类编写的代码转换为 CPU 硬件动作的过程中,采用了完全不同的处理管线。
C 语言是一门**纯静态编译型语言**。在代码运行前,编译器(如 GCC 或 Clang)会完整遍历源文件,进行语法分析、数据流优化、循环展开与寄存器分配,最终生成由 0 和 1 组成的目标平台二进制机器码。当操作系统启动 C 程序时,这些机器码被直接加载到内存的代码段中,由 CPU 程序计数器逐条拉取并在硬件算术逻辑单元(ALU)中执行,整个运行期不存在任何语言层面的中间代理。
与此相对,官方的标准 Python(CPython)是一门**解释型动态语言**。Python 运行时首先将源码编译为紧凑的虚拟机字节码(Bytecode),随后由一个巨大的虚拟执行引擎(即著名的 ceval.c 源码中的解释器大循环)接管运行。虚拟机通过无限循环和分支选择机制,逐条读取字节码指令、解码操作码、解析操作数,并调用相应的 C 运行时函数来模拟硬件计算。
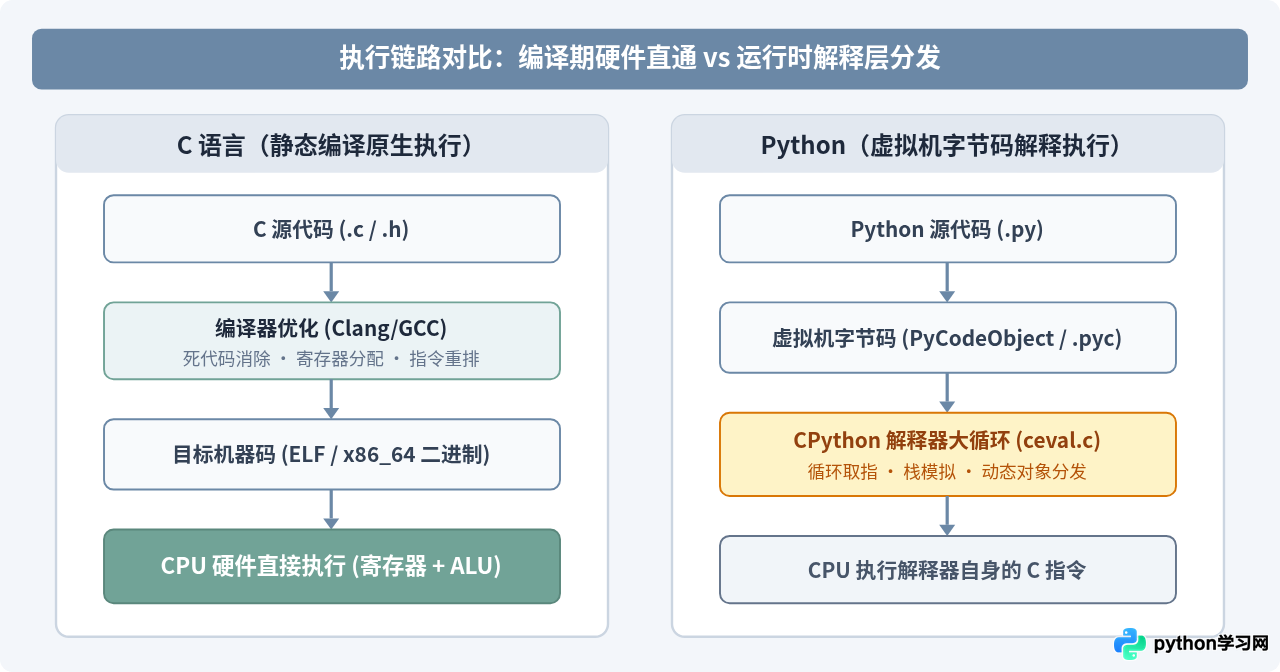
由于 Python 每执行一条字节码,解释器内部都需要完成若干次内存访问、分支判断、操作数出栈与入栈模拟,这使得单纯在“指令分发”这一步上,Python 就已经为每项操作付出了几十倍于硬件时钟周期的额外间接开销。
二、内存模型剖析:原生连续栈内存 vs 繁重的 PyObject 堆对象
两门语言在内存结构与变量承载模型上的设计哲学差异,是决定其运算速度的核心物理要素。
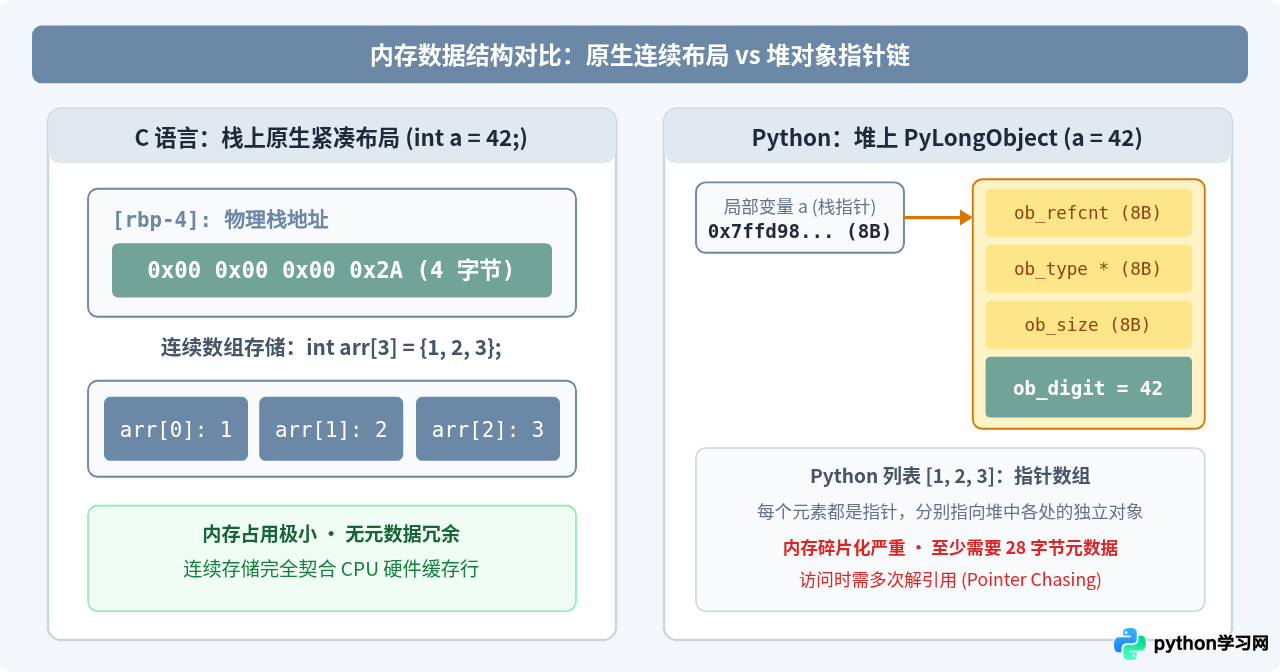
在 C 语言中,变量是对物理内存区域的直观映射。当定义一个整数 int a = 42; 时,系统直接在当前的函数调用栈上划出连续的 4 个字节,并将数值二进制位 0x0000002A 写入该空间。变量名 a 仅存在于编译期的符号表中,在最终的二进制程序中它被转换为基址寄存器加固定偏移量的形式(例如 [rbp-4])。这个过程没有任何动态元数据包装,也没有额外的间接寻址指针。
而在 Python 中,“一切皆对象”。当在 Python 中编写 a = 42 时,创建的并不是一个纯粹的 4 字节整数,而是在堆内存(Heap)中分配的一个庞大结构体——PyLongObject。这个结构体在 64 位系统上至少包含:
- ob_refcnt(8 字节):引用计数器,用于跟踪当前对象被引用的次数以辅助垃圾回收;
- ob_type(8 字节):指向其类型对象(
PyTypeObject*)的指针,用于在运行时动态查询支持的方法与运算协议; - ob_size(8 字节):记录多精度整数包含的数字单元数量及正负符号;
- ob_digit(4 或 8 字节):用于存储实际数值的数组。
这意味着原本仅需 4 字节存储的标量数据,在 Python 中被膨胀成了至少 28 字节的堆对象。而局部变量 a 本身只是一个保存在局部变量表中的 8 字节指针,指向这个位于堆中的结构体。
三、运算路径解剖:一条硬件指令与数百次虚拟机调度的差距
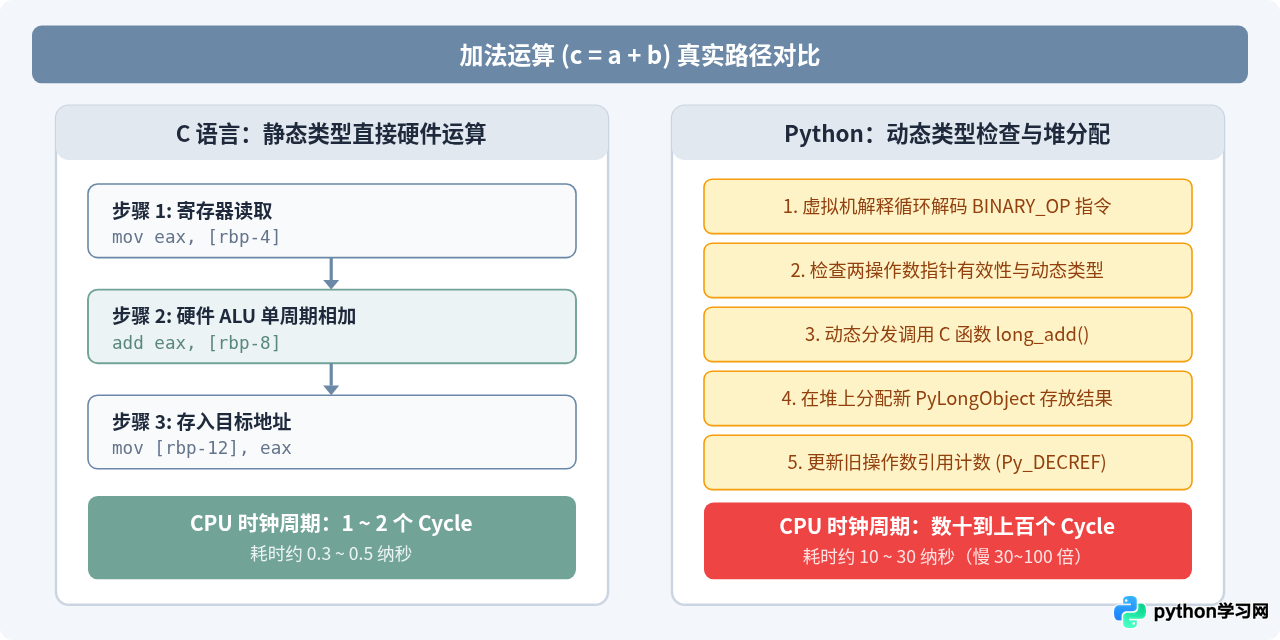
当我们写下一个极为简单的加法表达式 c = a + b 时,底层的计算机硬件究竟执行了多少操作?对比这两门语言的汇编与 CPython 源码,能直观展现速度悬殊的技术实质。
1. C 语言的加法运算流程
// C 源代码
int a = 10;
int b = 20;
int c = a + b;

; 编译生成的 x86-64 汇编指令(未开启最高优化时的标准形态)
mov  eax, DWORD PTR [rbp-4]    ; 将变量 a 的数值加载到寄存器 eax
add  eax, DWORD PTR [rbp-8]    ; 将变量 b 的数值直接在 ALU 中相加
mov  DWORD PTR [rbp-12], eax   ; 将加法结果直接存入变量 c 的内存地址
在开启 -O2 或 -O3 优化后,编译器甚至会在编译期直接完成常量折叠,将 c 的值计算为 30,运行时耗时为 0;即便变量来自外部输入,现代处理器在一个或两个时钟周期(不到 1 纳秒)内即可完成硬件级的加法运算。
2. Python 的加法运算流程
在 Python 中,同一行代码 c = a + b 编译出的字节码为 BINARY_OP (NB_ADD)。执行该指令时,CPython 虚拟机会经历如下一系列繁复流程:
- 从虚拟机栈顶弹出两个
PyObject*对象的指针; - 检查两个指针是否为有效的对象结构;
- 读取对象的
ob_type,动态判断两者的类型(是整数、浮点数、字符串拼接还是自定义类的运算符重载); - 发现均为整数后,调用数字协议虚函数表中的
long_add方法; - 在堆中申请一块新的内存空间用于容纳结果对象(或在小整数缓存区间
[-5, 256]内检索); - 在新对象中计算并写入数值,并将其
ob_refcnt初始化为 1; - 将参与运算的操作数引用计数减 1(
Py_DECREF),若降为 0 则触发析构; - 将新生成的
PyObject*压回虚拟机计算栈。
四、CPU 缓存局部性与内存垃圾回收
计算机体系结构的研究表明,现代 CPU 访问寄存器只需约 0.5 纳秒,访问 L1 高速缓存需约 1 纳秒,而访问主内存(DRAM)则需要高达 50 至 100 纳秒。因此,**CPU 高速缓存命中率(Cache Locality)**往往是决定现代软件实际运行速度的最核心瓶颈。
1. 空间局部性与缓存行(Cache Line)
CPU 从内存读取数据时,不是按字节读取,而是以 64 字节为一个**缓存行(Cache Line)**批量载入。
- C 语言的数组遍历:若声明
int arr[1000000];,这些整数在物理内存中紧密相连。当 CPU 读取arr[0]时,硬件预取单元会自动将其后连续的十几个整数一次性载入 L1 缓存中。随后的循环访问将 100% 命中缓存,流水线全速推进。 - Python 的列表遍历:若声明
lst = [1, 2, 3, ...],列表本身存储的只是PyObject*内存地址数组。访问每个元素时,CPU 必须通过指针去堆内存的不同位置读取具体对象。由于堆分配过程的随机性,这些对象散落在内存各个角落,导致频繁的 CPU Cache Miss,处理器大部分时间都在“空转”等待内存总线传输数据。
2. 内存回收的即时性与垃圾回收开销
C 语言的大部分局部变量都驻留在调用栈中,当函数执行完毕返回时,只需一条简单的 add rsp, 0x20 指令调整栈顶指针,整个栈帧的内存就在一个时钟周期内全部瞬间释放。堆内存通过 malloc / free 按需申请和释放,运行时不存在后台跟踪任务。
而 Python 的内存管理依赖两套互相关联的机制:**引用计数(Reference Counting)**和**分代循环垃圾回收器(Generational GC)**。每当变量发生赋值、参数传递或从函数返回时,解释器都必须增加或减少对应对象的引用计数。为了解决循环引用导致的内存泄漏,Python 还需要定期暂停业务逻辑,遍历三代堆对象链表排查可疑环路。这些机制带来了不可忽视的隐形性能惩罚。
五、底层核心要素总结与技术选型权衡
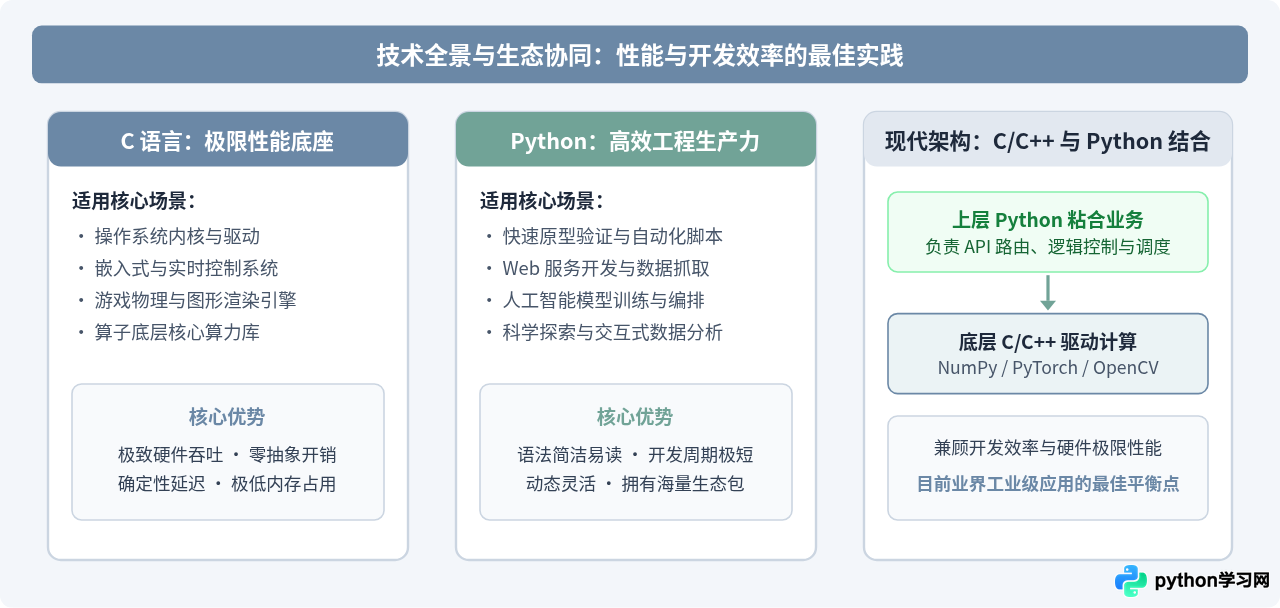
综合前述分析,C 语言对 Python 的性能优势并不是某一个单一特性的结果,而是软硬件全链路协同优势的集中体现。下表全面归纳了两者的底层技术特征:
| 对比维度 | C 语言 (C99/C11) | Python (标准 CPython) | 性能影响权重 |
|---|---|---|---|
| 执行模型 | 编译为原生机器码,CPU 硬件直接执行 | 字节码循环解释执行,虚拟机模拟硬件 | 极高(产生基础指令倍率差距) |
| 数据封装 | 原生标量,4 字节纯粹数值 | PyObject 堆结构体,至少 28 字节封装 | 高(内存膨胀与间接指针解引用) |
| 类型决策 | 编译期确定,静态绑定偏移量 | 运行时动态类型检查与协议方法查找 | 高(带来大量分支跳转与预测失败) |
| 缓存友好度 | 内存物理连续,极高 L1/L2 命中率 | 指针链式分散寻址,频繁 Cache Miss | 极高(现代 CPU 瓶颈在于等待内存) |
| 内存回收 | 栈帧指针瞬间升降,手动/显式管理 | 频繁维护引用计数与多代循环 GC 扫描 | 中高(常态运行时微观开销) |
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















