


Python re模块中match、search和findall的区别与用法
在 Python 正则表达式处理中,re.match、re.search 和 re.findall 是最频繁被调用的三个函数。它们在表面上都可以用于模式匹配,但底层扫描逻辑、起始查找位置以及返回的数据结构存在根本性的差异:match 专用于判定字符串是否从头部即符合规则;search 用于在整段字符串中寻找第一个命中项;而 findall 则用于收集文本中所有不重叠的匹配内容。理解这三者的核心边界与行为差异,是编写稳定、高效正则处理逻辑的基础。
一、核心扫描机制与判定范围对比
区分这三个函数的第一步,是明确它们在处理目标字符串时的“搜索起点”与“检索深度”。
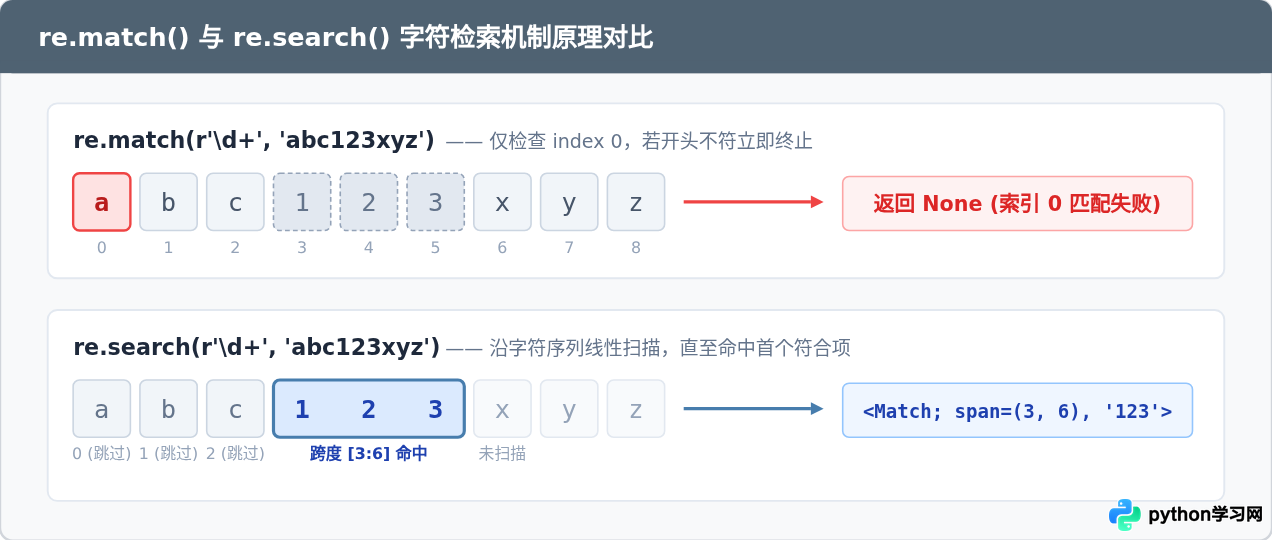
- re.match(pattern, string):仅仅检查字符串的第一个字符(索引 0)是否满足正则表达式。如果起始字符未命中,即使后续文本中存在完全符合规则的内容,
match也会直接判定失败并返回None。 - re.search(pattern, string):会对字符串从头到尾进行全局线性扫描。它不要求模式出现在开头,只要在整串中的任意位置发现第一个匹配项,就会立刻停止扫描并返回包含该匹配信息的
Match对象。 - re.findall(pattern, string):同样进行全文本扫描,但它不会在遇到第一个结果时终止,而是持续遍历整个字符串,提取出所有非重叠的匹配片段,并以列表形式一次性返回。
二、re.match 的用法与行为特征
re.match 的核心属性是“头部锚定”。即使你在正则表达式中没有明确书写 ^ 符号,match 也会在内部强制绑定字符串起点。
1. 基本语法与成功匹配
import re

pattern = r"\d+"
text_valid = "2026-10-26 report.log"

result = re.match(pattern, text_valid)
if result:
    print("匹配成功!")
    print("匹配文本:", result.group())
    print("起止位置:", result.span())
else:
print("未命中")匹配文本: 2026
起止位置: (0, 4)
2. 起始不匹配导致的失败
如果在相同模式下,文本开头加入了空格或其它非数字字符,match 会立刻返回 None:
text_invalid = "Date: 2026-10-26"
result = re.match(pattern, text_invalid)
print(result) # 输出: Nonere.match 的返回值调用 .group() 是非常高频的报错来源。当匹配失败返回 None 时,会抛出 AttributeError: 'NoneType' object has no attribute 'group'。始终先做布尔值判断,或使用 Python 3.8+ 海象运算符。
三、re.search 的用法与行为特征
re.search 取消了必须从头匹配的限制,它负责在字符串中寻找“任何满足条件的第一个锚点”。
1. 寻找文本中的首个目标
import re

pattern = r"\d+"
text = "Order #8972 was shipped, tracking: 994012"

match_obj = re.search(pattern, text)
if match_obj:
    print("首次命中内容:", match_obj.group())
print("在原串中跨度:", match_obj.span())在原串中跨度: (7, 11)
可以看到,虽然文本开头是 Order #,但 re.search 依然成功找到了位于索引 7 处的 8972。值得注意的是,它在找到 8972 后就会返回,不会去获取后面的快递单号 994012。
四、re.findall 的用法与捕获分组特性
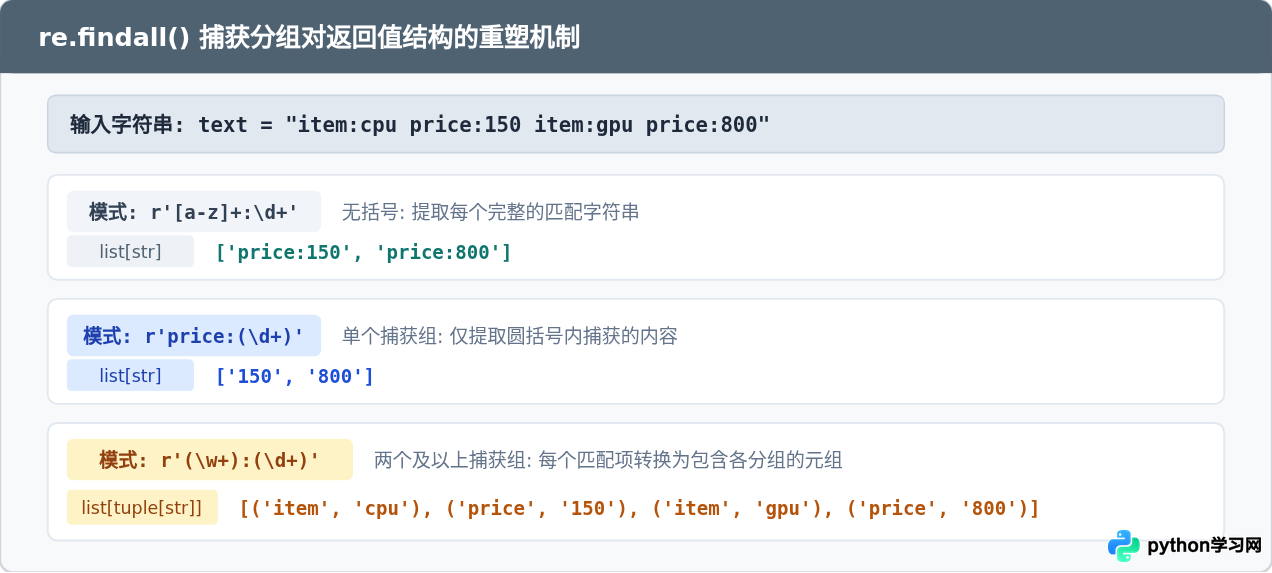
当需要从长文本中抓取所有符合模式的内容时,应使用 re.findall。与前两者不同,findall 并不返回 Match 对象,而是直接返回一个 Python 列表(list)。
更重要的是,re.findall 的返回结果结构会根据正则表达式中是否包含捕获圆括号 () 发生重大变化。
1. 无捕获分组:获取全部完整匹配
import re

text = "User Alice: 25 years old; User Bob: 30 years old."
# 查找所有连续数字
ages = re.findall(r"\d+", text)
print(ages)2. 包含单个捕获组:只提取目标子字段
如果你只想获取用户名,而不希望结果中保留 User 前缀,给目标加上括号即可:
users = re.findall(r"User\s+([A-Za-z]+):", text)
print(users)3. 包含多个捕获组:按元组批量解析键值对
pairs = re.findall(r"User\s+([A-Za-z]+):\s+(\d+)", text)
print(pairs)findall 中使用括号仅仅是为了应用量词(例如 r"(?:http|https)://\w+"),务必使用 (?:...) 非捕获组语法,否则 findall 会自动过滤掉其它内容,只返回协议前缀。
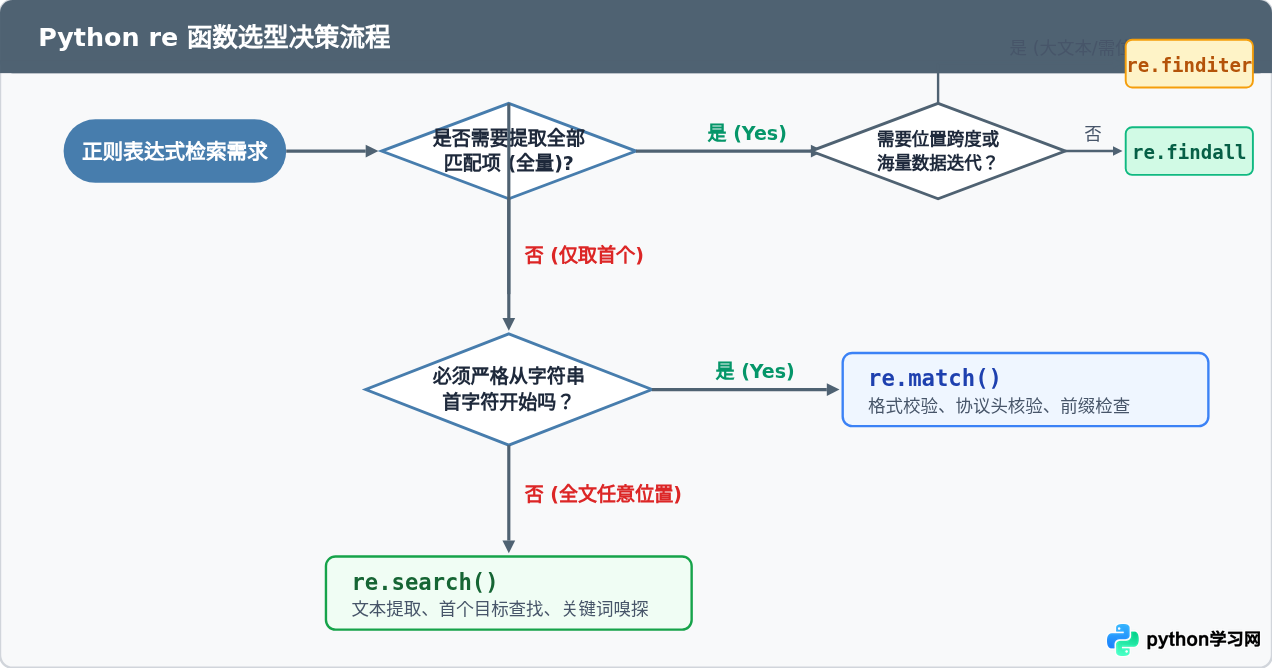
五、方法选型指南与决策流程
在面对具体的业务场景时,应当按照检索范围、返回量级以及是否需要位置跨度进行判断:
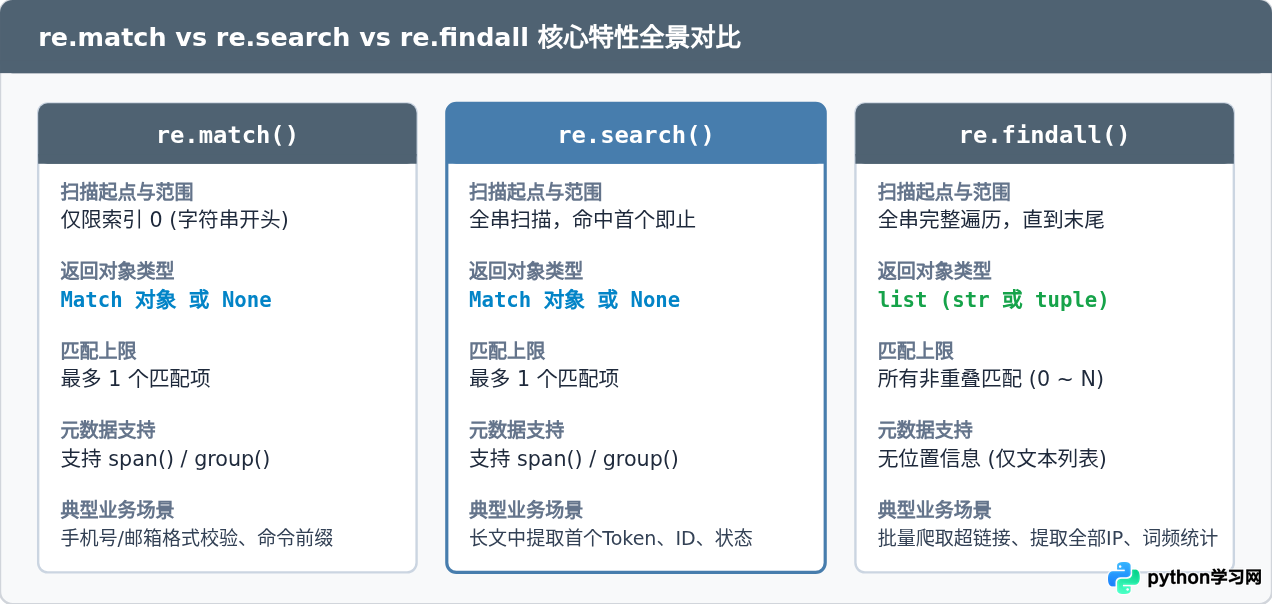
总结对照表
| 对比维度 | re.match | re.search | re.findall |
|---|---|---|---|
| 匹配起点 | 仅从字符串 index 0 开始 | 扫描整个字符串 | 扫描整个字符串 |
| 匹配数量 | 最多 1 个 | 最多 1 个(首个命中项) | 所有非重叠匹配(0 到多个) |
| 返回类型 | re.Match 或 None |
re.Match 或 None |
list[str] 或 list[tuple] |
| 未命中时表现 | 返回 None |
返回 None |
返回空列表 [] |
| 能否获取匹配位置 | 能 (通过 .span()) |
能 (通过 .span()) |
否 (仅保留文本内容) |
六、工程实践中的注意事项与常见错误
1. 空值防范最佳实践
处理 match 和 search 时,使用海象运算符可以写出既简洁又安全的代码:
# 推荐:安全提取
raw_log = "2026-10-26 [ERROR] database connection timeout"

if m := re.search(r"\[([A-Z]+)\]\s+(.*)", raw_log):
    level, message = m.groups()
    print(f"日志等级: {level}, 描述: {message}")
else:
    print("未符合日志格式")
2. 性能优化:预编译模式
当需要在循环中处理成千上万条记录时,直接调用 re.match(...) 会重复解析和编译正则字符串。改用 re.compile() 能显著减少开销:
import re

# 提前编译为 Pattern 对象
pattern = re.compile(r"^#([0-9a-fA-F]{3}|[0-9a-fA-F]{6})$")

hex_colors = ["#FFF", "#1E293B", "red", "#G12"]
valid_colors = [c for c in hex_colors if pattern.match(c)]
print("有效十六进制颜色:", valid_colors)
# 输出: ['#FFF', '#1E293B']
3. 大文本时的内存考量:findall vs finditer
re.findall 会一次性把所有结果加载到内存列表中。当处理数百兆的服务器日志文件时,这种做法极易导致内存峰值过高。此时应当使用 re.finditer:
# finditer 返回迭代器,按需产出 Match 对象
log_data = "ip: 192.168.1.1 ... ip: 10.0.0.1 ..."
for match in re.finditer(r"\b(?:\d{1,3}\.){3}\d{1,3}\b", log_data):
print(f"发现 IP: {match.group()} 位于位置 {match.span()}")本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















