


Python并发请求多个接口并聚合结果的最佳实践
深入讲解Python在并发请求多个外部接口并聚合响应数据时的最佳实践,涵盖asyncio+httpx异步方案、concurrent.futures多线程方案、超时控制、异常容错及并发限流策略。
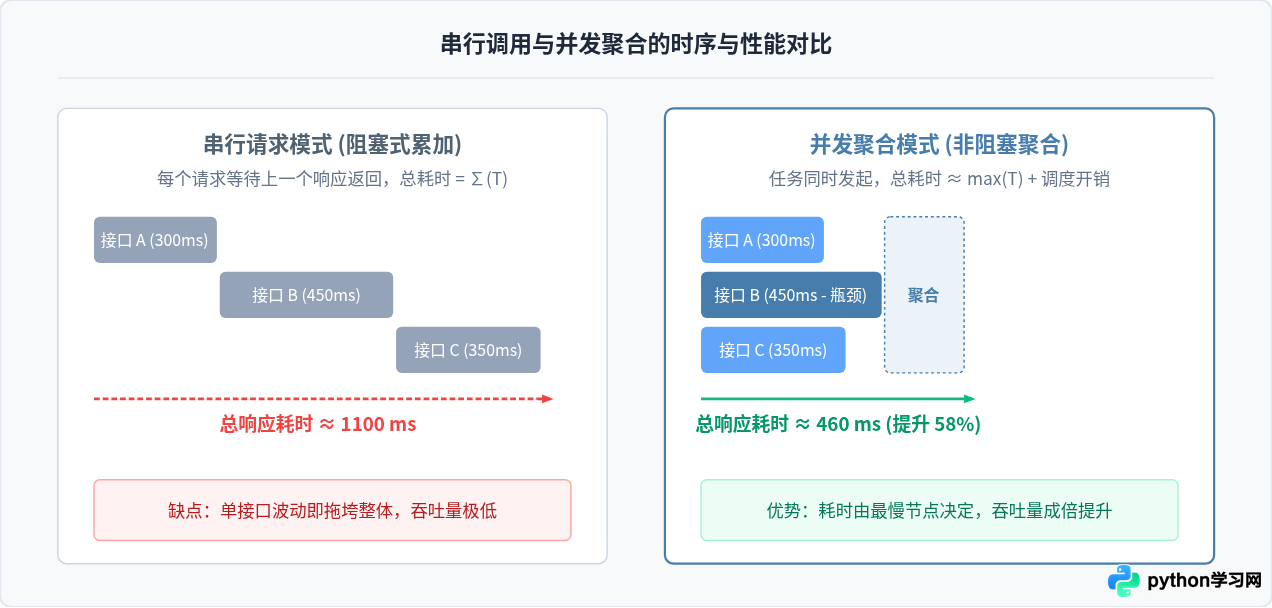
在微服务架构、数据大屏、开放平台集成或聚合网关的开发中,后端服务往往需要同时调用三到十几个第三方接口,并将返回的数据组装成一个完整的业务对象交付给前端。如果采用传统的单线程串行循环调用,总耗时将是所有接口响应时间的直接累加;只要其中一个接口网络抖动,整个上层接口就会超时或失去响应。实现高效并发请求与可靠结果聚合,是保障服务低延迟与高可用性的关键环节。
一、核心选型:理解两种并发模型
网络请求属于典型的 I/O 密集型任务,CPU 大部分时间都在等待网络数据包返回。Python 解决网络 I/O 阻塞有两种成熟的技术路径:基于事件循环的 asyncio 异步非阻塞模型,以及基于多线程的 ThreadPoolExecutor 线程池模型。
- asyncio + httpx / aiohttp(推荐方案):在单线程内通过事件循环调度协程,遇到网络 I/O 自动让渡执行权。系统资源开销极小,即便并发发起几十甚至上百个请求,也不会造成线程上下文切换损耗,是现代 Python(3.8+)Web 服务的首选模式。
- concurrent.futures.ThreadPoolExecutor + requests(兼容方案):利用操作系统级线程分发阻塞调用。适合基于传统同步框架(如 Django 早期视图、Flask 同步端点)或依赖封闭同步 SDK 的老旧项目,改造成本低,但线程数过多会增加内存和调度开销。
二、主流实践:asyncio + httpx 优雅聚合
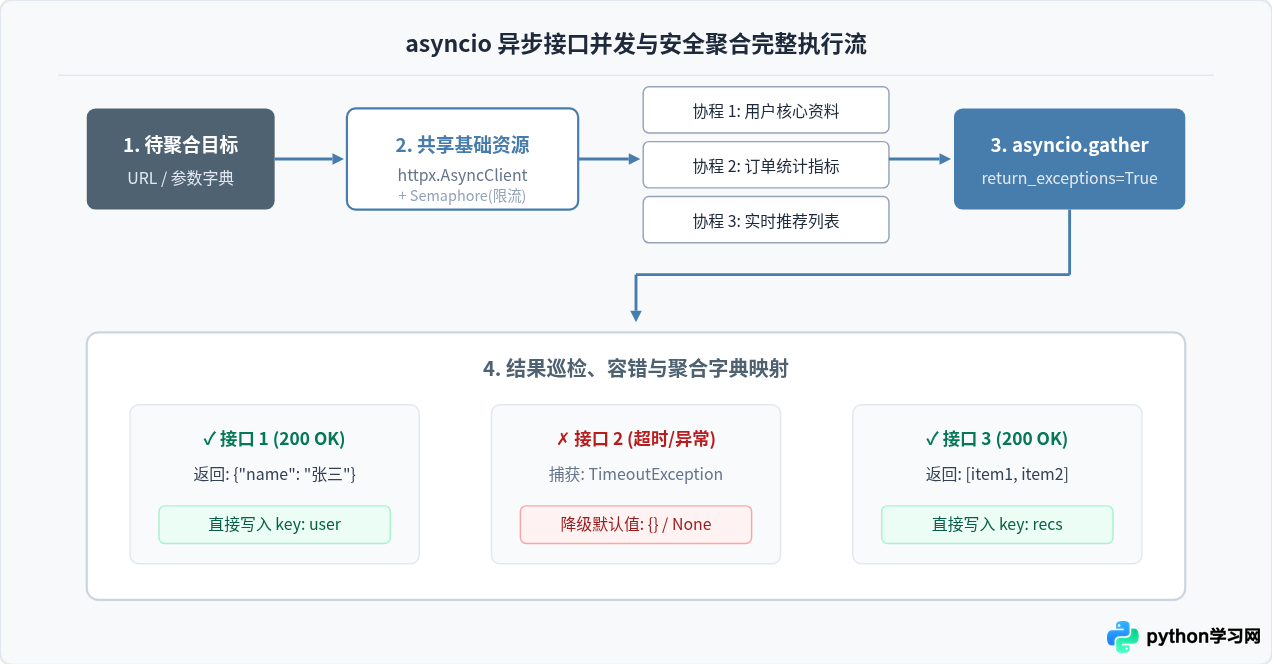
在异步生态中,httpx 相比老牌的 requests 提供了完整的异步客户端支持(httpx.AsyncClient),同时原生支持连接池复用、HTTP/2 以及超时精细化控制。结合 Python 标准库的 asyncio.gather,可以优雅实现多任务并发分发与统一聚合。
1. 核心 API:为什么必须设置 return_exceptions=True?
默认情况下,asyncio.gather(*tasks) 只要其中某一个协程抛出异常(例如某个接口报 500、连接超时或 DNS 解析失败),整个 gather 就会立即将该异常向外抛出,导致已经完成或正在执行的其他接口结果丢失。这在聚合场景中是不可接受的。
通过传入 return_exceptions=True,asyncio.gather 会在所有任务执行完毕后,将正常返回值和捕获到的 Exception 实例按照输入顺序一并放入结果列表。随后,开发者可以在内存中针对每个字段进行判定:正常数据直接取用,异常数据则做降级处理或记录监控告警。
2. 生产级完整代码:带超时、限流与安全聚合
以下示例演示了如何通过 httpx.AsyncClient 同时请求三个不同职责的接口,利用 asyncio.Semaphore 限制突发并发,并使用结构化的字典键进行业务聚合:
import asyncio
import logging
from typing import Any, Dict, List, Tuple
import httpx

logging.basicConfig(level=logging.INFO, format="%(asctime)s [%(levelname)s] %(message)s")
logger = logging.getLogger(__name__)

# 限制并发信号量,防止瞬时打满下游或自身连接池
SEMAPHORE = asyncio.Semaphore(10)

async def fetch_single_api(
    client: httpx.AsyncClient,
    key: str,
    url: str,
    timeout_seconds: float = 3.0
) -> Tuple[str, Any]:
    """带限流与单独超时的单接口请求函数"""
    async with SEMAPHORE:
        try:
            # 设置单接口独立超时时间(连接1秒,读取3秒)
            timeout = httpx.Timeout(timeout_seconds, connect=1.0)
            response = await client.get(url, timeout=timeout)
            response.raise_for_status()
            return key, response.json()
        except httpx.HTTPStatusError as exc:
            logger.warning(f"接口 [{key}] 返回异常HTTP状态码: {exc.response.status_code}")
            raise
        except httpx.TimeoutException:
            logger.warning(f"接口 [{key}] 请求超时 ({timeout_seconds}s)")
            raise
        except Exception as exc:
            logger.error(f"接口 [{key}] 发生未预期的网络或解析错误: {exc}")
            raise

async def aggregate_api_data(api_targets: Dict[str, str]) -> Dict[str, Any]:
    """并发请求核心聚合函数"""
    limits = httpx.Limits(max_keepalive_connections=20, max_connections=50)

    # 共享 AsyncClient,复用底层的 TCP 连接池与 SSL 上下文
    async with httpx.AsyncClient(limits=limits, headers={"User-Agent": "AggregationGateway/1.0"}) as client:
        tasks = [
            fetch_single_api(client, key, url)
            for key, url in api_targets.items()
        ]

        # 并发等待全部返回,return_exceptions=True 确保单个异常不中断整体
        raw_results = await asyncio.gather(*tasks, return_exceptions=True)

        aggregated: Dict[str, Any] = {}
        for item in raw_results:
            if isinstance(item, Exception):
                # 遇到异常项,根据业务规则做缺省降级,保证上层不报500
                logger.info("存在失败接口,执行字段缺省降级")
                continue
            key, data = item
            aggregated[key] = data

        return aggregated

# 调用示例
if __name__ == "__main__":
    targets = {
        "userInfo": "https://api.example.com/v1/user/1001",
        "orderStats": "https://api.example.com/v1/orders/summary?uid=1001",
        "recommendations": "https://api.example.com/v1/recommend/items?uid=1001"
    }
    result = asyncio.run(aggregate_api_data(targets))
    print("聚合结果字典键:", list(result.keys()))
三、健壮性设计:超时、熔断与降级策略
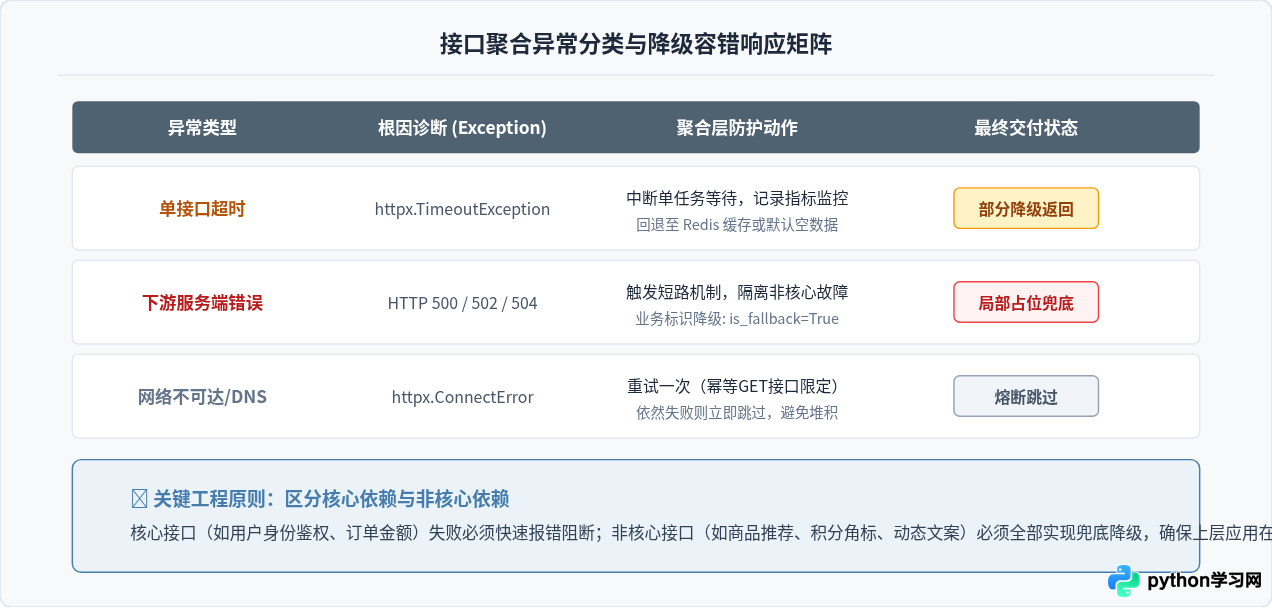
编写并发请求代码时,最容易出现的失误就是“只写快乐路径(Happy Path)”。生产环境下,第三方系统的可用性必须被预设为不可靠。良好的接口聚合器必须具备完善的异常容错与降级矩阵。
1. 全局硬超时:使用 asyncio.wait_for 设立兜底线
虽然每个单个接口都设置了超时(例如 3 秒),但如果网络处于极慢速读取状态,或者协程调度出现意外延迟,整个 gather 可能会被卡住较长时间。最佳实践是在聚合函数外部套一层全局硬超时:
try:
    # 全局硬超时控制在 4.5 秒以内,超过立即熔断返回
    final_data = await asyncio.wait_for(aggregate_api_data(targets), timeout=4.5)
except asyncio.TimeoutError:
    logger.error("整个聚合流程超出全局硬时间预算 (4.5s),返回基础默认兜底数据")
    final_data = get_emergency_fallback_data()
2. 连接池管理:避免频繁新建客户端
在循环或每次外部请求到来时调用 httpx.get(...) 或 requests.get(...) 是最常见的性能杀手。每次直接调用顶级函数都会重新创建 TCP 套接字并进行完整的 TLS 握手。高并发场景下,这不仅会导致大量 TIME_WAIT 连接堆积、耗尽系统文件描述符,还会使每次请求增加几十毫秒的握手延迟。必须在应用生命周期内保持长连接池(Client 或 Session),并在并发任务间复用。
四、备选实践:ThreadPoolExecutor 多线程方案
如果现有项目运行在传统的同步框架中(例如普通的 Flask 或 Celery Worker),或者调用的三方库仅提供同步阻塞 SDK,使用 concurrent.futures.ThreadPoolExecutor 搭配 requests.Session 是最稳妥的并发改造手段。
from concurrent.futures import ThreadPoolExecutor, as_completed
import requests
from typing import Dict, Any

def sync_fetch_single(session: requests.Session, key: str, url: str) -> tuple:
    try:
        # 同步请求同样必须设置超时
        resp = session.get(url, timeout=(1.5, 3.0))
        resp.raise_for_status()
        return key, resp.json(), None
    except Exception as exc:
        return key, None, exc

def aggregate_with_threads(api_targets: Dict[str, str], max_workers: int = 8) -> Dict[str, Any]:
    aggregated = {}
    # 复用 Session 连接池
    with requests.Session() as session:
        adapter = requests.adapters.HTTPAdapter(pool_connections=10, pool_maxsize=20)
        session.mount("https://", adapter)
        session.mount("http://", adapter)

        with ThreadPoolExecutor(max_workers=max_workers) as executor:
            future_to_key = {
                executor.submit(sync_fetch_single, session, key, url): key
                for key, url in api_targets.items()
            }

            # as_completed 谁先返回处理谁,减少等待
            for future in as_completed(future_to_key):
                key, data, err = future.result()
                if err is None:
                    aggregated[key] = data
                else:
                    aggregated[key] = {} # 降级默认值

return aggregated在同步多线程模型中,线程的创建和上下文切换是有内存代价的(通常每个线程消耗约几兆堆栈空间)。线程池大小 max_workers 应设置为接口数量的合理倍数(通常为 5-16),切忌为了提高并发盲目配置几百个线程,否则 GIL 争用与调度抖动会抵消并发收益。
五、方案选型与落地决策
为了帮助技术团队在具体项目中做出准确选型,下表从底层机制、并发上限、改造成本及生态集成四个维度对各方案进行总结梳理:
六、总结与落地清单
在 Python 中并发请求多个接口并聚合结果,本质上是在网络 I/O 耗时与系统健壮性之间取得平衡。实现高并发只是第一步,建立完备的超时控制、异常隔离与非核心依赖降级机制,才是保障聚合服务稳定运行的核心关键。
日常开发可对照以下清单进行代码审查:
- 是否复用了 Client 或 Session? 检查是否在每次调用或循环内部实例化
httpx.AsyncClient或requests.Session。 - 是否启用了异常捕获隔离?
asyncio.gather是否配置了return_exceptions=True,多线程是否对future.result()做了异常拦截。 - 是否设置了显式超时? 杜绝任何没有设置
timeout的网络调用,并配置全局整体时间预算。 - 是否配置了并发限流? 并发数是否通过
Semaphore或合理的线程池大小进行了上限约束,避免打垮内部系统或下游微服务。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















