


Java和Python的行业分布:金融后端与AI大数据的就业优势解析
深入解析Java在金融后端与Python在AI大数据领域的行业分布现状、技术生态壁垒、岗位能力要求及职业发展路径,为技术选型与求职规划提供实用参考。
在当前的软件工程与数字化人才市场中,Java与Python分别代表了两种截然不同但壁垒极高的技术演进路线。Java凭借强静态类型约束、成熟的JVM内存管理以及完善的分布式微服务生态,牢固占据着以银行、证券、保险和第三方支付为代表的金融后端核心业务;Python则依托极低的学习摩擦成本、简洁的表现力以及由C/C++底层支撑的强大张量计算与科学计算库,垄断了人工智能算法研发、机器学习模型训练与现代大数据分析流水线。理解这两者的行业分工本质、底层技术壁垒与岗位考核要求,是技术人员进行技术选型和职业路径规划的前提。
一、金融核心系统与后端架构:Java的工程化壁垒
金融行业对信息系统的首要要求永远是“资金安全、交易可审计、服务高可用与系统强一致”。任何一笔转账、计息或撮合交易的微小偏差,都会造成严重的财务与合规风险。Java之所以长期成为金融机构后端核心系统的基石,源于其在工程化层面的三个关键特性:
- 严谨的强类型系统与多线程并发模型:Java在编译期即可拦截大部分潜在类型错误,配合
java.util.concurrent(JUC)高并发包,为处理数十万TPS的高频资金扣减提供了可靠的多线程同步与原子控制基石。 - 久经检验的JVM调优与垃圾收集生态:从早期的CMS、G1到现代低延迟垃圾收集器ZGC,JVM具备极其透明的运行时监控机制(如JMX、Arthas诊断),能够在几百G大内存堆下把系统STW(Stop The World)停顿控制在毫秒以内,满足高频结算的时延要求。
- 成熟的企业级分布式事务与中台生态:Spring Boot、Spring Cloud、Dubbo、Seata等框架构筑了业界最完善的工业级中台规范。针对跨银行结算场景,TCC(Try-Confirm-Cancel)与Saga模式的分布式事务实现极为健全。
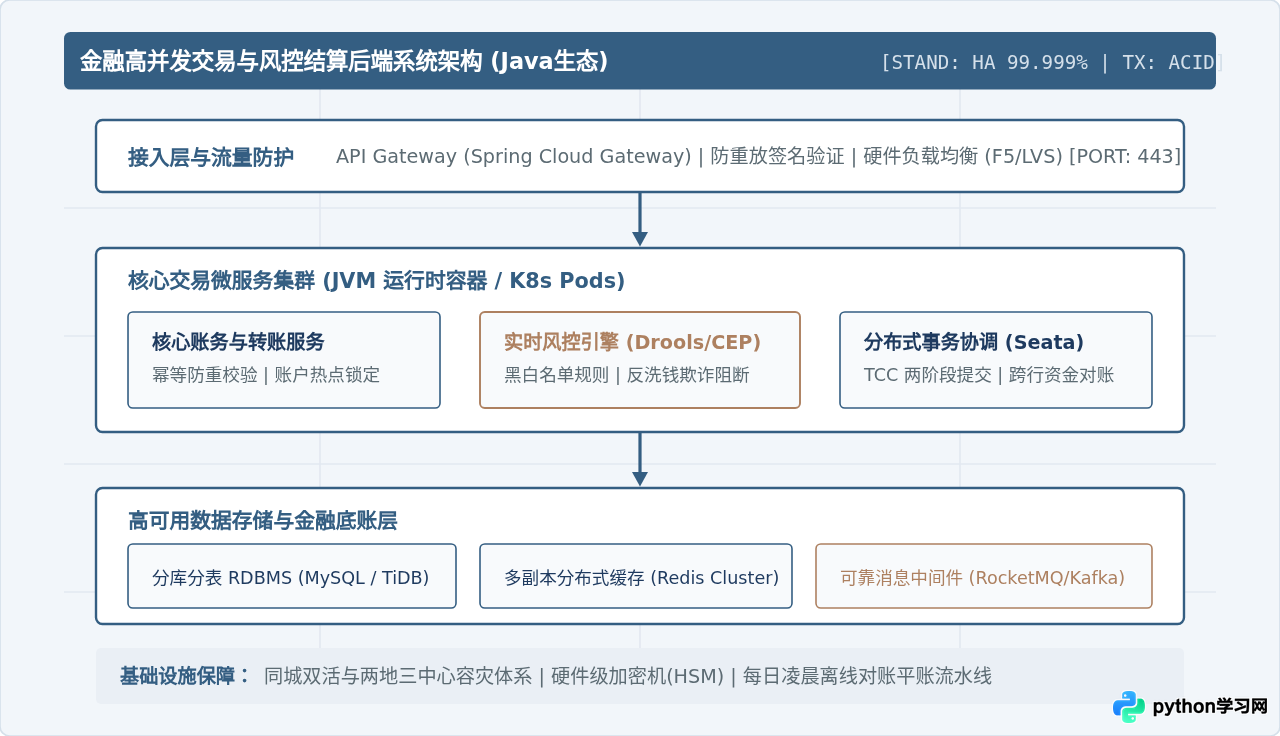
在实际金融交易中,代码必须严谨处理并发死锁与重试幂等。以下是金融后端处理核心转账扣款时的典型设计逻辑:通过“分布式防重Token + 数据库乐观锁/悲观行级排他锁 + 本地事务原子提交”确保资金绝对安全:
// 金融资金扣减核心逻辑典型实现(示意)
@Transactional(rollbackFor = Exception.class, isolation = Isolation.READ_COMMITTED)
public TransferResult executeTransfer(TransferRequest request) {
    // 1. 幂等校验:防止前端重复提交或网络重试导致多次扣款
    boolean acquired = redisTemplate.opsForValue()
        .setIfAbsent("lock:tx:" + request.getTransactionId(), "1", Duration.ofMinutes(10));
    if (!acquired) {
        throw new DuplicateTransactionException("重复的交易流水号: " + request.getTransactionId());
    }

    // 2. 查询账户并锁定(FOR UPDATE排他行锁控制并发资金状态变更)
    Account fromAccount = accountMapper.selectByAccountIdForUpdate(request.getFromAccountId());
    if (fromAccount.getAvailableBalance().compareTo(request.getAmount()) < 0) {
        throw new InsufficientBalanceException("账户可用余额不足");
    }

    // 3. 执行资金双向划转与账务变动流水记录
    accountMapper.decreaseBalance(request.getFromAccountId(), request.getAmount());
    accountMapper.increaseBalance(request.getToAccountId(), request.getAmount());

    TransactionLog log = new TransactionLog(request.getTransactionId(), request.getAmount(), "SUCCESS");
    transactionLogMapper.insert(log);

    return TransferResult.success(request.getTransactionId());
}
二、AI与大数据平台:Python的技术垄断与工程协同
与金融后台追求严苛编译期约束不同,人工智能和大数据研发的核心诉求是“快速实验、矩阵数学运算、极速验证算法假设”。Python凭借其动态脚本语言特性,配合底层以C/C++与Fortran编写的高性能线性代数库,建立了不可撼动的算法生态垄断:
- 底层C/CUDA加速与胶水特性:Python代码本身执行效率并不高,但PyTorch、TensorFlow、NumPy将耗费算力的矩阵乘法、张量反向传播完全卸载到了底层的C++运行时与NVIDIA CUDA内核中。Python只作为顶层的控制胶水,兼具开发效率与计算性能。
- 模型即代码的开源社区事实标准:从HuggingFace Transformers、LangChain到vLLM、DeepSpeed,全球主流AI实验室发布模型权重和微调代码时,默认100%提供Python原生支持。脱离Python生态,算法工程师将无法直接复用顶尖的前沿成果。
- 与Java大数据基础设施的生产级分工:在工业级大数据平台中,Java主要负责“吞吐与调度”,Python负责“算法与分析”。例如,数据采集与存储由Java生态的Kafka、Hadoop、Flink承担;而清洗后的数据特征抽取、离线模型微调与在线推理决策则交由Python脚本驱动。
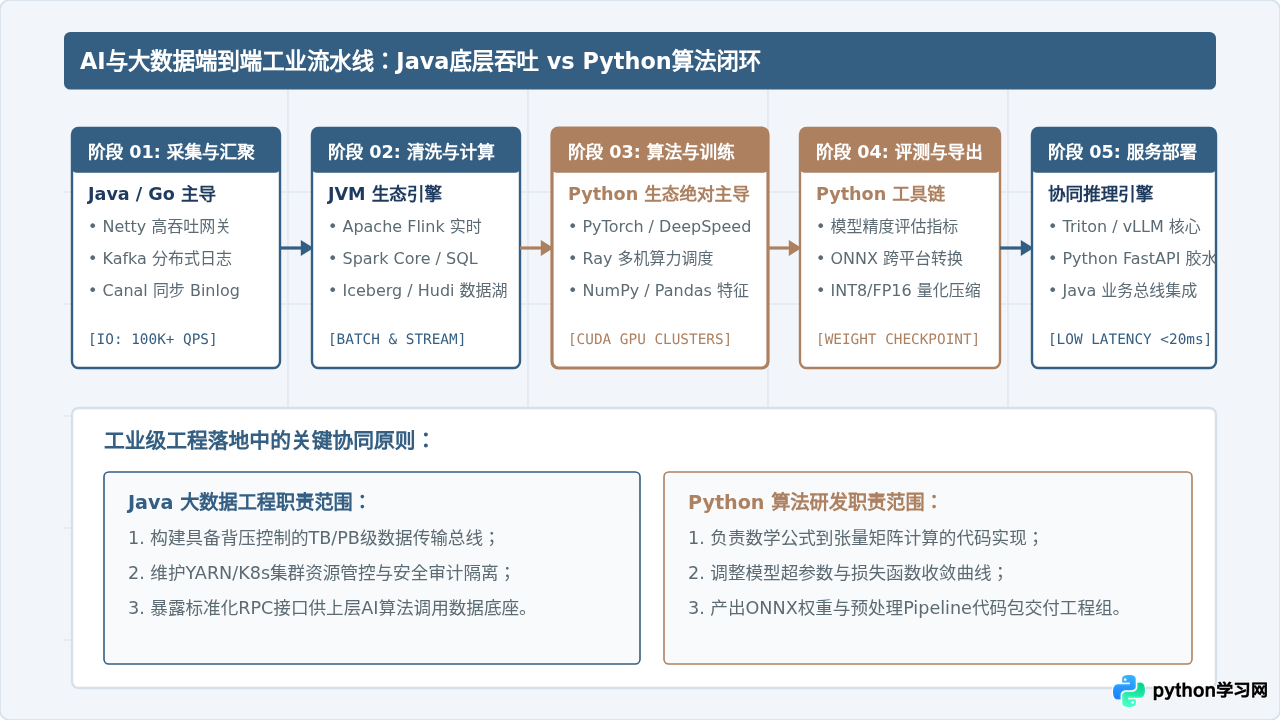
在Python算法开发中,核心在于数学概念与向量化计算的高效结合。例如在风险评分或数据预测任务中,利用PyTorch进行模型训练的经典流程如下:
# AI算法模型训练与权重保存典型结构(示意)
import torch
import torch.nn as nn
from torch.utils.data import DataLoader

class FinancialRiskClassifier(nn.Module):
    def __init__(self, input_dim: int, hidden_dim: int = 128):
        super().__init__()
        self.net = nn.Sequential(
            nn.Linear(input_dim, hidden_dim),
            nn.BatchNorm1d(hidden_dim),
            nn.ReLU(),
            nn.Dropout(0.2),
            nn.Linear(hidden_dim, 2)  # 二分类:正常 / 欺诈风险
        )

    def forward(self, x: torch.Tensor) -> torch.Tensor:
        return self.net(x)

def train_pipeline(model, dataloader: DataLoader, optimizer, criterion, device):
    model.train()
    for batch_features, batch_labels in dataloader:
        batch_features = batch_features.to(device)
        batch_labels = batch_labels.to(device)

        optimizer.zero_grad()
        outputs = model(batch_features)
        loss = criterion(outputs, batch_labels)
        loss.backward()  # C++底层反向传播梯度计算
        optimizer.step()
三、岗位技能树与能力评估标准对比
求职市场的面试考察维度直接映射了企业的生产痛点。金融机构招聘Java工程师,本质上是在寻找“能够驾驭极端并发、保障资金永不丢单的架构工匠”;而科技大厂与科研团队招聘Python AI/大数据工程师,则聚焦于“数理统计素养、前沿模型架构理解与大规模算力优化能力”。
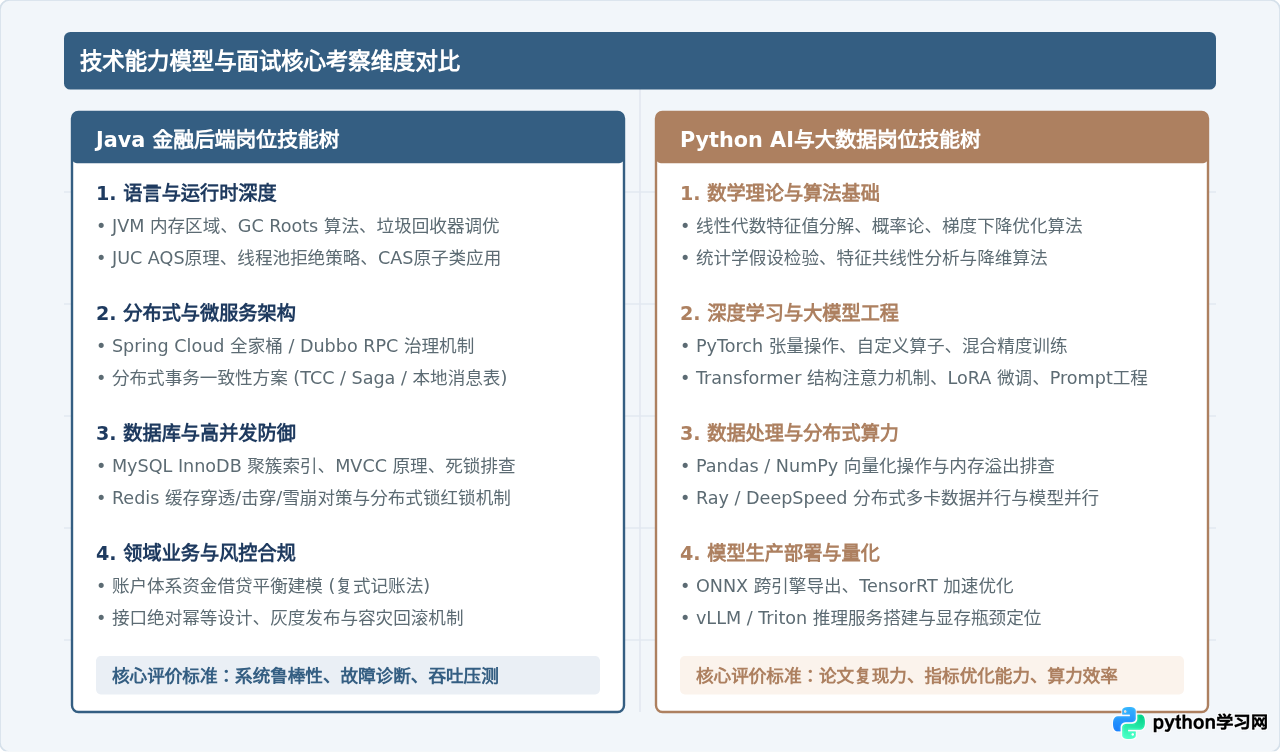
| 对比维度 | Java 金融后端岗位 | Python AI与大数据岗位 |
|---|---|---|
| 典型用人单位 | 国有大行/股份制银行软件中心、头部券商、公募基金、头部消费金融与支付机构 | 大模型创业公司、互联网科技巨头AI实验室、量化私募、智能驾驶与工业视觉企业 |
| 学历与专业偏好 | 计算机、软件工程等工科背景;重视扎实的代码习惯与工程实现能力 | 计算机、应用数学、统计学、模式识别等硕士及以上学历居多,重视论文与数理推导 |
| 职业生命周期 | 随业务深度与架构经验积累增值,35岁后多向金融业务架构师、系统安全专家转型 | 随前沿算法更新迭代极快,需要持续跟进顶级会议成果,向算法科学家或MLOps专家演进 |
| 生产环境痛点 | 分布式事务锁冲突、内存泄漏排查、双活网络分区脑裂、冷热数据分库分表迁移 | 显存爆仓(OOM)、分布式梯度同步通信瓶颈、数据标注噪声过大、模型泛化能力不足 |
四、职业路径选择与求职准备指南
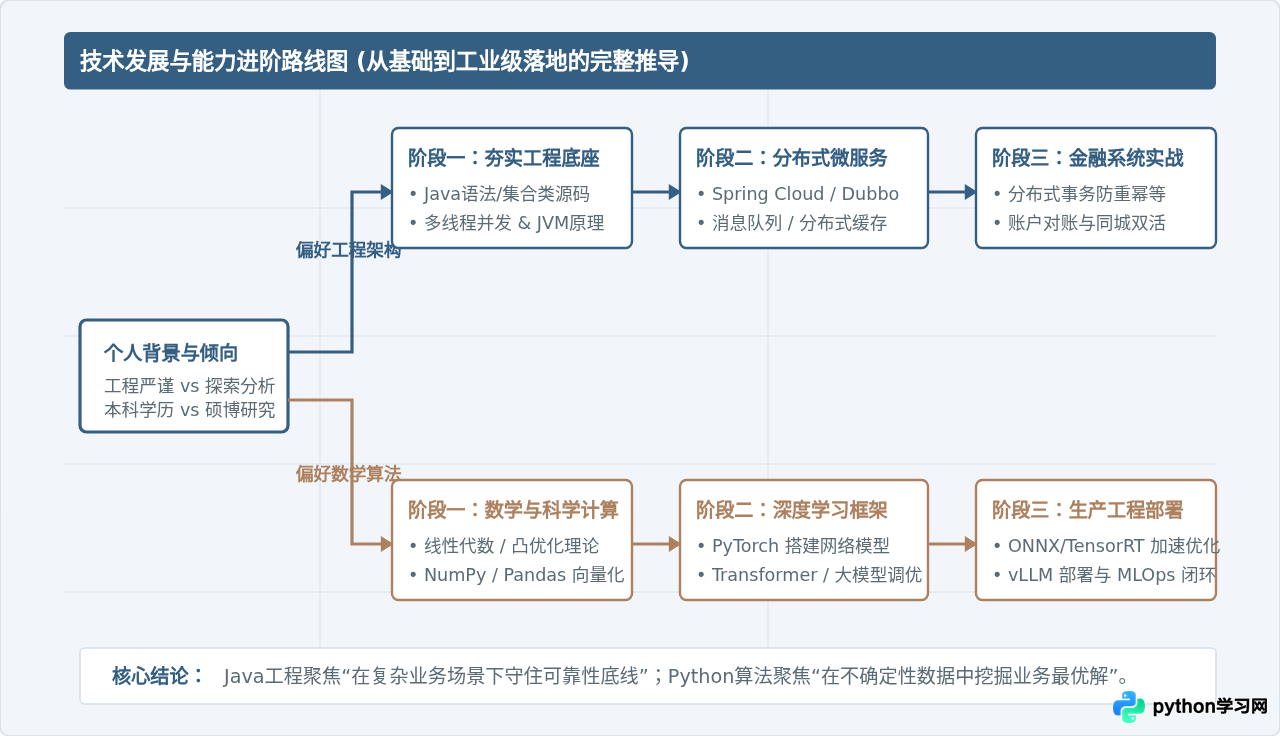
面对两大方向的选择,求职者不应盲目追逐所谓“风口”,而应根据自身的数理基础、工程直觉以及长远职业规划进行系统性评估。以下是基于实际工程就业环境推导出的四步决策指南:
- 第一步:数理逻辑偏好 vs 系统工程直觉评估。如果你对矩阵分析、梯度推导、统计学假设检验充满兴趣,且具备较强的科研探索精神,Python AI方向能给你极大的正向反馈;如果你更享受设计高吞吐系统、重构业务架构、排查分布式并发Bug并保障系统平稳运转,Java后端具备更强的掌控感与工程确定性。
- 第二步:规避技能浅层化陷阱。Java求职者必须避免“只会写Controller/Service增删改查”的浅层状态,必须深入Netty网络IO、JVM内幕、分布式CAP理论;Python求职者必须摆脱“只会调用现成库调参(调包侠)”的阶段,必须能手写核心层反向传播、熟练掌握向量化加速并具备CUDA/C++底层交互意识。
- 第三步:对标工业界标准打磨作品集。Java方向应当有一套涵盖完整微服务架构、防重扣款、分布式事务的实际高可用项目;Python方向则应当有真实数据集清洗、复现顶会Baseline、量化压缩并在本地以ONNX/TensorRT成功落地的完整Repo。
五、总结:行业价值与未来融合趋势
Java在金融后端的绝对优势,源于几十年金融业务沉淀出的极端鲁棒性、严苛的安全规范与完备的工程基础设施;Python在AI与大数据的垄断地位,源于全球学术界与工业界统一构筑的张量计算生态与高效的模型探索飞轮。两门语言并非非此即彼的对立关系,而在现代企业级系统架构中形成了深度的共生互补:底层与业务总线由Java稳固护航,智能大脑与数据挖掘由Python高效驱动。对于开发者而言,理解两者的分工边界,在专精一门核心主栈的同时具备跨领域的工程认知,是在当下复杂多变的就业市场中建立长期竞争优势的最佳策略。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















