


解决Python浅拷贝陷阱:修改嵌套列表导致原数据变化的方案
深入解析Python中修改嵌套列表导致原数据变化的浅拷贝陷阱原理,并提供基于copy.deepcopy、列表推导式、JSON序列化等切实可行的解决方案与最佳实践。
在Python开发过程中,处理嵌套数据时经常会遇到一个典型问题:使用切片语法 list[:] 或 list.copy() 复制了一个包含子列表的列表后,修改新列表里的子元素,原本以为相互独立的原列表数据竟然也被同步修改了。本文将直接解析产生这一现象的底层内存引用原理,并给出从标准库深拷贝到浅层推导的多套切实可行的解决方案及选型建议。
一、复现问题:嵌套列表修改引发的联锁反应
我们先来看一个最常见的场景。假设我们有一个表示矩阵或分组数据的嵌套列表,出于数据保护的目的,我们在修改前进行了列表拷贝:
# 原始数据
original = [[1, 2, 3], [4, 5, 6]]

# 尝试通过切片或 copy() 进行浅拷贝
copied = original.copy()

# 修改新列表的外层元素(例如增加一个新行)
copied.append([7, 8, 9])
print("增加外层元素后:")
print("original:", original)  # [[1, 2, 3], [4, 5, 6]]
print("copied:  ", copied)    # [[1, 2, 3], [4, 5, 6], [7, 8, 9]]
# 此时原列表没有受影响,符合预期

# 但是,若修改嵌套子列表内的元素:
copied[0][0] = 999
print("\n修改嵌套元素后:")
print("original:", original)  # [[999, 2, 3], [4, 5, 6]]  <-- 原数据被篡改!
print("copied:  ", copied)    # [[999, 2, 3], [4, 5, 6]]
可以看到,对 copied 外层进行 append 时,原列表不受干扰;但在修改 copied[0][0] 时,原列表 original[0][0] 却同步变成了 999。这种“看似复制成功,深层仍旧共享”的现象就是浅拷贝陷阱。
二、底层原理解析:内存中发生了什么
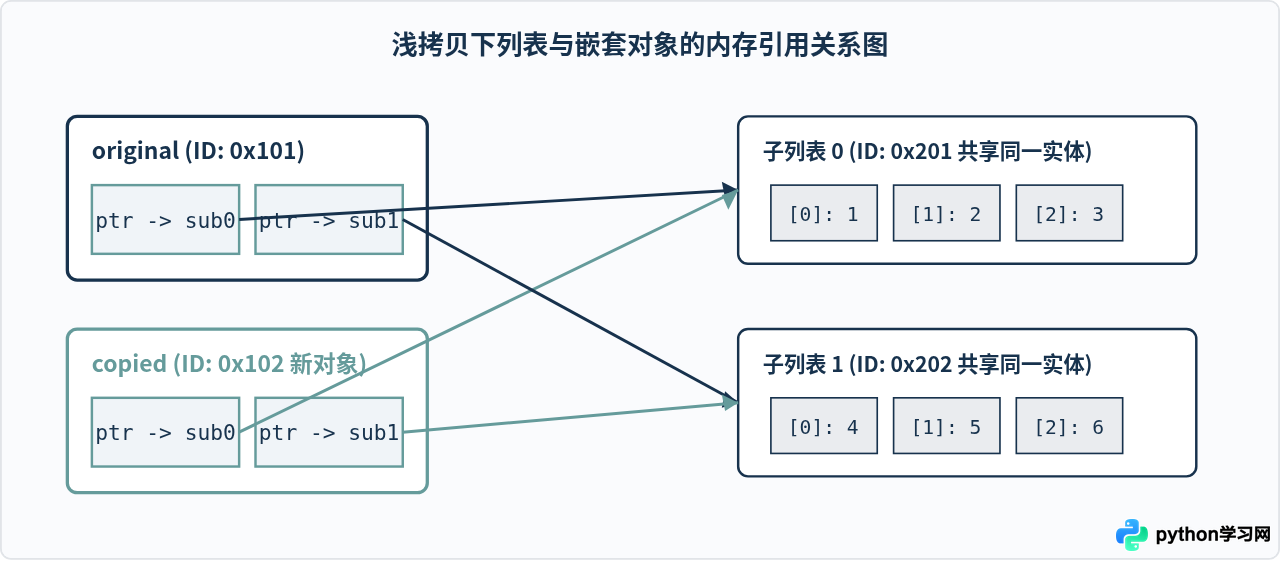
Python中的列表本质上是一个存储对象内存引用(地址指针)的连续容器。无论使用 list.copy()、list[:] 还是 list() 工厂函数,执行的都是浅拷贝(Shallow Copy)。
浅拷贝只会创建一个全新的外层列表对象,并将原列表内所有元素的指针复制到新列表中。对于基础不可变对象(如整数、字符串),修改等同于重定向指针,不会产生副作用;但对于嵌套的子列表,新列表与原列表复制的是同一个子列表的内存地址。因此,无论是通过原列表还是新列表访问该子列表,所操作的都是内存中的同一块区域。
三、排查与解决流程
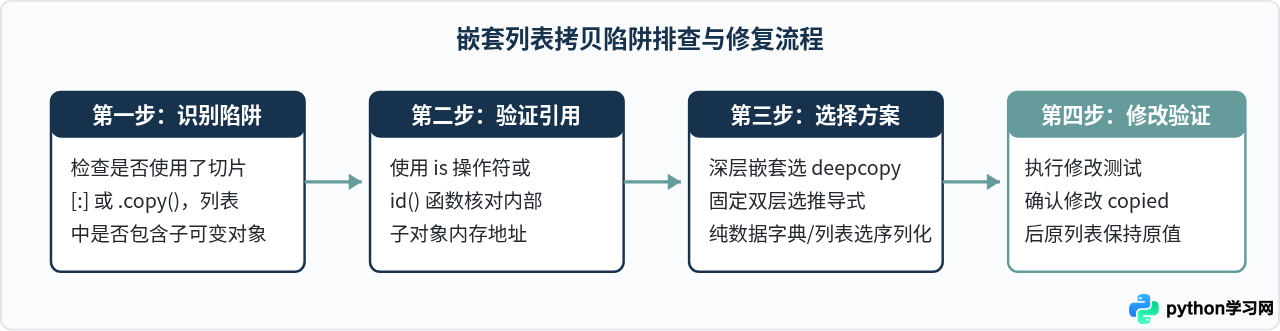
当发现数据被异常联动篡改时,排查与解决可以遵循以下标准步骤展开:
四、解决方案与代码实操
方案一:标准库 copy.deepcopy()(通用推荐)
针对嵌套结构,Python标准库提供了内置的 copy.deepcopy()。它会递归遍历原始对象的所有层级,在内存中重新构建所有嵌套对象,从而实现完全隔离。
import copy

# 原始嵌套列表
original = [[1, 2, 3], [4, 5, 6]]

# 使用 deepcopy 进行深拷贝
safe_copied = copy.deepcopy(original)

# 修改深拷贝列表中的嵌套元素
safe_copied[0][0] = 999

# 验证结果
print("original:", original)     # 保持原样: [[1, 2, 3], [4, 5, 6]]
print("safe_copied:", safe_copied) # 成功修改: [[999, 2, 3], [4, 5, 6]]

# 检查内存地址是否已经独立
print("子列表0是否相同对象:", original[0] is safe_copied[0]) # 输出: Falsedeepcopy 会自动维护一个已访问对象的字典(备忘录),因此即便是包含了循环引用的复杂对象(例如列表中引用了自己),它也能正确识别并避免无限递归陷入死循环。对于结构复杂、层数不确定的数据结构,deepcopy 是最安全稳妥的方案。
方案二:双层列表推导式(轻量高效方案)
如果数据结构仅固定为两层嵌套列表(例如常见的二维矩阵、表格数据),使用 copy.deepcopy() 会因为类型检查和递归元数据维护带来一定的性能开销。此时,直接利用列表推导式配合浅拷贝即可达到目的:
original = [[1, 2, 3], [4, 5, 6]]

# 外层推导,内层分别执行浅拷贝
fast_copied = [sublist.copy() for sublist in original]

# 修改测试
fast_copied[0][0] = 999
print("original:", original)     # [[1, 2, 3], [4, 5, 6]]
print("fast_copied:", fast_copied) # [[999, 2, 3], [4, 5, 6]]
推导式不仅代码表达直接,而且纯粹在C层面快速遍历完成,对于大数据量二维矩阵(如 100,000 行),其速度通常比 deepcopy 快数倍。
方案三:JSON 序列化与反序列化(适用于纯数据结构)
如果列表中存放的全部都是基础数据类型(字典、列表、数字、字符串、布尔值),可以通过 json.dumps() 转换成字符串再通过 json.loads() 解析,从而快速实现深拷贝:
import json

original = [[1, 2, 3], [4, 5, 6]]

# 序列化为JSON再反序列化
json_copied = json.loads(json.dumps(original))

json_copied[0][0] = 999
print("original:", original)     # [[1, 2, 3], [4, 5, 6]]
print("json_copied:", json_copied) # [[999, 2, 3], [4, 5, 6]]
注意边界限制: JSON方案无法处理包含自定义类实例、元组(会被转为列表)、集合(Set)以及含循环引用的对象,在这些情况下会抛出 TypeError。
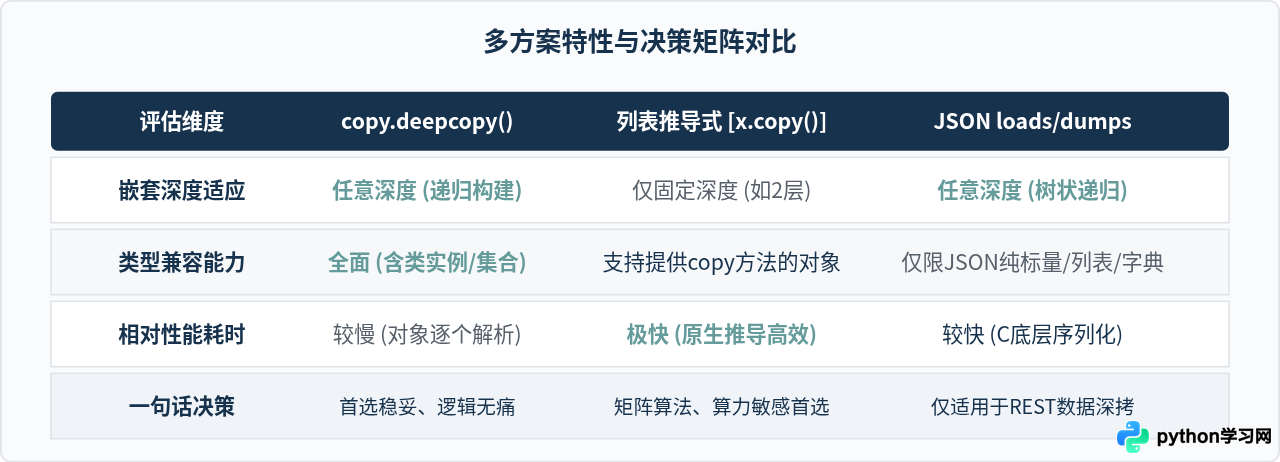
五、方案选型与特性对比
不同方案在执行速度、灵活性及依赖边界上各不相同,选型时可参考下表:
| 解决方案 | 适用层级 | 性能表现 | 循环引用支持 | 推荐使用场景 |
|---|---|---|---|---|
| copy.deepcopy() | 任意深度嵌套 | 中等(含递归检查) | 支持(内置备忘录) | 通用场景、多层嵌套、含对象实例的数据 |
| 列表推导式 + copy() | 固定两层结构 | 极快(低开销) | 不支持 | 确定深度的二维矩阵、批量数据处理 |
| JSON 序列化 | 任意深度(限JSON兼容类型) | 快(基于C库加速) | 不支持(直接报错) | 纯字典/列表组成的配置数据、网络传输数据 |
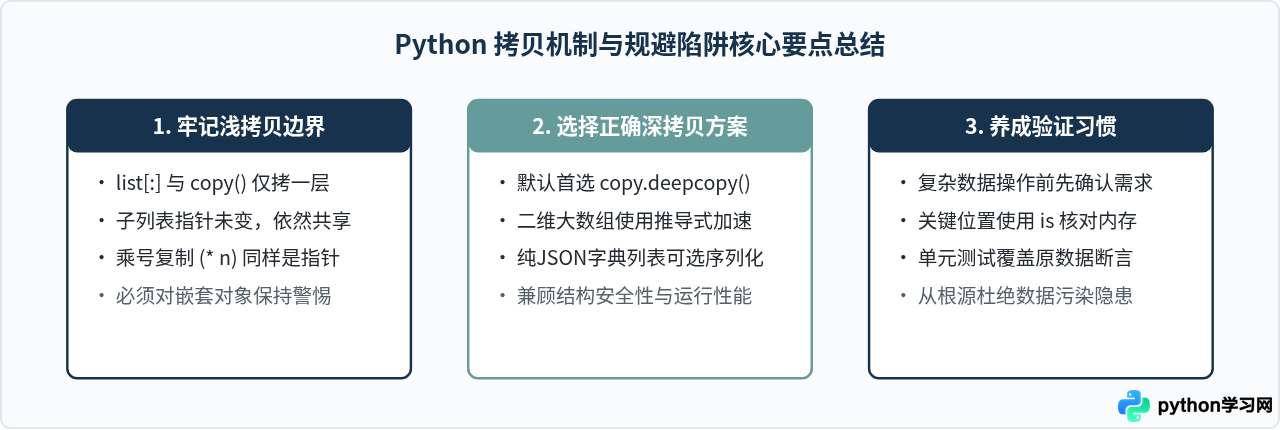
六、避坑与关键总结
除了显式的 .copy() 操作之外,还有一些隐蔽的语法其实也是浅拷贝操作,极易产生同类陷阱:
- 乘号重复创建列表:
matrix = [[0] * 3] * 3。这种写法创建的三个子列表其实是同一个对象的3次引用,修改matrix[0][0] = 1会导致整列元素同步变为 1。正确写法应为:[[0] * 3 for _ in range(3)]。 - 切片切出子列表:
sub_matrix = matrix[1:3]。虽然外层切片是新的列表,但里面的子行依然是原有的引用。 - 函数默认参数陷阱: 将嵌套可变列表作为函数默认参数(如
def func(data=[[]]):),会导致跨函数调用共享同一数据实体。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















