


Python代码运行结果出现乱码怎么解决
详细讲解Python代码运行结果出现乱码的原因与完整解决方法,涵盖Windows终端控制台、文件读写、VS Code与PyCharm环境配置及异常字符处理策略。
Python代码运行结果出现乱码,本质上是“文本产生处的编码规则”与“终端或目标程序展示时的解码规则”不匹配。最常见的场景包括:Windows默认命令行(CMD/PowerShell)使用GBK代码页解析Python输出的UTF-8字节流、读写文件时未显式声明字符编码、或者IDE内部输出窗口编码配置脱节。解决这一问题的核心逻辑不是盲目转换字符串,而是理清文本在“源文件存储、内存解析、IO通道传输与终端显示”四个环节中的编码流向,并确保各环节保持一致的UTF-8标准。
一、为什么会出现乱码:数据流转与编码脱节
计算机内部只识别二进制字节(bytes),人类可读的文字(str)必须经过特定编码规则映射为字节,读取时再用相同规则还原为文字。如果在写入或输出时采用了编码规则A(如UTF-8),而接收端或终端采用了规则B(如GBK或Windows-1252)进行解释,就会出现字符错位或无法解析,表现为乱码、问号或直接抛出UnicodeDecodeError。
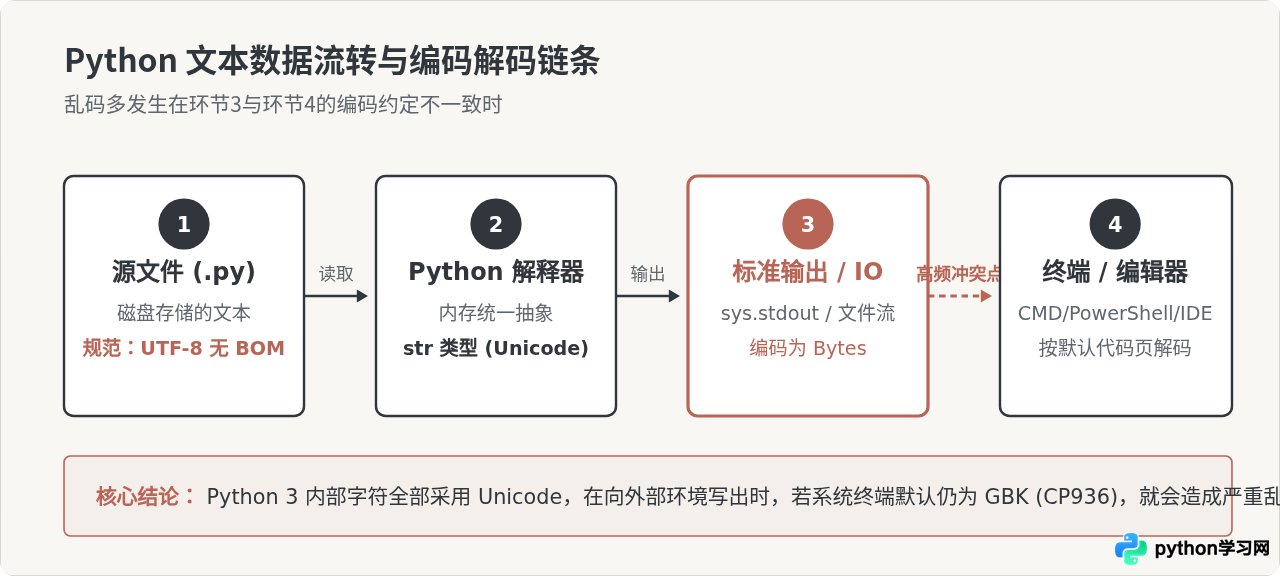
从 Python 3 开始,所有字符串在内存中都是 Unicode 对象。因此“Python 内部无法处理中文”的说法是不准确的,乱码几乎全部发生在与外部交互的边界上:源文件读取、控制台输入输出、文件读写、以及网络请求。
二、四步排查与解决流程
排查乱码时,建议按照从源码自身到执行环境的顺序逐步验证,不要在没有定位问题根源前随意对字符串执行多次 encode() 和 decode(),否则容易导致二次乱码。
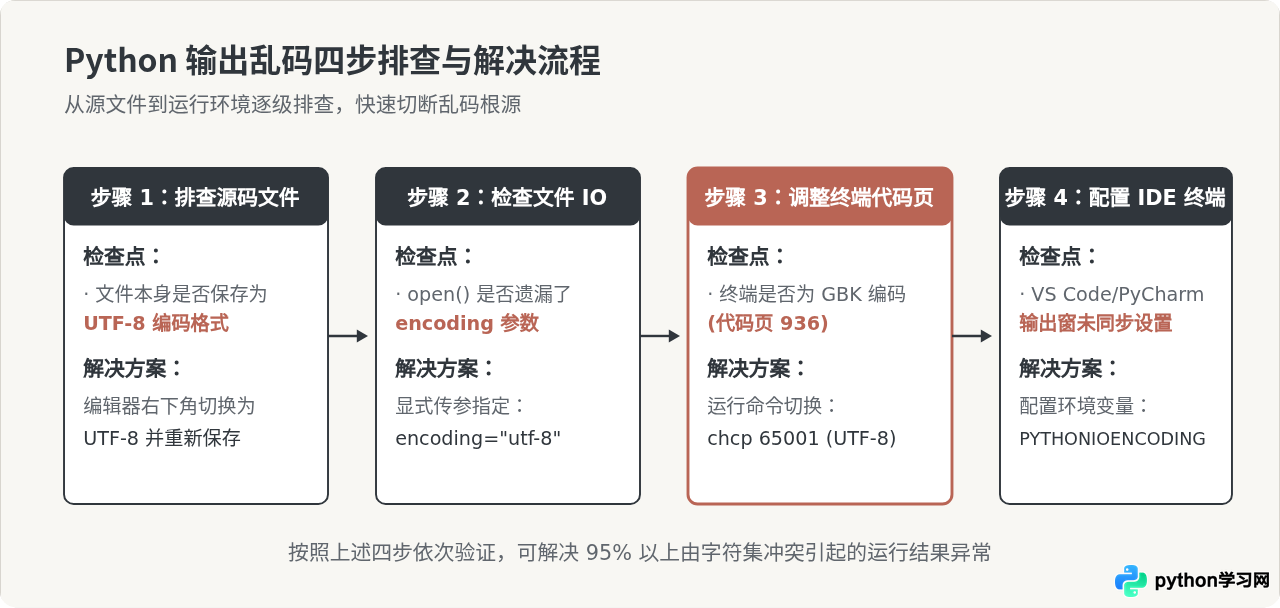
步骤 1:确认源码文件保存编码为 UTF-8
如果 Python 脚本本身包含中文字符串常量(例如 msg = "数据处理完成"),但在保存文件时被编辑器错误保存为 GBK 或 ANSI 编码,解释器在读取脚本时就会将其错误解析。
虽然 Python 3 默认源文件编码即为 UTF-8(根据 PEP 3120),但仍建议确保编辑器右下角显示为 UTF-8。如需在包含特殊环境的旧系统上运行,也可以在脚本首行添加编码声明魔法注释:
# -*- coding: utf-8 -*-
msg = "你好,世界"
print(msg)
步骤 2:规范文件 I/O 读写,显式声明 encoding
很多初学者使用 open("data.txt", "r") 或 open("out.txt", "w") 时不传递 encoding 参数。在 Windows 系统上,Python 默认会使用系统本地编码(locale.getpreferredencoding(),中文版即为 cp936/gbk)。当尝试读取 UTF-8 编码的文件时,直接触发报错:
正确做法是:在打开任何文本文件时,始终显式指定 encoding="utf-8":
# 规范读取文本文件
with open("data.txt", mode="r", encoding="utf-8") as f:
    content = f.read()
    print("读取结果:", content)

# 规范写入文本文件
with open("result.txt", mode="w", encoding="utf-8") as f:
f.write("执行成功\n")如果文件是由 Windows 记事本创建且带有 UTF-8 BOM 标记(文件头存在 \ufeff),直接使用 encoding="utf-8" 读取可能会在首个字符前多出一个不可见的零宽空格,甚至导致首行解析报错。此时可将编码参数更改为 encoding="utf-8-sig",Python 会自动剔除开头的 BOM 标记。
步骤 3:修复 Windows 终端(CMD / PowerShell)显示乱码
如果在执行 print("中文测试") 时终端输出了类似 电脑 或者 ,通常是因为当前终端的代码页仍处于 GBK 模式(代号 936)。此时可以通过以下方法将终端输出环境矫正为 UTF-8:
方法 A:临时更改命令行代码页
在打开 CMD 或 PowerShell 后,运行 Python 脚本之前执行:
chcp 6500165001 代表 UTF-8 编码。之后再运行 python your_script.py,终端即可正常渲染中文字符。
方法 B:设置环境变量 PYTHONIOENCODING
该变量用于强制指定 Python 的标准输入(stdin)、标准输出(stdout)和标准错误(stderr)的编码方式。可以在执行脚本前直接设置:
# 在 Windows CMD 中执行
set PYTHONIOENCODING=utf-8
python your_script.py

# 在 PowerShell 中执行
$env:PYTHONIOENCODING="utf-8"
python your_script.py
方法 C:启用 Python 3.7+ 的 UTF-8 模式
Python 3.7 引入了 PEP 540(UTF-8 Mode)。使用 -X utf8 参数启动时,Python 会忽略系统当前的 locale 编码,强制全链路默认使用 UTF-8:
python -X utf8 your_script.py步骤 4:校准 VS Code 与 PyCharm 内部终端
开发工具自带的运行窗口配置与外部独立终端有时存在偏差,需根据使用工具具体调整:
- VS Code:推荐使用内置终端(Terminal)运行而非某些非交互式插件窗口。若使用 Code Runner 插件且输出乱码,需打开
settings.json,在code-runner.executorMap中将 Python 执行命令修改为:"python": "set PYTHONIOENCODING=utf8 && python -u"。 - PyCharm:依次进入
File -> Settings -> Editor -> File Encodings,将 Global Encoding、Project Encoding 以及 Default encoding for properties files 全部设为UTF-8,并在 Create UTF-8 files 中选择with NO BOM。
三、不同运行环境下的诱因与方案对照
为了便于快速定位不同开发与部署环境下的特殊问题,下表及图示归纳了四种常见环境的乱码表现与推荐解决方案。
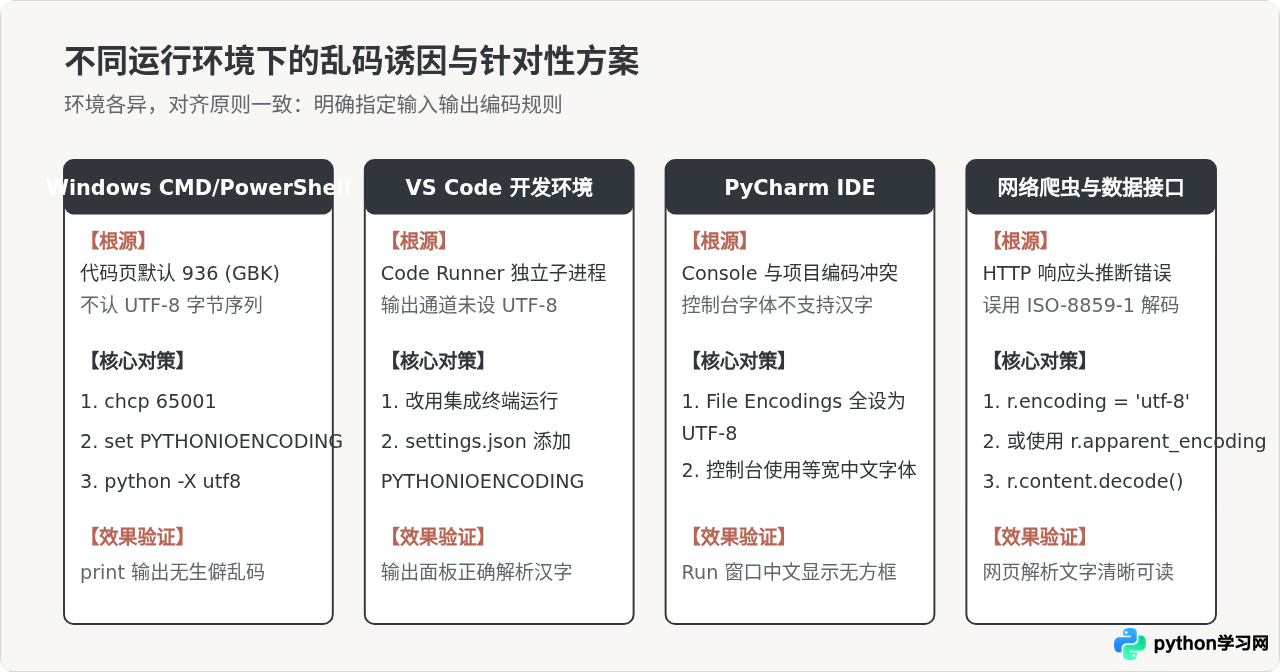
| 场景 | 典型乱码表现 | 根本原因 | 标准修复方案 |
|---|---|---|---|
| Windows CMD / PowerShell | 出现 锟斤拷、生僻古文或问号 |
控制台处于 GBK (代码页 936) 状态 | 执行 chcp 65001 或设置 PYTHONIOENCODING=utf-8 |
| 读写本地 CSV / TXT 文件 | 抛出 UnicodeDecodeError 或文本显示乱码 |
open() 未传 encoding,默认采用系统 GBK |
统一声明 encoding="utf-8" 或 encoding="utf-8-sig" |
| 第三方库 Requests 请求网页 | 网页内容显示为 ä½ å¥½ 等英文字符组合 |
HTTP 响应未声明编码,库默认使用 ISO-8859-1 | 手动指定 response.encoding = response.apparent_encoding |
| 子进程执行 (subprocess) | 读取输出时乱码或解码崩溃 | 子进程继承外部环境编码,解码未指定格式 | 在 subprocess.Popen 中指定 encoding="utf-8" |
四、进阶场景:非标准数据与异常字符容错
在实际生产业务中,我们经常需要处理历史数据或格式混乱的多源文本。有时文件中混入了极少数非法字节,若直接崩溃会阻断整批任务的处理流程。此时可借助标准库提供的异常处理策略进行安全兜底:
# 方案一:遇到无法解码的损坏字节时,替换为通用占位符(避免脚本抛出异常中断)
with open("dirty_data.txt", mode="r", encoding="utf-8", errors="replace") as f:
    safe_content = f.read()
    # 损坏的非法字节会被安全替换为 '' (U+FFFD)

# 方案二:直接忽略无法解码的非法字节
with open("dirty_data.txt", mode="r", encoding="utf-8", errors="ignore") as f:
    clean_content = f.read()

# 方案三:字节串反序列化时的容错控制
raw_bytes = b"\xe4\xbd\xa0\xe5\xa5\xbd\xff"  # 末尾 \xff 为非法 UTF-8 字节
text = raw_bytes.decode("utf-8", errors="replace")
print("容错解码结果:", text)errors="ignore" 或 errors="replace" 仅适用于清洗容错场景。若绝大部分字符都变成了替代符号,说明所选的基础编码(如 UTF-8)根本不对,应当尝试改用 gb18030 等中文超集编码进行解析,而不是强行忽略错误。
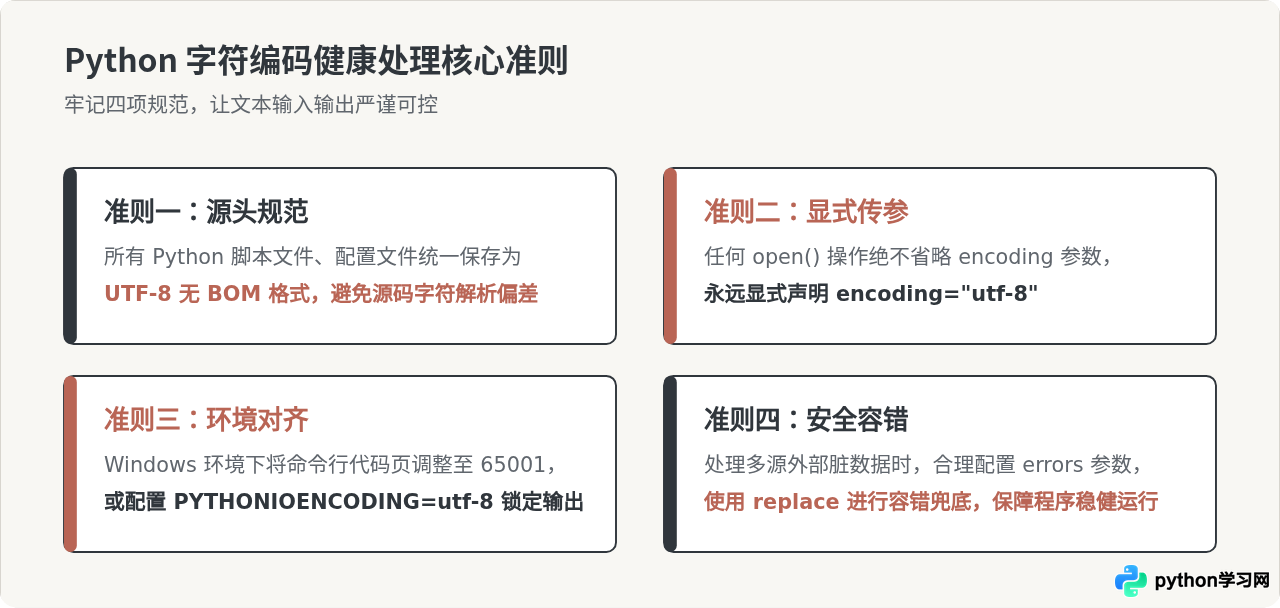
五、防范乱码的核心准则总结
要从根本上杜绝 Python 运行结果乱码,建议在日常开发中遵守以下四条核心准则:
总结而言,乱码并非神秘莫测的系统故障,只要牢牢把握“内存中始终是 Unicode,向外部输出或接收外部输入时明确指定 UTF-8 编码”的原则,便能从容解决各类 Python 运行结果异常问题。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















