


Python读取CSV某一行出现乱码怎么办

在用 Python 处理 CSV 文件时,如果整篇文件打开都呈现乱码,通常只需换用正确的全局编码格式(例如把 utf-8 改为 gbk)即可解决;但最棘手的情况往往是前几千行读取完全正常,偏偏在中间某一行抛出 UnicodeDecodeError,或者该行解析出来的中文变成了问号与无序字符。遇到单行乱码,核心解决路径通常分为三步:先用二进制模式('rb')定位故障行并抓取原始字节,再确认该行是属于字符集超界、多编码拼接还是被异常换行截断,最后选用 gb18030 升轨、逐行自适应探测或设定容错策略完成清洗。
一、成因分析:为什么只有某一行乱码?
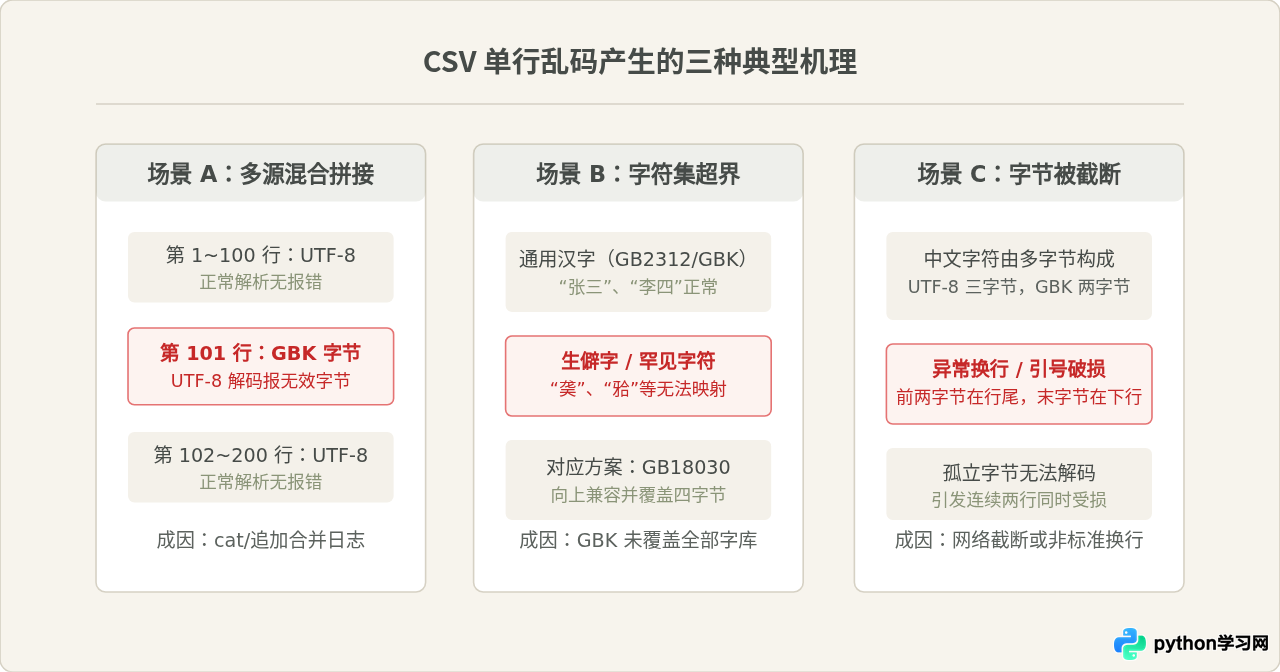
文件绝大部分内容可以被正常解析,说明当前指定的编码模式契合绝大部分文本。单个局部行的解码异常,往往由以下三种真实场景引起:
- 多源数据合并拼接:日常业务中,多份 CSV 经常通过脚本简单追加合并(如 shell 的
cat *.csv > total.csv)。如果其中某份文件来自早期的 Windows 客户端(默认使用GBK),而其他文件来自现代 Linux 导出接口(默认UTF-8),整合成一份文件后,来自不同源头的数据行便具有不同的编码字节序列。 - 生僻字或特殊符号超出字符集:有些系统采用
GBK或GB2312编码写入文件。常用汉字能正常解析,但某一行若包含人名中的生僻字、方言字或特殊符号(如“𬌗”、“䶮”),就会超出GBK覆盖范围,触发局部解码失败。 - 字段内未闭合引号或换行符截断:CSV 字段内若存在未经转义的双引号或换行符,解析器在按行切分字节流时可能将属于一个多字节字符的连续字节切断到两行中,导致后半段字节无法拼出有效字符。
辨析:“只要在 open() 中加上 encoding='utf-8' 就不会乱码”是否成立?
这个说法在文件完全由规范的 UTF-8 编码器单一生成时是成立的。但如果数据源经过人工复制粘贴、旧版 Excel 导出追加,或者跨系统的命令行合并,文件内部可能同时包含 UTF-8 和 GBK 字节。此时无论在全局指定哪一种编码,都会在相悖的那一行抛出解码错误。
二、排查步骤:精准定位问题行与原始字节
当文件体积较大时,切忌直接在文本编辑器中胡乱修改编码重存,这样容易造成二次损坏。正确的第一步是用 Python 原生二进制方式把问题行锁定。
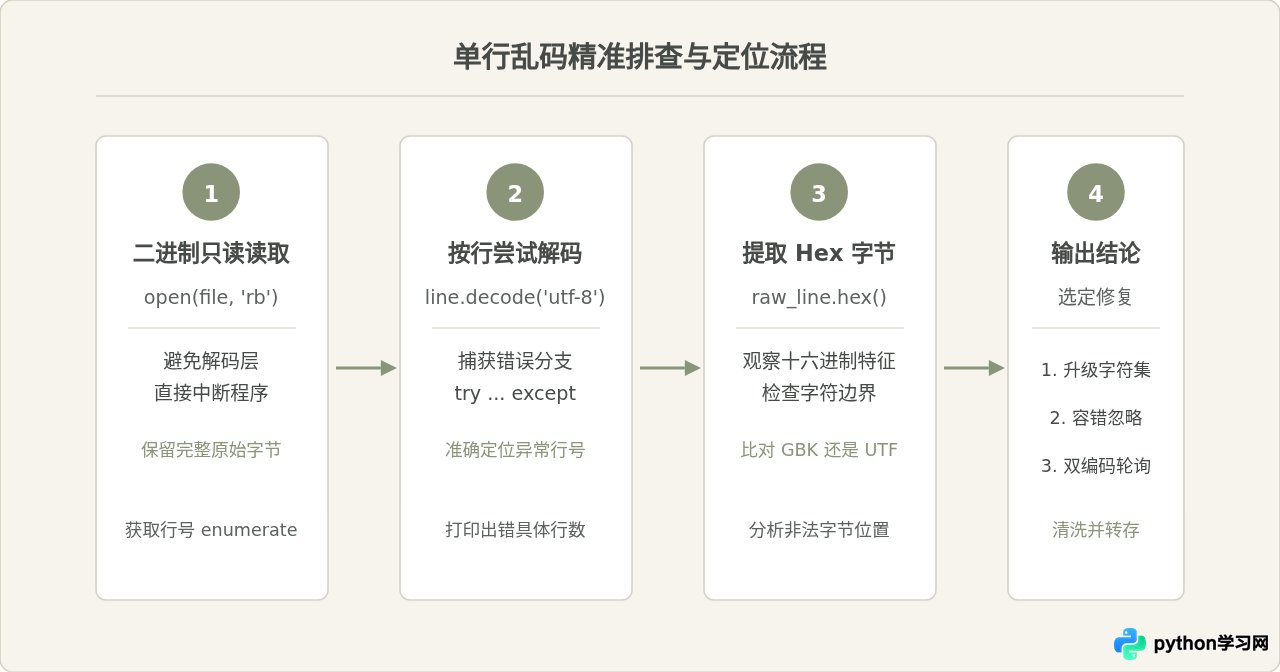
定位故障行的排查脚本
以下脚本以二进制逐行读取文件,记录行号并尝试用主编码(以 utf-8 为例)解码。一旦发生报错,脚本将捕获该行并打印行号和十六进制切片:
def inspect_csv_encoding_errors(file_path, primary_encoding='utf-8'):
    error_records = []

    with open(file_path, 'rb') as f:
        for line_no, raw_line in enumerate(f, start=1):
            try:
                raw_line.decode(primary_encoding)
            except UnicodeDecodeError as e:
                # 记录报错行号、异常字节范围以及原始十六进制
                start, end = e.start, e.end
                bad_bytes = raw_line[start:end]
                error_records.append({
                    'line_no': line_no,
                    'reason': e.reason,
                    'bad_bytes_hex': bad_bytes.hex(),
                    'raw_line_snippet': raw_line[:60]
                })
                # 打印前 3 处故障信息进行快速诊断
                if len(error_records) <= 3:
                    print(f"[异常] 第 {line_no} 行解码失败!")
                    print(f"      原因: {e.reason}")
                    print(f"      异常字节 (Hex): {bad_bytes.hex()}")
                    print(f"      行内容切片 (Bytes): {raw_line[:60]}\n")

    print(f"排查完毕,共发现 {len(error_records)} 行编码异常。")
    return error_records

# 示例调用
# inspect_csv_encoding_errors('order_data.csv', primary_encoding='utf-8')
运行结果示例:
[异常] 第 354 行解码失败!
      原因: invalid start byte
      异常字节 (Hex): d5c5
      行内容切片 (Bytes): b'2026-03-01,10034,\xd5\xc5\xc8\xfd,shipped\r\n'

排查完毕,共发现 1 行编码异常。
在上面的诊断结果中,第 354 行出现的 \xd5\xc5\xc8\xfd 正好是“张三”在 GBK 下的编码(D5C5 为“张”,C8FD 为“三”)。由此可证实:这是一个全局为 UTF-8 但中间混入了一行 GBK 编码数据的典型混合文件。
三、针对性解决方案与代码实现
明确了具体行出错的原因后,可以根据业务场景的严谨度,从以下三种方法中挑选适用方案:
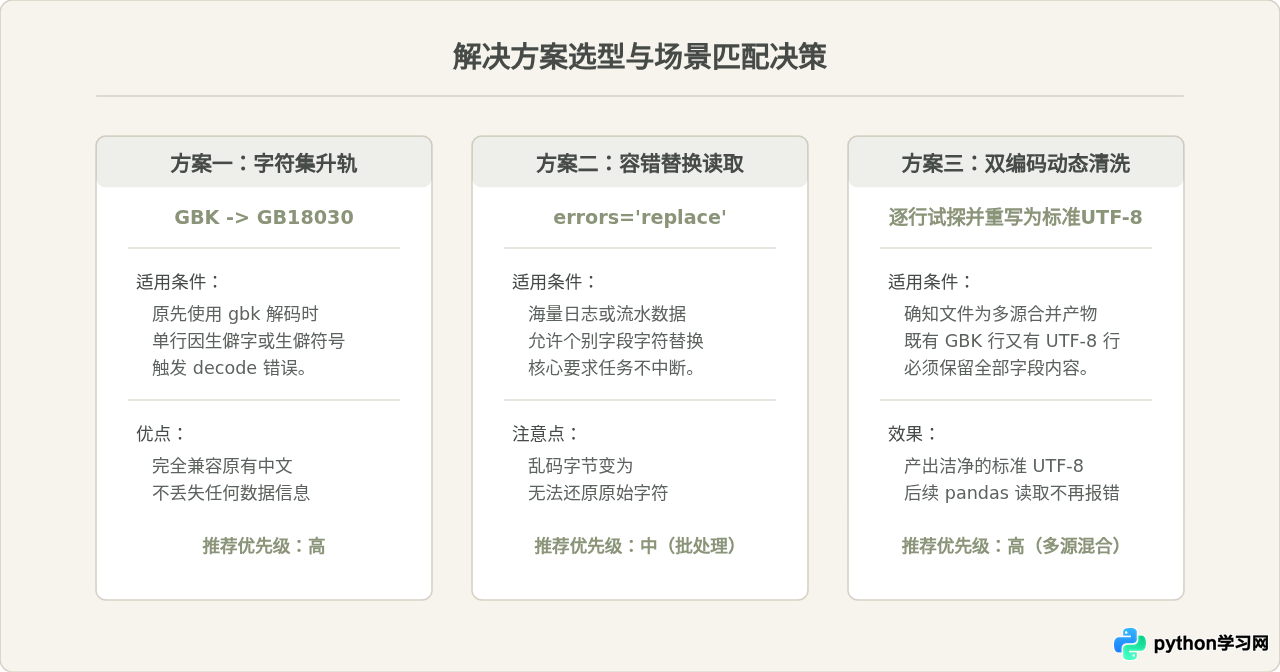
方法一:全面采用 GB18030 代替 GBK / GB2312
许多初学者在遇到中文乱码时习惯填写 encoding='gbk'。然而 GBK 仅包含两万多个汉字字符,当某一行出现冷僻汉字时便会报错。国家标准的 GB18030 不仅向后兼容 GBK 和 GB2312,还完整收录了数万个生僻汉字与少数民族字符。只需将参数调整如下:
import csv

# 将原本的 gbk 改为 gb18030,解决生僻字单行报错
with open('data.csv', mode='r', encoding='gb18030') as f:
    reader = csv.reader(f)
    for row_idx, row in enumerate(reader, start=1):
        # 正常业务处理
        pass
方法二:使用 errors='replace' 阻止程序中断
在海量数据迁移或流式解析中,若业务允许偶发未知符号替换为替代字符 (U+FFFD),可以使用 errors='replace' 或 errors='backslashreplace':
import pandas as pd

# Pandas 方案:设置 encoding_errors 参数(Pandas 1.3+ 支持)
df = pd.read_csv('data.csv', encoding='utf-8', encoding_errors='replace')

# 原生 Python 方案:
with open('data.csv', mode='r', encoding='utf-8', errors='replace') as f:
    for line in f:
        # 异常字节会被替换为问号或占位符,不中断读取
        pass
方法三:多源混合编码文件的逐行清洗与归一化
对于既包含 UTF-8 行又夹杂 GBK 行的“混合文件”,最稳健的方案是编写清洗函数,将每一行分别试探解码,统一重写为规范的 UTF-8 文件:
def sanitize_mixed_csv(input_path, output_path):
    """
    清洗混合编码 CSV 文件,将各行逐一归一化为标准的 UTF-8 编码
    """
    total_lines = 0
    fixed_lines = 0

    with open(input_path, 'rb') as fin, \
         open(output_path, 'w', encoding='utf-8', newline='') as fout:

        for raw_line in fin:
            total_lines += 1
            decoded_str = None

            # 优先尝试 UTF-8 解码
            try:
                decoded_str = raw_line.decode('utf-8')
            except UnicodeDecodeError:
                # 若 UTF-8 失败,再尝试 GB18030 解码
                try:
                    decoded_str = raw_line.decode('gb18030')
                    fixed_lines += 1
                except UnicodeDecodeError:
                    # 极端损坏情况下使用 replace 保全结构
                    decoded_str = raw_line.decode('utf-8', errors='replace')
                    fixed_lines += 1

            fout.write(decoded_str)

    print(f"清洗完成:处理 {total_lines} 行,修复并转换 {fixed_lines} 行非标准编码数据。")

# 调用清洗函数生成规整的新文件
# sanitize_mixed_csv('dirty_source.csv', 'clean_output.csv')
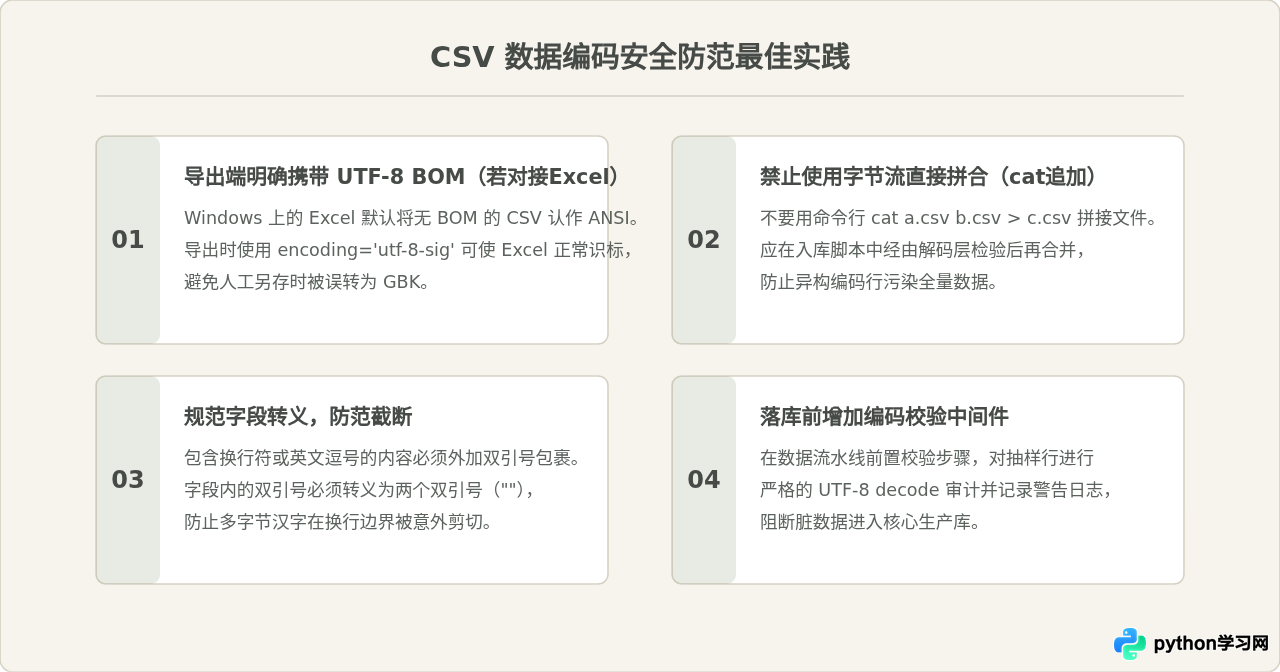
四、预防与工程实践清单
单行乱码在下游系统暴发往往会产生连锁反应,建立上游防护和入库校验机制是杜绝该问题的根本方式。
五、总结
遇到 Python 读取 CSV 仅有单行乱码或报错时,切忌盲目更换全局编辑器编码直接覆盖原文件。最规范且高效的处理顺序是:
- 以二进制模式(
'rb')开辟文件流,配合enumerate()定位精确报错行号与原始字节; - 依据异常字节诊断原因:若为生僻字,直接在读取配置中由
gbk提升至gb18030;若为异构系统合并带来的多编码混杂,采用逐行try-except轮询解码并重写为标准 UTF-8; - 在线上流水线中配置
errors='replace'或记录告警机制,在保障生产任务平稳运行的同时沉淀异常样本进行上游追溯。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















