


Python序列包括哪三种:列表、元组与字符串

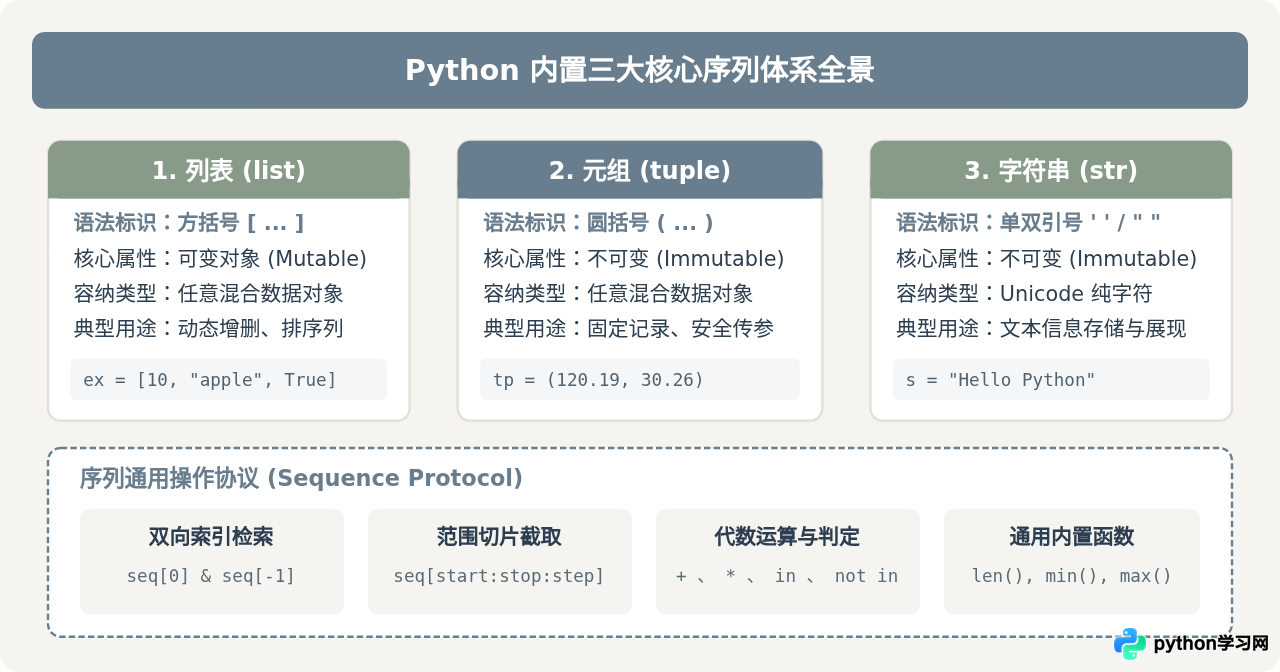
在Python编程语言中,标准内置的核心序列类型主要包括三种:列表(list)、元组(tuple)与字符串(str)。所谓序列,是指一组按照严格先后次序排列的元素集合,支持按位置索引访问、范围切片截取、正反向遍历以及计算长度等一系列通用操作。理解这三种序列的核心差异、底层可变性特征及各自适用场景,是编写高质量Python程序必不可少的基础功底。
一、序列(Sequence)的通用特征与基础机制
在深入探讨三种具体类型之前,先明确它们之所以被称为“序列”所共享的基础能力。Python中的序列具备统一的协议规范,只要一个对象属于序列,就可以无缝使用以下语法和内置函数:
- 按索引精确定位:支持以
0为起点的非负整数正向索引,以及以-1为起点的负整数反向索引。 - 连续范围切片:使用
sequence[start:stop:step]语法按指定步长提取子序列,而不修改原数据。 - 运算符复用:支持使用加号
+进行序列拼接,使用乘号*进行重复复制,使用in和not in快速检查成员是否存在。 - 通用内置函数:可以直接传给
len()统计长度、min()和max()查找极值,以及调用.count()和.index()统计频次与定位首次出现的索引。
二、列表(list):灵活可变的动态容器
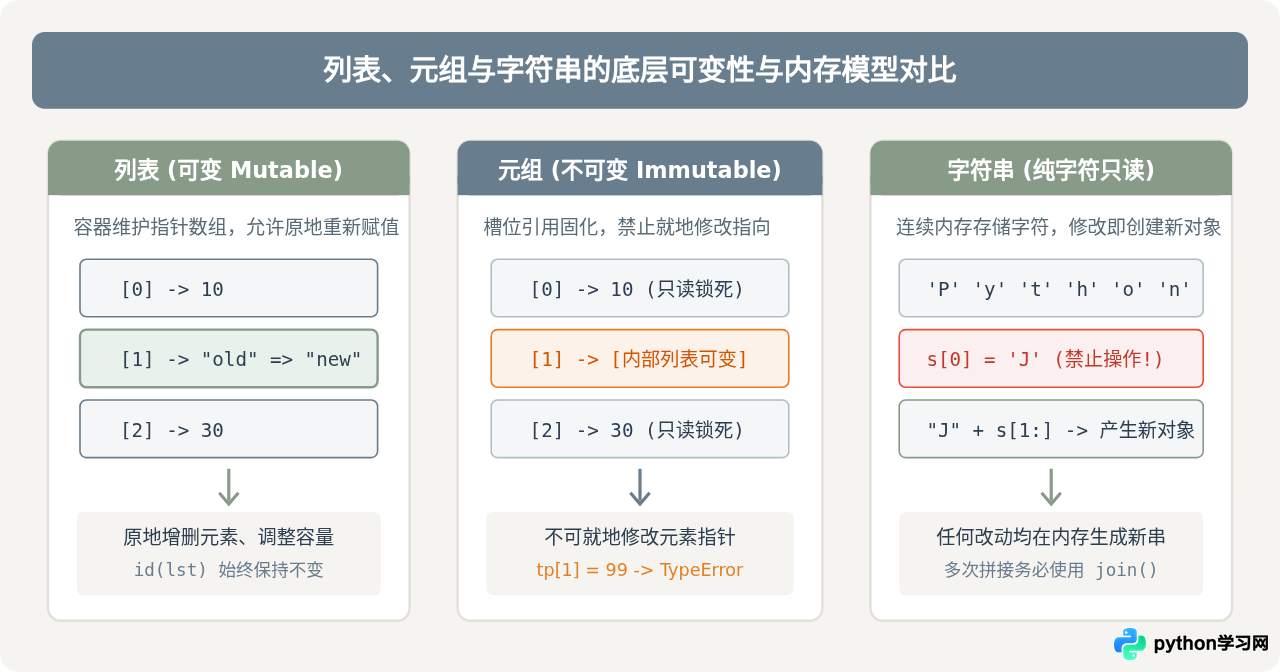
列表是Python开发中使用频次最高、功能最为丰富的序列类型。它使用方括号 [...] 来表示,元素之间用逗号分隔。列表最关键的特征是其可变性(Mutable),这意味着创建列表之后,你可以随时在原内存地址上添加、删除或修改其中的元素,而不需要重新分配整个容器对象。
1. 常用修改操作与原地方法
列表内置了丰富的就地修改方法。下面的代码展示了最常见的列表操作,注意观察操作前后列表的动态改变:
# 1. 创建包含混合类型的列表
fruits = ["apple", "banana", "cherry"]

# 2. 追加元素到尾部
fruits.append("date")

# 3. 在指定索引位置插入元素
fruits.insert(1, "orange")

# 4. 删除指定值的第一个匹配项,或弹出末尾元素
fruits.remove("banana")
last_item = fruits.pop()

# 5. 修改指定索引处的元素值(就地修改)
fruits[0] = "avocado"

print("处理后的列表:", fruits)
print("弹出的末尾元素:", last_item)弹出的末尾元素: date
new_list = old_list.copy() 或切片 new_list = old_list[:] 进行独立浅拷贝。
三、元组(tuple):稳固只读的数据载体
元组使用圆括号 (...) 表示。与列表最大的不同在于,元组一旦创建,其长度与元素绑定就完全不可变(Immutable)。你不能向元组追加、删除元素,也不能更改某个索引位置上的指向。正因为这种不可变性,元组在底层具有更轻量的内存开销,同时天然具备数据防篡改的安全性。
1. 语法要点:单元素元组的逗号规则
初学者容易产生的一个语法误区是定义单元素元组。如果在圆括号内只写一个元素而没有逗号,Python解释器会将其视作普通的数学优先级括号,从而解析为该元素本身;必须附带逗号才能正确识别为元组:
# 错误方式:被当作普通整数
not_a_tuple = (42)
print("类型:", type(not_a_tuple))

# 正确方式:必须保留尾部逗号
real_tuple = (42,)
print("类型:", type(real_tuple))类型: <class 'tuple'>
2. 元组的适用场景
元组常用于以下几类业务场景:
- 函数的多个返回值:当函数用逗号返回多个变量时,Python会自动打包为一个元组进行返回。
- 字典的键(Key)或集合元素:字典的键要求必须是可哈希(Hashable)的不可变对象。列表不可作为字典键,而仅包含不可变元素的元组可以。
- 配置与不可变记录:如地理坐标
(latitude, longitude)或系统固定端口号配置,防止在运行逻辑中被误改。
四、字符串(str):不可变的文本字符序列
字符串使用单引号 '...'、双引号 "..." 或三引号 '''...''' 界定。与其他编程语言不同,Python中没有独立的 char 字符类型,单个字符在Python中本质上就是长度为 1 的普通字符串。
字符串同样具有不可变性。这意味着无法对字符串中的某个索引字符执行赋值操作:
text = "Python"

# 尝试直接赋值会直接抛出 TypeError 异常
try:
    text[0] = "J"
except TypeError as e:
    print("捕获错误:", e)

# 正确做法:通过切片与新字符组合生成新字符串
new_text = "J" + text[1:]
print("新生成的字符串:", new_text)新生成的字符串: Jython
+= 拼接大量字符串,会导致频繁申请内存并拷贝旧字符串,性能极低。处理批量字符串时,应始终先收集到列表内,最后调用 "".join(list) 一次性完成高效拼接。
五、深入核心:序列切片与索引计算三步法则
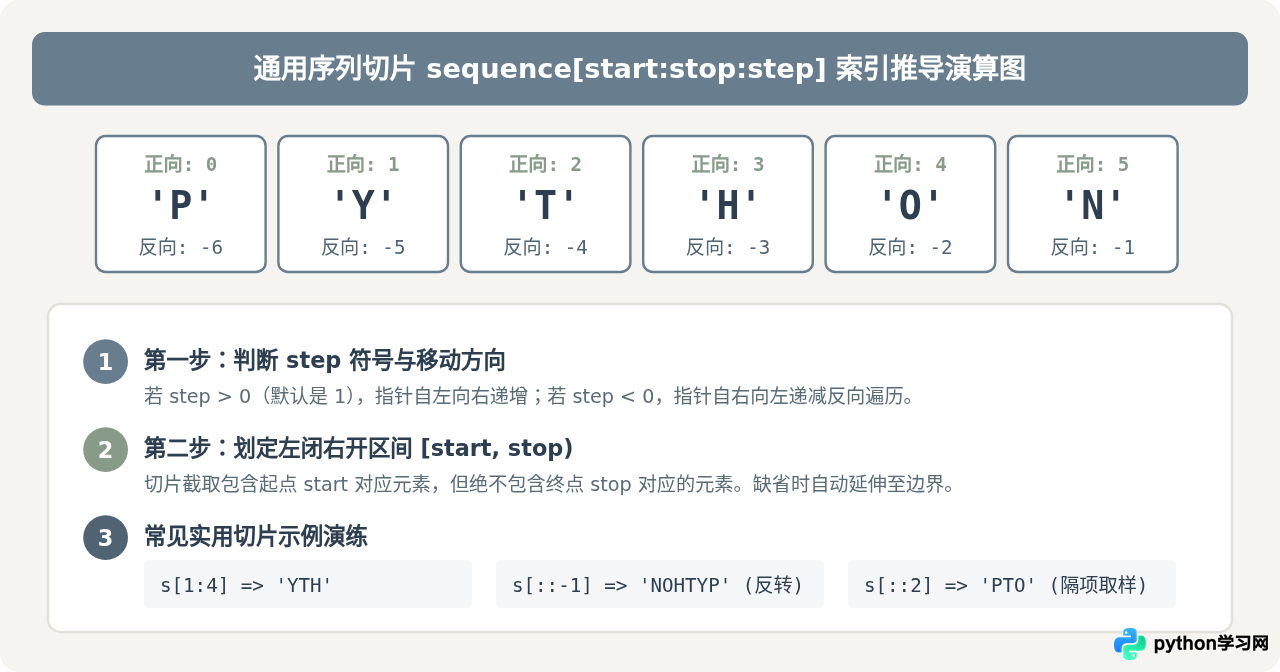
既然这三种类型同属序列,那么它们在进行元素索引与范围截取时,采用的是完全同一套计算准则。掌握切片语法 sequence[start:stop:step] 的推导逻辑,是灵活操作序列的必备能力。
六、三种序列的关键属性综合对比与选型原则
为了让知识体系更加清晰,下表从可变性、容纳元素类型、哈希支持、内存性能和典型业务场景等维度,对列表、元组与字符串进行了全方位对比:
| 特性维度 | 列表 (list) | 元组 (tuple) | 字符串 (str) |
|---|---|---|---|
| 可变性 (Mutability) | 可变 (Mutable),支持就地增删改 | 不可变 (Immutable),定义后不可改 | 不可变 (Immutable),修改即生成新对象 |
| 容纳元素类型 | 任意混合类型(整数、对象、列表等) | 任意混合类型(整数、对象、列表等) | 仅限字符(本质为Unicode码点) |
| 语法界定符 | 方括号 [1, 2, 3] |
圆括号 (1, 2, 3) |
引号 "hello" 或 'hello' |
| 字典键支持 (Hashable) | 不支持(不可哈希) | 支持(要求其所含元素均可哈希) | 支持(天然可哈希) |
| 内存与执行效率 | 预留额外扩容槽位,内存开销稍大 | 固定尺寸紧凑存储,构造与访问更快 | 紧凑扁平字符数组,支持内部驻留机制 |
| 核心应用场景 | 动态数据集合、频繁排序列、队列堆栈 | 只读记录、经纬度常量、函数多返回值 | 文本展示、协议编码、日志与信息拼接 |
七、总结
回到最初的问题:“Python序列包括哪三种?”答案非常明确:列表(list)、元组(tuple)和字符串(str)。
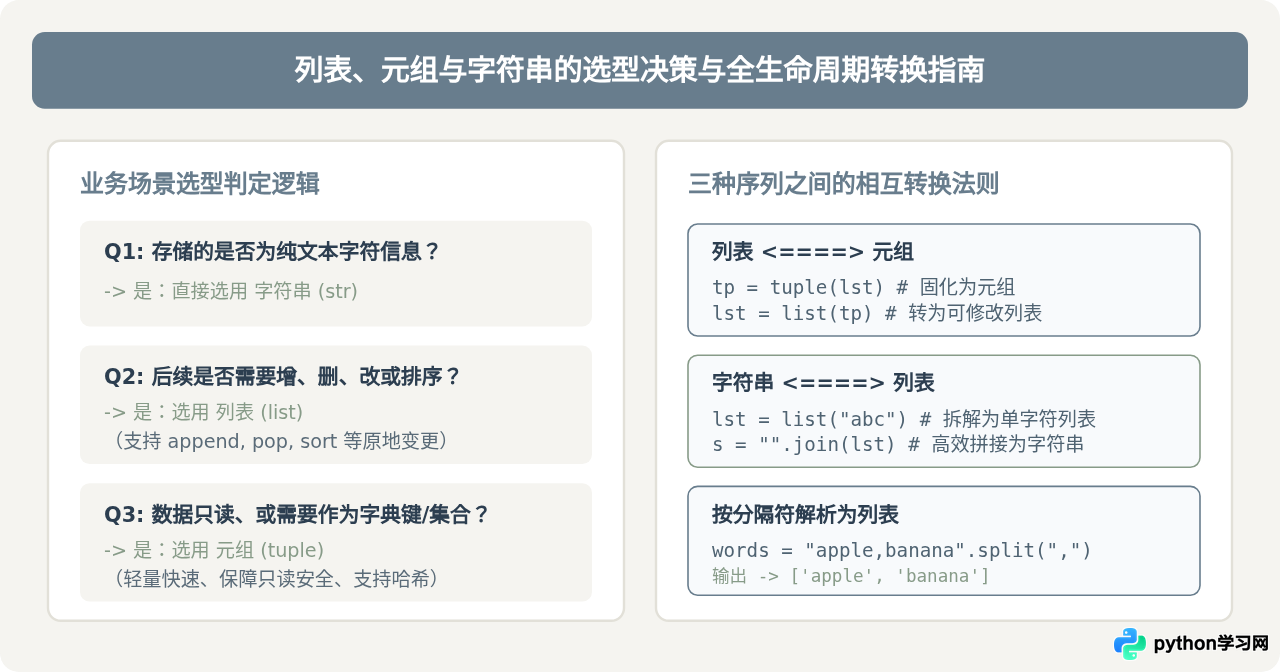
这三者共同继承了Python序列协议的优雅机制,支持统一的双向索引、切片计算与成员测试;同时又在可变性、存储类型和使用意图上有着清晰的分工:需要频繁增删与动态调整时选用列表;需要只读保护、做字典键或多值返回时选用元组;处理文本与字符信息时则选用字符串。熟练掌握它们之间的转换与差异,能帮助你在日常开发中写出更加健壮、高效且地道的Python代码。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















