


写Python爬虫违法吗?robots协议与数据采集法律边界解析
深入解析编写与运行Python爬虫的法律边界,涵盖技术中立原则、robots协议的法律性质、三大刑事民事红线及合规爬虫开发实践准则。
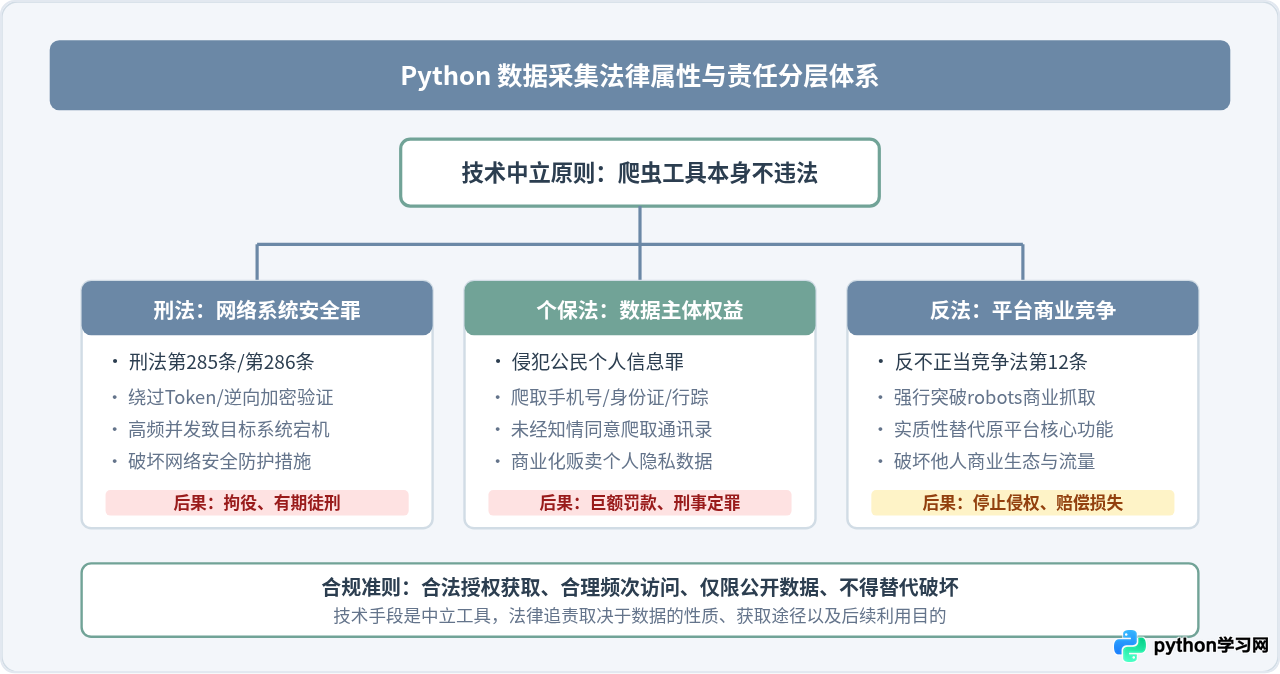
写 Python 爬虫本身是一项技术中立的行为,单纯编写和运行爬虫程序并不违法。但爬虫“抓取什么数据”、“采取什么技术手段”以及“如何使用采集到的数据”,受到《刑法》、《反不正当竞争法》、《个人信息保护法》与《网络安全法》等多部法律的严密规制。明确合规边界、理解 robots.txt 的法律性质并落实安全控制,是技术开发者的必备底线。
一、技术中立与法律定性:写爬虫到底违不违法?
在计算机技术语境中,网络爬虫(Web Crawler)本质上是一个通过 HTTP/HTTPS 协议自动化发起请求并解析响应内容的脚本程序。从技术中立原则出发,我国司法实践并不将“爬虫程序”本身定性为非法侵入计算机信息系统的专门工具。
法律评价的焦点并非编程语言(无论是 Python、Go 还是 JavaScript),而是行为人的采集行为与数据用途:
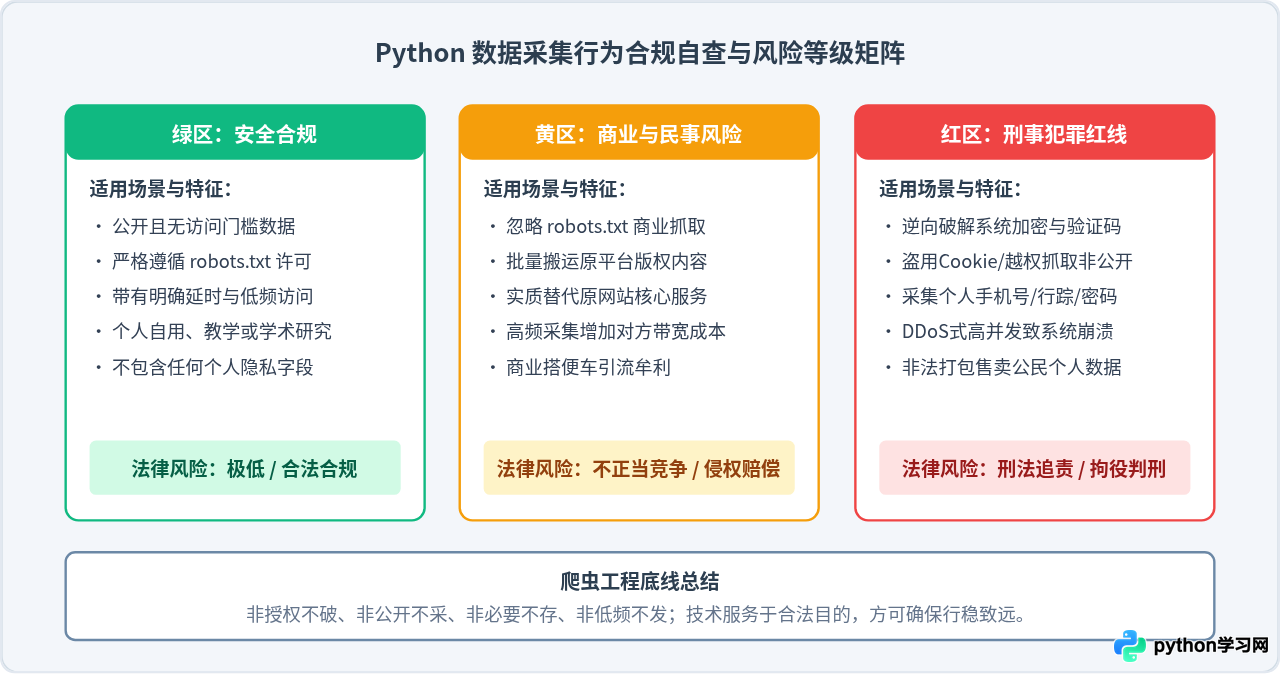
- 爬虫合法空间:采集网络上公开、未设访问限制且不包含个人隐私或他人商业秘密的数据,用于个人学术研究、搜索引擎索引或数据分析,且采集频率控制在服务器合理负载范围内。
- 爬虫违法边界:一旦涉及未经授权越权访问、破解加密验证机制、爬取敏感个人信息、导致对方服务器瘫痪,或将数据直接用于同业竞争以替代原平台服务,就会触碰民事侵权甚至刑事犯罪红线。
二、robots.txt 协议的性质与法律效力
许多开发者存在误解,认为 robots.txt 是具有强制约束力的法律条文;或者反过来,认为 robots.txt 只是技术建议,完全不用理会。这两种理解均不准确。
1. 什么是 robots.txt?
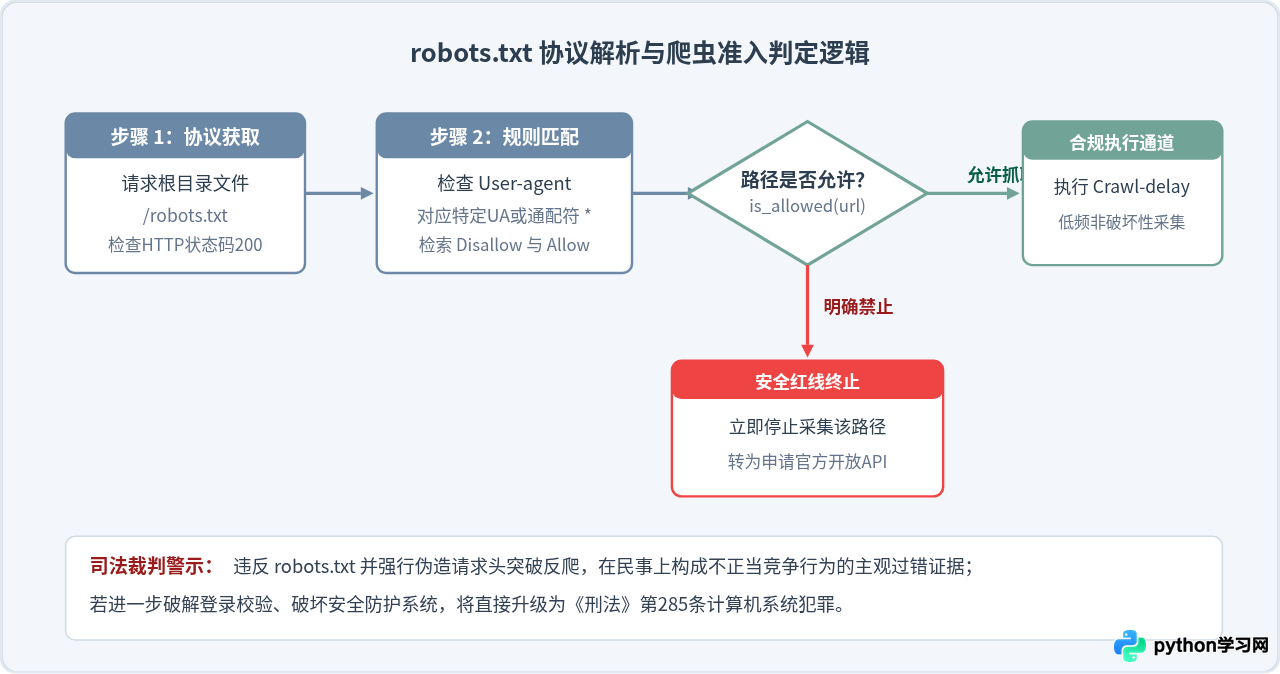
robots 协议(Robots Exclusion Protocol)是网站所有者与搜索引擎网络爬虫之间约定的国际通行规范。它存放在网站根目录下(例如 https://example.com/robots.txt),通过纯文本指令声明本站哪些内容允许被特定爬虫抓取,哪些内容被禁止收录。
2. robots 协议的法律效力定位
- 非成文法规:robots.txt 并非由国家立法机关制定的强制性法律法规,其本身不具备行政规章或刑法的强制效力。
- 主观过错判定的关键证据:在民事司法实践(尤其是商业竞争诉讼)中,法院通常将 robots 协议视为网站所有者行使“所有权人排除他人无序使用”的明确意思表示。如果爬虫运营方明知 robots.txt 包含禁止指令,依然故意绕过反爬机制强行抓取并用于商业竞争,法院会将此作为认定其具备“主观恶意”和“不正当竞争”的核心事实依据。
3. Python 如何在代码中严格遵守 robots.txt
Python 标准库内置了 urllib.robotparser 模块,开发者可以在发起采集任务之前,先自动下载并解析目标站点的 robots.txt 文件,确保请求落在允许的路径范围之内:
import urllib.robotparser

def check_crawl_permission(target_url, user_agent="MyResearchBot"):
    """
    检查指定 URL 是否被目标网站 robots.txt 允许抓取
    """
    from urllib.parse import urlparse
    parsed = urlparse(target_url)
    robots_url = f"{parsed.scheme}://{parsed.netloc}/robots.txt"

    rp = urllib.robotparser.RobotFileParser()
    rp.set_url(robots_url)
    try:
        rp.read()
    except Exception as e:
        print(f"读取 robots.txt 失败或不存在: {e}")
        # 若无法读取且返回404,通常代表无特殊抓取限制,但仍需控制频率
        return False

    can_fetch = rp.can_fetch(user_agent, target_url)
    return can_fetch

# 示例调用
target = "https://example.com/public-data"
if check_crawl_permission(target):
    print("合规验证通过:该路径允许采集")
else:
    print("合规警告:该路径已被 robots.txt 明确禁止,终止采集!")
三、必须避开的三大法律红线与核心罪名
爬虫引发法律风险的情形,绝大多数不是因为代码写得不规范,而是行为触碰了明确的法律红线。在实际案例中,刑事定罪与民事判赔主要集中在以下三个领域:
1. 侵入与破坏计算机信息系统(刑法第285条、第286条)
这是爬虫工程师最容易面临的刑事法律风险。违法核心特征通常包括两类:
- 技术侵入手段:破解系统身份认证、篡改签名Token、逆向解密受保护的数据接口、绕过短信验证码或滑动验证等反爬防御机制,直接被认定为“侵入计算机信息系统”。
- 系统破坏手段:使用多线程或分布式高并发向目标服务器狂轰滥炸,导致目标站点带宽耗尽、CPU 负载过高、数据库连接溢出甚至业务中断,直接构成“破坏计算机信息系统罪”。
2. 侵犯公民个人信息(刑法第253条之一)
根据《中华人民共和国个人信息保护法》与《刑法》,未取得个人明确知情同意或超出合理法定范围,擅自批量采集、存储、买卖公民个人信息的行为构成犯罪。高危数据包括:身份证号、手机号码、家庭住址、人脸识别特征、银行卡信息、即时通讯聊天记录以及精准行踪轨迹等。即使爬取的数据散落于公开网页,如果未经授权将其汇聚整理成可识别特定自然人的数据库并用于商业牟利,同样认定为违法。
3. 不正当竞争与商业侵权(反不正当竞争法第12条)
如果采集行为针对的是同行业竞争对手的实质性核心商业资产(例如房产平台的房源明细、电商平台的商家评价、内容社区的独家帖文),并将这些数据直接在自己平台上重复展示,实质性替代了原平台服务、分流了原作者或原平台的合法流量,便属于典型的“搭便车”不正当竞争行为。在司法裁判中,原告常依据《反不正当竞争法》第十二条(互联网专条)索赔数百万元至数千万元。
四、Python 合规爬虫工程开发四大控制层
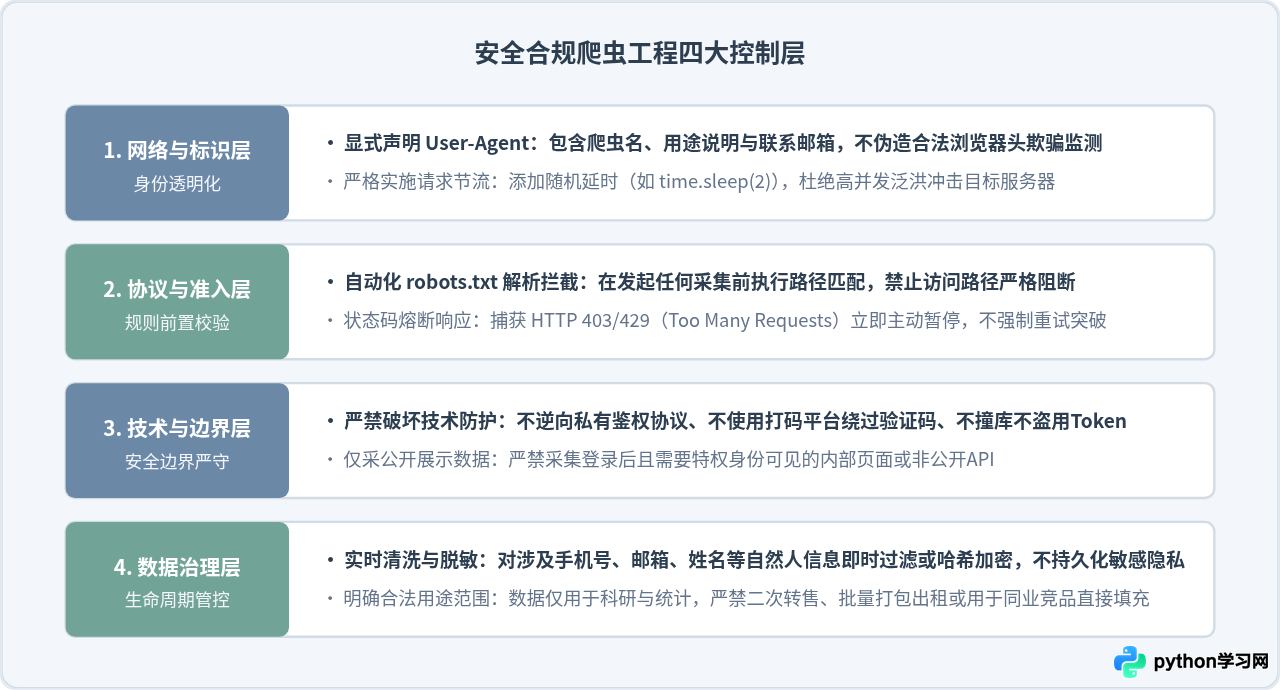
在设计一个面向实际生产或研究环境的 Python 爬虫时,应当自底向上建立安全与合规防御体系,覆盖从网络请求到数据存储的全生命周期。
合规采集示例:带有身份透明度与退避机制的 Python 脚本
以下示例展示了一个具备基本合规控制特性的爬虫脚本设计,包含了透明的 User-Agent、延时节流机制以及对服务器状态码的主动退避:
import time
import random
import requests

class CompliantCrawler:
    def __init__(self, bot_name="AcademicResearchBot", contact="researcher@example.edu"):
        # 显式声明身份与联系方式
        self.headers = {
            "User-Agent": f"{bot_name}/1.0 (+http://example.edu/bot; {contact})"
        }
        self.session = requests.Session()
        self.session.headers.update(self.headers)

    def fetch(self, url):
        # 1. 频率控制:基础休眠 + 抖动,避免单点峰值负载
        sleep_seconds = random.uniform(2.0, 4.0)
        time.sleep(sleep_seconds)

        try:
            response = self.session.get(url, timeout=10)

            # 2. 状态码感知与合规退出
            if response.status_code == 429:
                print("触发频次告警(429 Too Many Requests),立即停止抓取!")
                return None
            elif response.status_code == 403:
                print("目标系统返回403 Forbidden,禁止强行突破反爬,任务终止!")
                return None

            response.raise_for_status()
            return response.text

        except requests.exceptions.RequestException as e:
            print(f"网络异常或请求超时: {e}")
            return None

if __name__ == "__main__":
    crawler = CompliantCrawler()
    html_content = crawler.fetch("https://example.com/public-notice")
    if html_content:
        print("成功获取公开内容,准备进入脱敏处理流程")
五、数据采集行为合规自查与决策清单
为了让开发者在实际编写和部署数据采集任务时有清晰的对照依据,我们可以通过合规自查决策矩阵对拟采项目进行全方位评估:
| 自查维度 | 合规安全做法 | 高危违规做法 | 涉及法律法规 |
|---|---|---|---|
| 数据性质 | 公开展示、无需登录即可查看的信息 | 用户隐私、手机号、后台非公开数据 | 《个人信息保护法》《刑法》第253条之一 |
| 技术手段 | 标准HTTP请求、延时限频、身份透明 | 逆向破密、暴力破验证码、越权抓取 | 《网络安全法》《刑法》第285条/第286条 |
| 协议遵循 | 解析并遵守 robots.txt 中的抓取规则 | 明知 Disallow 依然伪造请求头强行突破 | 《反不正当竞争法》第12条 |
| 数据使用 | 内部学术研究、统计分析、模型自用 | 同业竞品直接搬运、转售个人信息牟利 | 《著作权法》《反不正当竞争法》 |
六、总结
回到最初的问题:“写 Python 爬虫违法吗?”答案非常明确:编写爬虫本身并不违法,但越过技术、数据与商业三道法律边界的采集行为一定会招致严厉制裁。
在日常开发与项目规划中,开发者应当始终坚持:
- 尊重 robots 协议:在技术上集成自动化前置检查,不强行采集被明确排除的敏感路径。
- 恪守技术手段底线:绝不破解安全认证机制,绝不发起对目标服务器产生实质性负载破坏的高频并发。
- 强化数据生命周期保护:严禁碰触未经授权的公民个人敏感信息,对采集到的普通数据坚持合法合规使用,不以破坏他人正当商业模式为手段牟利。
只有让技术在法律法规许可的框架内运行,才能兼顾数据挖掘的效率与开发者自身的人身与财产安全。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















