


除了Selenium,Python还有哪些浏览器自动化库值得尝试?
全面解析除Selenium之外主流的Python浏览器自动化工具,深入对比Playwright、DrissionPage、Pyppeteer与MechanicalSoup的底层通信架构、适用场景、实战代码与选型指南。
一、为什么很多场景下不再首选 Selenium?
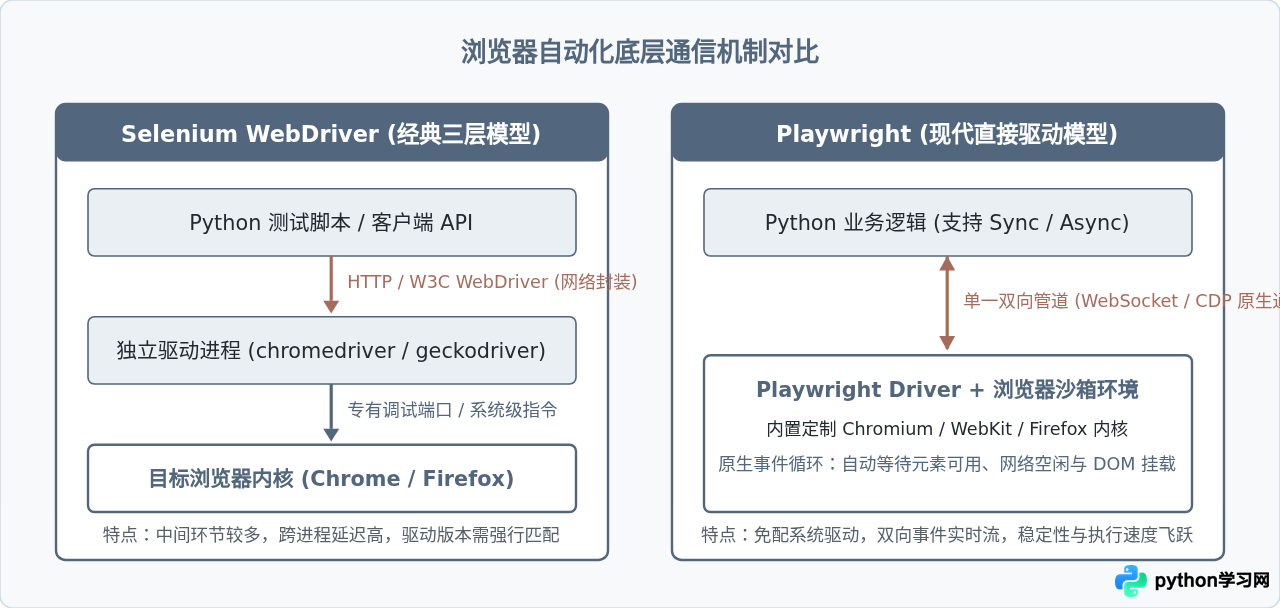
要评估替代方案的优势,需要先看清 Selenium 的瓶颈根源。Selenium 诞生于多年前的传统 Web 时代,其核心设计围绕 W3C WebDriver 协议展开。在这种架构下,Python 代码并不是直接操作浏览器,而是作为 HTTP 客户端向独立的驱动程序(如 chromedriver 或 geckodriver)发送指令,驱动程序再解析 HTTP 请求并通过浏览器专有端口进行控制。
这种三层解耦设计在历史上带来了跨平台兼容的优势,但在单页富应用(SPA)盛行的当下暴露了三大典型问题:
- 环境维护成本高: 本地或服务器部署时,必须严格确保本地 Chrome 版本与下载的驱动版本完全兼容,一旦浏览器自动升级,测试与爬虫流程极易中断。
- 等待机制脆弱: 传统的
time.sleep()或基于轮询的显式等待(WebDriverWait)经常引发元素未就绪或过早超时的“偶发性失败”(Flaky Tests),增加调试负担。 - 网络与事件感知能力弱: 传统的 WebDriver 难以原生拦截底层网络流量、无法低开销监听 WebSocket 消息,且浏览器内部会被注入明确的
navigator.webdriver = true标识,容易被现代站点反自动化系统识破。
二、现代浏览器自动化的新标准:Playwright
微软推出的 Playwright 是目前业界公认替代 Selenium 的首选方案。它不仅支持 Python,还跨平台支持 Node.js、Java 和 .NET。Playwright 抛弃了传统的 HTTP 中继,直接通过 WebSocket 建立与浏览器内核底层的长连接通道,实现接近原生性能的操作响应。
Playwright 的核心优势
- 真正的自动等待(Auto-waiting): 执行点击、输入等操作前,框架会自动检测元素是否可见、是否稳定未发生动画位移、是否处于可交互状态。开发者几乎无需再编写显式等待代码。
- 轻量多上下文隔离(BrowserContext): 启动一个单例浏览器实例后,可以在毫秒级创建多个完全隔离的上下文环境(拥有各自独立的 Cookies、Local Storage 与缓存),极大地降低了多账号并发测试或抓取的内存损耗。
- 网络拦截与路由控制(Network Interception): 能够非常轻松地拦截图片、CSS、字体加载以提升速度,或者直接 Mock 接口返回数据,满足苛刻的测试场景。
- 强大的辅助工具链: 内置
codegen代码录制器、Trace Viewer可视化全链路追踪回放器,大幅缩短脚本开发周期。
Playwright 基础使用示例
Playwright 提供了同步(Sync)与异步(Async)两套 API。以下为同步模式下的典型流程:
from playwright.sync_api import sync_playwright

def run():
    with sync_playwright() as p:
        # 启动 Chromium 内核,headless=False 为显示界面模式
        browser = p.chromium.launch(headless=False)
        # 创建独立的会话上下文
        context = browser.new_context(viewport={"width": 1280, "height": 720})
        page = context.new_page()

        # 导航并自动等待网络空闲
        page.goto("https://httpbin.org/forms/post")

        # 元素交互:Playwright 会自动执行可点击与可输入检测
        page.fill('input[name="custname"]', "自动化测试团队")
        page.check('input[value="cheese"]')
        page.select_option('select[name="size"]', "medium")

        # 点击提交并保存当前页面截图
        page.click('button')
        page.screenshot(path="submit_result.png")

        # 关闭会话与浏览器
        context.close()
        browser.close()

if __name__ == "__main__":
run()from playwright.async_api import async_playwright,语法逻辑完全一致,仅需在操作前添加 await。
三、爬虫与混合控制利器:DrissionPage
如果说 Playwright 是面向专业软件测试与工程化的标杆,那么 DrissionPage 则是在国内 Python 爬虫界极具人气的“实战利器”。许多开发者在抓取数据时面临一个两难困境:用 requests 效率极高但搞不定 JavaScript 动态渲染;用 Selenium 可以渲染页面但速度奇慢、资源消耗大且特征过于明显。
DrissionPage 的核心创新在于动静结合(Driver + Session)。它把 Chromium 浏览器控制(基于 CDP 协议)与纯 HTTP 请求(基于 Session)深度封装到同一套面向对象的 API 之下,允许开发者在二者之间无缝切换。
DrissionPage 的关键特性
- 双模式平滑切换: 当页面仅需基础接口或静态源码时,使用
SessionPage秒级获取;一旦遇到加密签名、滑块验证码或复杂动态渲染时,调用change_mode()瞬间切换为浏览器模式。 - 天然规避 WebDriver 检测: DrissionPage 底层不依赖任何第三方驱动程序,直接通过调试端口控制浏览器,并且在底层重构了注入脚本,规避了大量常规的反爬检测点。
- 极度人性化的查找语法: 无需编写冗长繁琐的 XPath 或 CSS 选择器,支持通过
@text:关键字、@class:类名、相对位置(parent()、next())等极其直观的方式定位元素。
from DrissionPage import ChromiumPage

# 启动默认浏览器页面,无需单独下载驱动二进制
page = ChromiumPage()

# 打开目标地址
page.get('https://httpbin.org/get')

# 极简定位:查找包含特定文本的元素
info = page.ele('tag:pre').text
print("响应内容:", info)

# 关闭页面
page.quit()
四、其他备选库:Pyppeteer 与 MechanicalSoup
除了 Playwright 与 DrissionPage 这两位主力选手,还有两款在特定垂直场景下值得了解的替代方案:
1. Pyppeteer:Node.js Puppeteer 的 Python 移植版
Puppeteer 是 Google Chrome 团队官方维护的 Node.js 库,而 Pyppeteer 是其非官方 Python 移植版本。它同样通过 CDP(Chrome DevTools Protocol)直接与 Chromium 通信,天然支持 asyncio 异步编程模型。如果团队成员拥有深厚的 Node.js Puppeteer 使用经验,切换到 Pyppeteer 会感到非常熟悉。但需要注意的是,Pyppeteer 社区版本的更新频率相对放缓,目前若非维护存量项目,新项目通常更建议优先选用 Playwright。
2. MechanicalSoup:极低资源开销的无头交互
在某些资源受限的微型服务或 Docker 容器内,服务器可能根本无法承受运行 Chromium 内核所需的内存(通常需要数百 MB 甚至上 GB)。如果你的目标网站不需要运行客户端 JavaScript,仅需处理 Session 维持、表单填写、CSRF Token 提取和多页跳转,那么 MechanicalSoup 是绝佳选择。
它在底层将 requests(处理网络通信)与 BeautifulSoup(解析与填充表单)无缝融合,提供类似真机浏览器的 follow_link() 和 submit_form() 操作,但整个运行过程只需要几十 KB 内存,完全不依赖图形或浏览器进程。
五、Playwright 工程化快速上手与实施路径
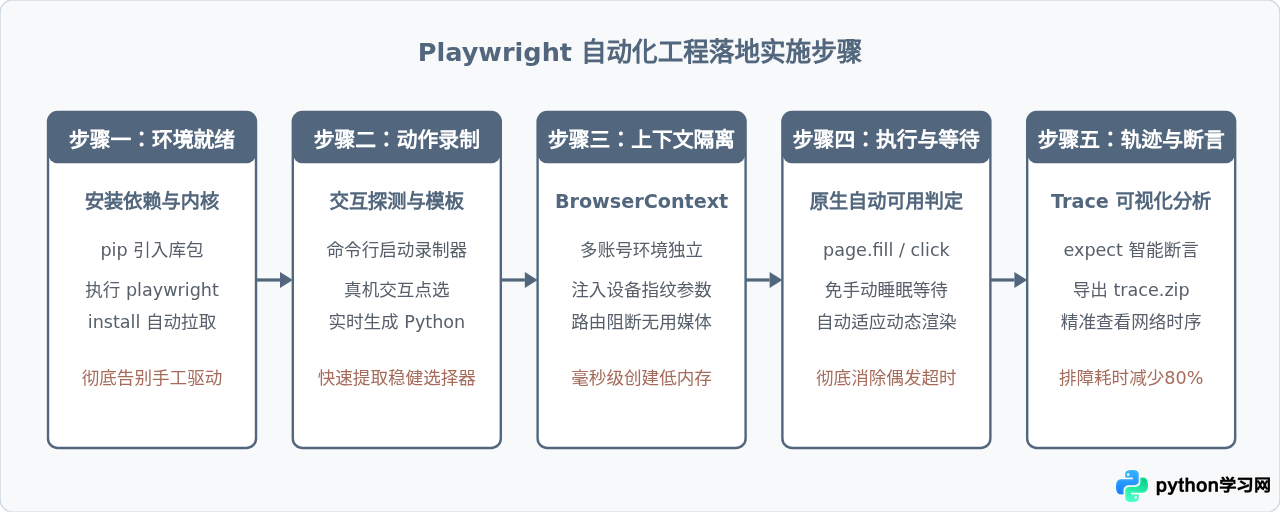
为了让读者在实际项目中平滑迁移,下面给出以 Playwright 为代表的现代化自动化实施标准流程:
-
安装与内核拉取:
终端运行
pip install playwright之后,只需执行一次playwright install,它便会自动从官方 CDN 下载预编译、兼容且与库版本严格绑定的无头浏览器,从此不需要在主机中搜索与升级 chromedriver。 -
高效录制脚本:
运行
playwright codegen https://example.com会弹出一个交互式浏览器和代码监视窗口。你在页面上的每一次点击、键盘输入都会被自动转换成语法规范的 Python 代码,并自动挑选稳定性最好的选择器(优先基于 Role、Label 或 Text 定位,而非易变的层叠选择器)。 -
开启 Trace 诊断:
在无头(Headless)生产环境中,如果某一步偶发失败,调试往往非常痛苦。Playwright 允许开启
context.tracing.start(screenshots=True, snapshots=True, sources=True),任务结束后生成 trace 文件,通过浏览器直观回放失败发生瞬间的 DOM 快照、网络请求与控制台日志。
六、技术选型决策树与多维度对比
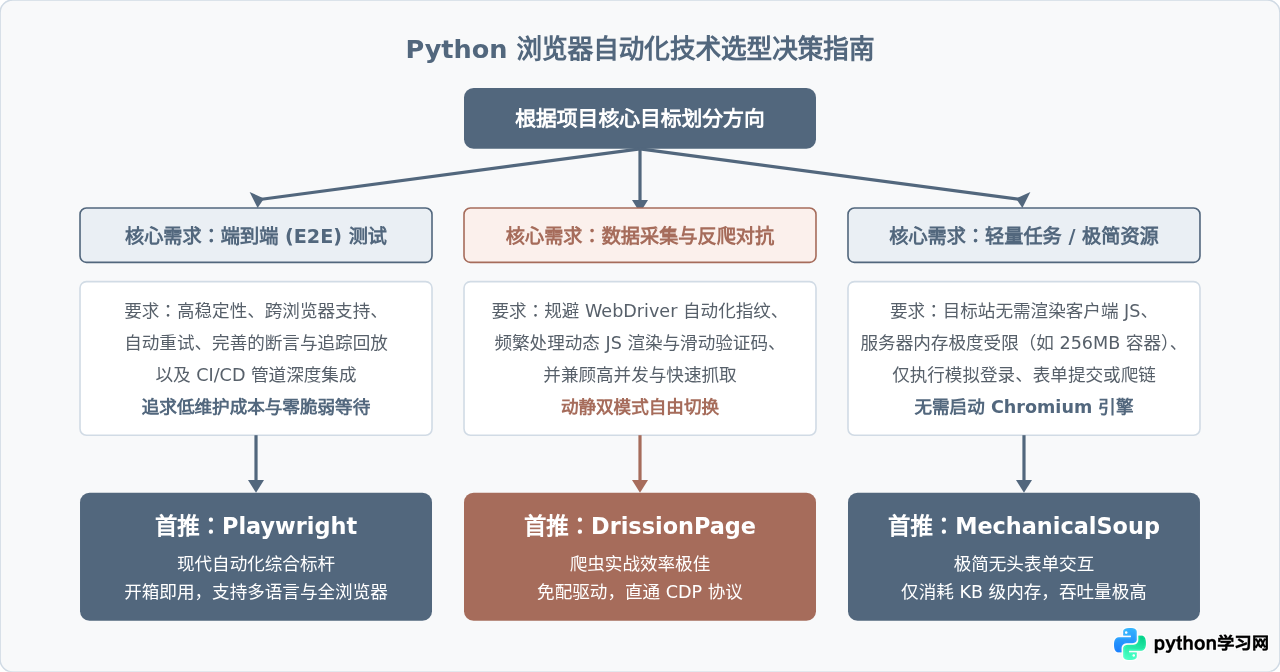
面对多个可选项,如何为当前业务或个人项目选择最合适的库?以下决策树从项目核心目标(测试稳定性、爬虫采集速度、反爬对抗程度、服务器资源成本)给出了明确路径:
核心技术指标横向对比
为了给技术团队评估迁移收益提供客观依据,我们将四个主要工具的关键能力汇总如下:
| 对比维度 | Selenium | Playwright | DrissionPage | MechanicalSoup |
|---|---|---|---|---|
| 底层通信协议 | HTTP (W3C WebDriver) | WebSocket 原生事件通道 | CDP 直接调试 + Requests | 纯 HTTP (Requests 封装) |
| 驱动依赖 | 必须下载对应版本的驱动文件 | 自带免配预编译内核 | 调用系统 Chrome,免下载驱动 | 无浏览器依赖,纯 Python 库 |
| 自动等待机制 | 弱(需显式/隐式等待代码) | 强(内置全维度可用性检测) | 中等(内置智能重试与等待) | 无需等待(同步单次网络响应) |
| 跨浏览器支持 | Chrome, Firefox, Safari, Edge | Chromium, WebKit, Firefox | 仅限 Chromium 系列内核 | 不适用(无真实渲染内核) |
| 网络流量拦截 | 较弱(依赖代理扩展如 browsermob) | 原生支持全请求路由与 Mock | 支持数据包监听与拦截 | 基于 Requests 原生钩子 |
| 反爬绕过难度 | 特征明显,需借助额外补丁库 | 默认特征较少,需精细配置 | 针对反爬深度优化,体验佳 | 依赖自建 Headers 与代理池 |
| 主要适用场景 | 存量大型项目的长期维护 | 现代大型自动化测试、复杂 SPA | 数据爬虫、验证码绕过、混合脚本 | 轻量静态表单、极简运维巡检 |
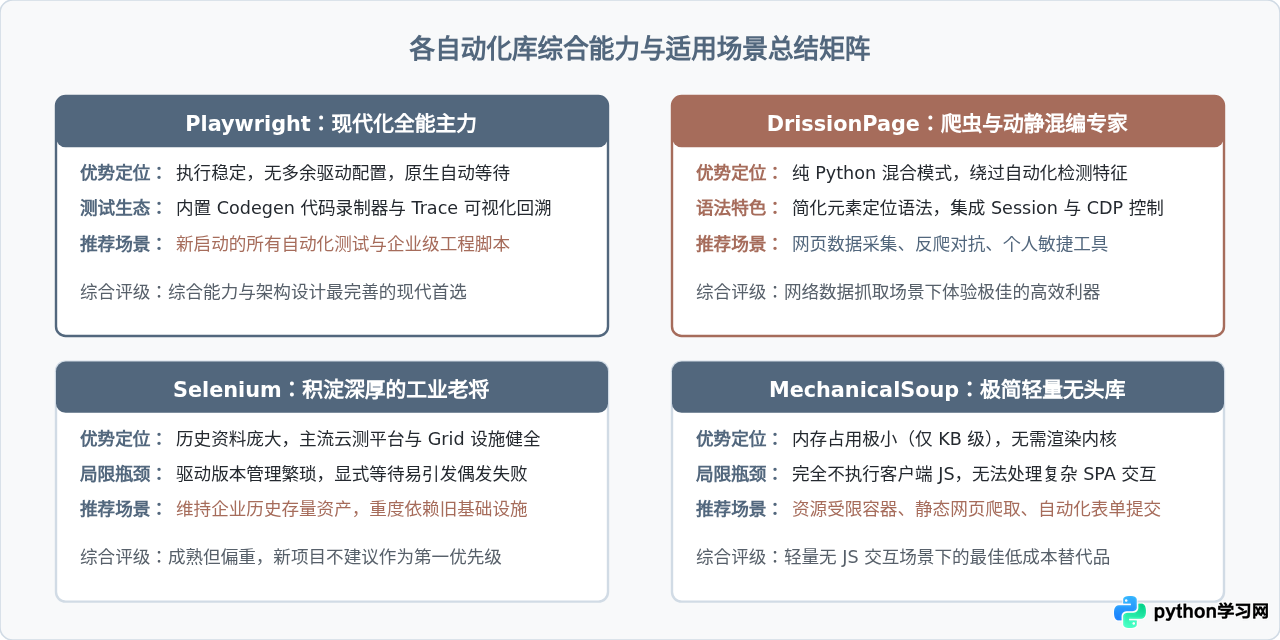
七、总结与落地建议
回到最初的问题:除了 Selenium,Python 还有哪些值得尝试的浏览器自动化库?
答案是非常明确的:如果你正在构建正式的 Web 自动化测试套件、需要健壮的 CI/CD 集成、或者要对现代 Web 应用进行精细的交互与截图,Playwright 是目前最值得投资的现代化首选;如果你主要从事网络爬虫开发、需要频繁绕过浏览器自动化指纹、或是希望在单次请求和界面交互之间来回切换,DrissionPage 会带来极其愉悦的开发体验;而面对无需 JavaScript 参与的静态页面表单与低配服务器,MechanicalSoup 则以极低的成本提供可靠支持。
技术工具的演进始终服务于开发效率。脱离了配置驱动版本的繁琐与偶发等待的困扰,开发者能够将更多精力聚焦于核心业务逻辑与数据价值本身。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















