


Python列表与数组有什么区别?
深入对比Python列表(list)、标准库数组(array)与NumPy数组(ndarray)的核心区别,涵盖底层内存机制、数据类型限制、运算性能及技术选型建议。
在 Python 中,通常所说的“列表”是语言原生内置的 list 类型,它可以存储任意类型的对象且长度动态可变;而“数组”在标准 Python 生态中并非单一的内置类型,通常指标准库提供的 array.array 模块或科学计算生态中的第三方库 numpy.ndarray。两者最根本的区别在于:列表是存放对象指针的通用容器,支持异构数据;数组则是连续内存空间直接存放同质数值的紧凑容器,专为高效数值存储与批量计算而生。
一、初学者的常见困惑与说法辨析
很多初学者接触 Python 时,常常把列表直接叫成“数组”。这种说法看似合理,因为在 C、Java 或 JavaScript 等语言中,用方括号包裹、通过数字索引访问的线性结构通常就叫数组。在 Python 中,列表的写法 [10, 20, 30] 和通过 data[0] 读取元素的形式,与传统数组的使用习惯几乎一模一样。
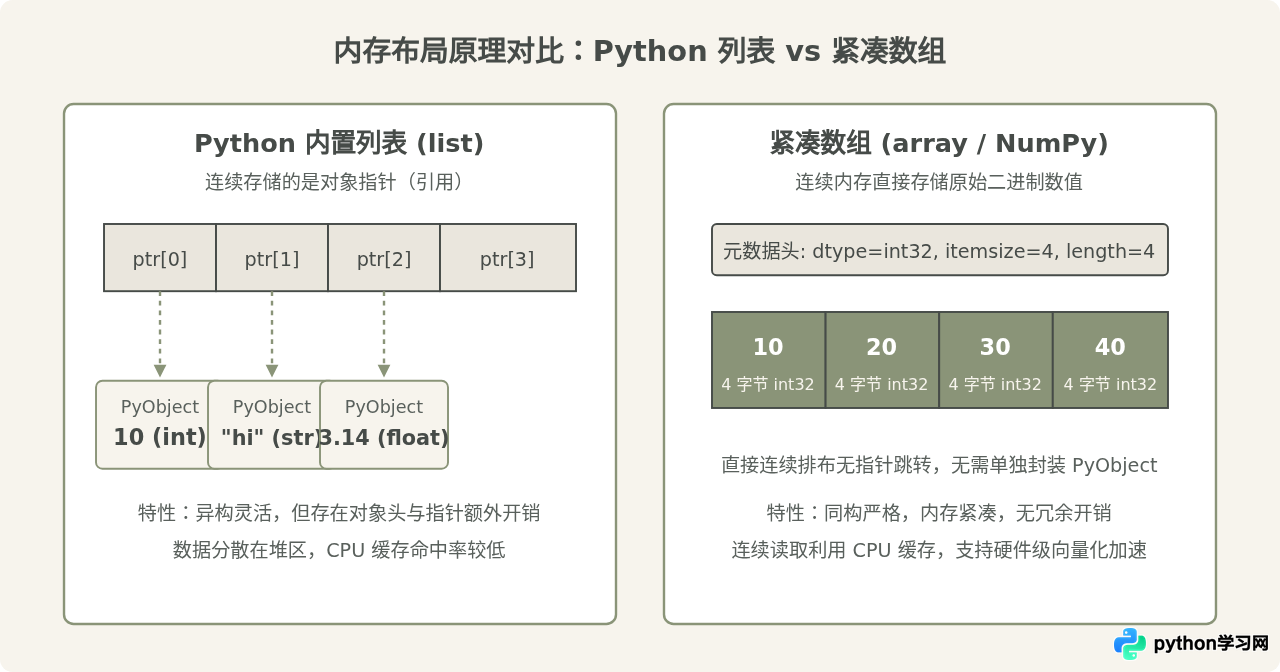
但在 Python 内部机制中,这种等同是不准确的。Python 列表并不直接在连续内存中排布数据本身的原始数值,而是存储指向各个对象的“指针地址”。这就意味着,列表中的第一个元素可以是整数,第二个是字符串,第三个又是一个字典。而传统计算机科学所定义的数组,要求各元素在物理内存中紧密挨着排列,且每一个元素占用的字节大小必须严格一致。
二、核心区别的四大维度解析
1. 数据类型约束:异构 vs 同构
列表是异构容器。这意味着一个列表内可以混杂整数、浮点数、字符串甚至另一个列表。Python 在运行时并不要求列表中元素类型的统一性。
数组是同构容器。无论使用标准库的 array.array 还是 NumPy 的 ndarray,在实例化时都必须指定唯一确定的数据类型(如 32 位整型、64 位双精度浮点等)。如果尝试将不匹配或无法隐式转换的数据写入数组,Python 将直接抛出异常或进行强制类型截断。
2. 内存占用与存储效率
在 Python 中,每一个普通的整数对象(PyLongObject)不仅包含具体的数值,还包含引用计数器、类型指针以及分块分配等头部元数据,单个整数在 64 位系统上至少占用 28 字节。当列表存储 1,000,000 个整数时,内存中需要先存储 100 万个指针(占用 8MB),再加上 100 万个独立整数对象的内存(至少 28MB),总开销超过 36MB。
如果采用 32 位整型紧凑数组存储这 100 万个数字,每个数字仅占用 4 个字节,总共只需要 4MB 的连续内存空间。数组免去了每一个数值的对象头和指针跳转,内存效率提升了将近一个数量级。
3. 数值计算行为与向量化
对于数值批量运算,两者的设计逻辑截然不同:
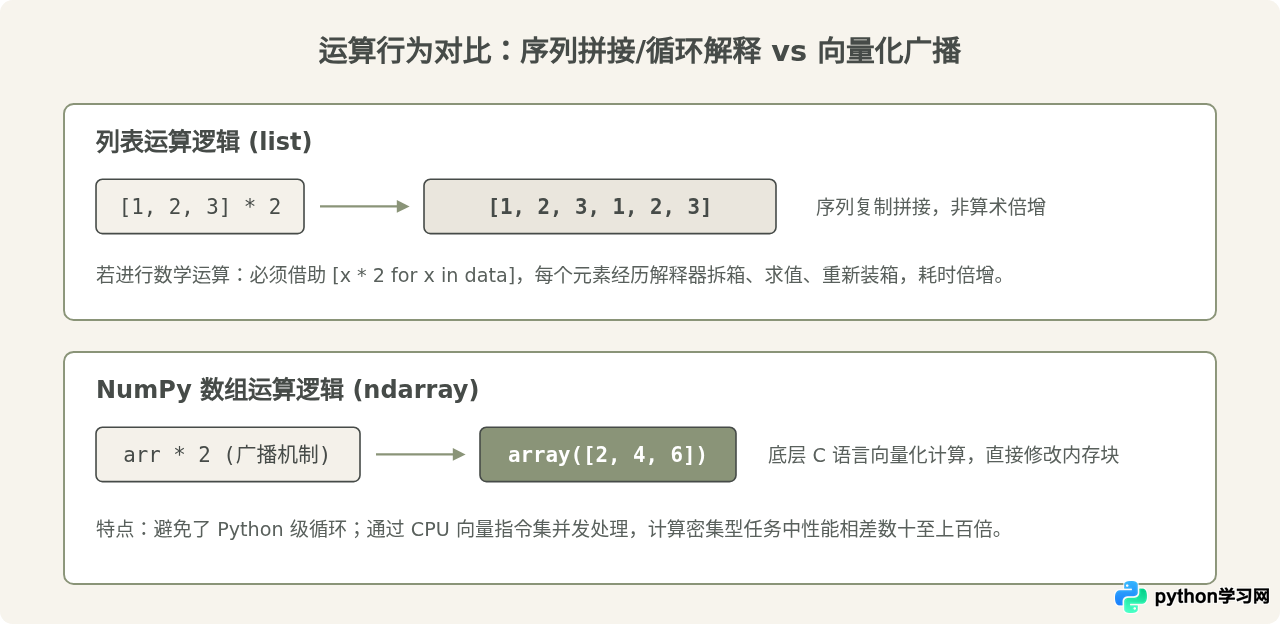
- 列表上的算术运算符偏向序列行为:执行
[1, 2, 3] * 2得到的是[1, 2, 3, 1, 2, 3],即序列内容的复制与拼接,并非数学上的每个数字翻倍;若要进行数学运算,必须通过显式的 Python 循环或列表推导式,由 Python 解释器逐个元素拆包、计算、重新装包,效率较低。 - NumPy 数组支持向量化与广播机制:执行
array * 2时,底层 C/Fortran 引擎直接通过 CPU 的 SIMD(单指令多数据流)指令批量处理内存块,实现无 Python 解释器开销的纯底层高速并行运算。
4. 运行环境与依赖关系
list 是 Python 核心语言内置的原生结构,任何时候无需 import 即可直接声明使用。
若需要紧凑纯数值数组:
- Python 标准库
array模块:无需额外安装依赖,使用import array导入。支持基本的 C 风格基本类型(如'i'、'f'、'd'),适合轻量级的内存节约需求,但没有矩阵运算与多维切片功能。 - 第三方库
numpy:需要执行pip install numpy安装。提供成熟强大的多维数组对象ndarray以及极其庞大的线性代数、傅里叶变换、统计分析函数库,是现代数据科学与机器学习的基础组件。
三、具体代码实现与执行对比
1. 场景一:通用数据混合存储(Python list)
在日常业务开发中,我们经常需要收集属性不同的结构化或非结构化信息,此时列表是最佳选择。
# 环境要求:Python 3.x 标准环境,无需依赖
user_record = ["Alice", 28, 6500.50, True]

# 向末尾动态追加新对象
user_record.append(["reading", "hiking"])

print("列表长度:", len(user_record))
print("第四个元素类型:", type(user_record[3]))
print("全部内容:", user_record)列表长度: 5
第四个元素类型: <class 'bool'>
全部内容: ['Alice', 28, 6500.5, True, ['reading', 'hiking']]2. 场景二:无第三方库的轻量级低内存存储(标准库 array)
当只需要存储上千万个整型或浮点型数据,且环境无法或不允许安装庞大的第三方科学计算库时,标准库的 array 模块可以显著节省内存。
import array

# 'i' 代表有符号 32 位整型 (signed int)
int_array = array.array('i', [10, 20, 30, 40])

# 追加合规整数
int_array.append(50)
print("数组元素:", int_array)

# 尝试插入非指定类型将直接抛出 TypeError
try:
    int_array.append("hello")
except TypeError as err:
print("类型捕获提醒:", err)数组元素: array('i', [10, 20, 30, 40, 50])
类型捕获提醒: 'str' object cannot be interpreted as an integer3. 场景三:高效矩阵运算与科学计算(NumPy ndarray)
面对大规模数据批量运算、多维矩阵转换或数据科学计算时,NumPy 的向量化运算展现出无可替代的性能优势。
# 环境要求:需预先执行 pip install numpy
import numpy as np

# 创建连续存储的单精度或双精度数组
arr_a = np.array([1, 2, 3, 4], dtype=np.int32)
arr_b = np.array([10, 20, 30, 40], dtype=np.int32)

# 向量化加法与乘法运算
sum_result = arr_a + arr_b
scaled_result = arr_a * 5

print("向量相加:", sum_result)
print("标量广播乘法:", scaled_result)
print("数组维度:", arr_a.shape)
print("内存字节跨步:", arr_a.strides)向量相加: [11 22 33 44]
标量广播乘法: [ 5 10 15 20]
数组维度: (4,)
内存字节跨步: (4,)四、选型判断:什么时候用列表?什么时候用数组?
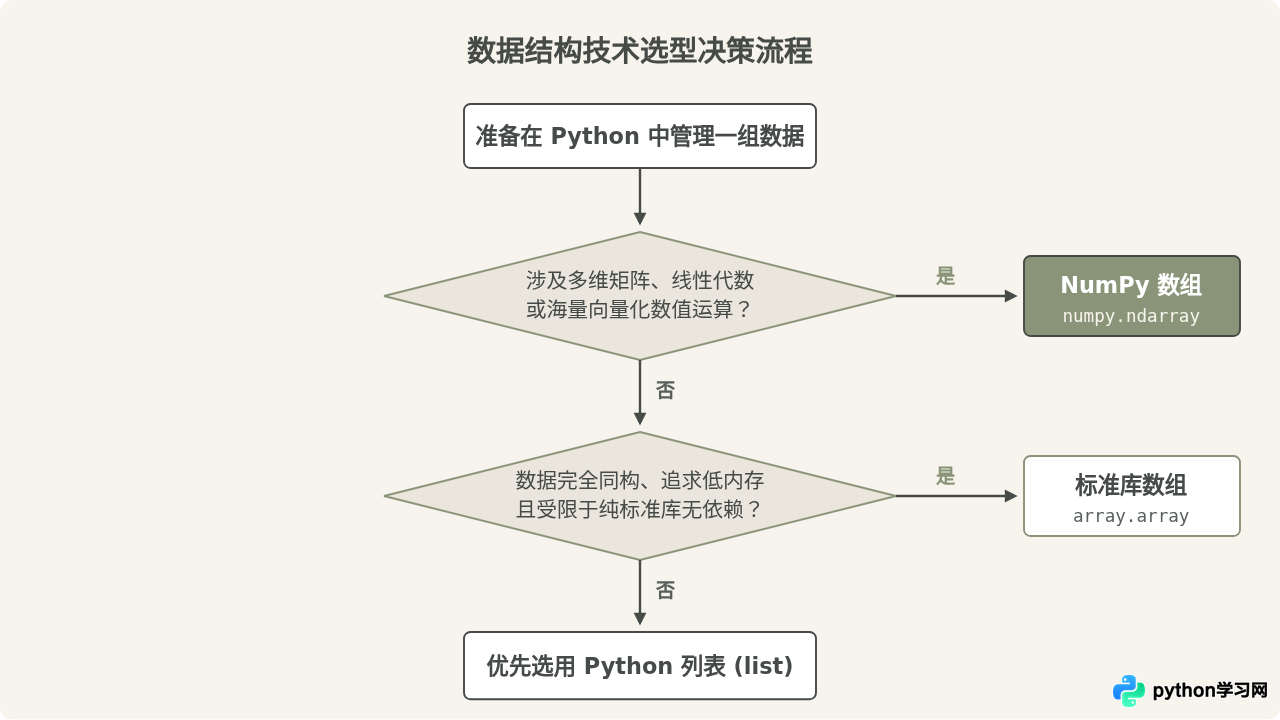
面对具体需求时,不需要盲目追随“数组更快”的结论,而应根据数据形态与操作特点进行选择:
五、常见认知误区与避坑指南
很多初学者会写出在循环中不断对 NumPy 数组调用 np.append() 的代码,结果发现运行速度比原生列表慢了几十倍。原因在于:Python 列表预留了超额容量,list.append() 是分摊 O(1) 的极快操作;而 NumPy 数组的长度在创建后是固定的,每次 np.append() 实际上都会重新申请一块全新内存并拷贝所有历史元素。因此,在需要频繁动态追加单个数字的流式收集场景中,应先用 list 收集,最后一次性调用 np.array() 转换为数组。
对 Python 原生列表进行切片操作(例如 sub_list = my_list[1:4])时,Python 会开辟新内存并创建一个包含对应指针浅拷贝的全新列表,修改 sub_list 不会影响原列表。但对 NumPy 数组切片时,返回的仅仅是原数组的视图(View),修改切片中的数据会直接改变原始数组的数据。若需要独立副本,必须显式调用 .copy()。
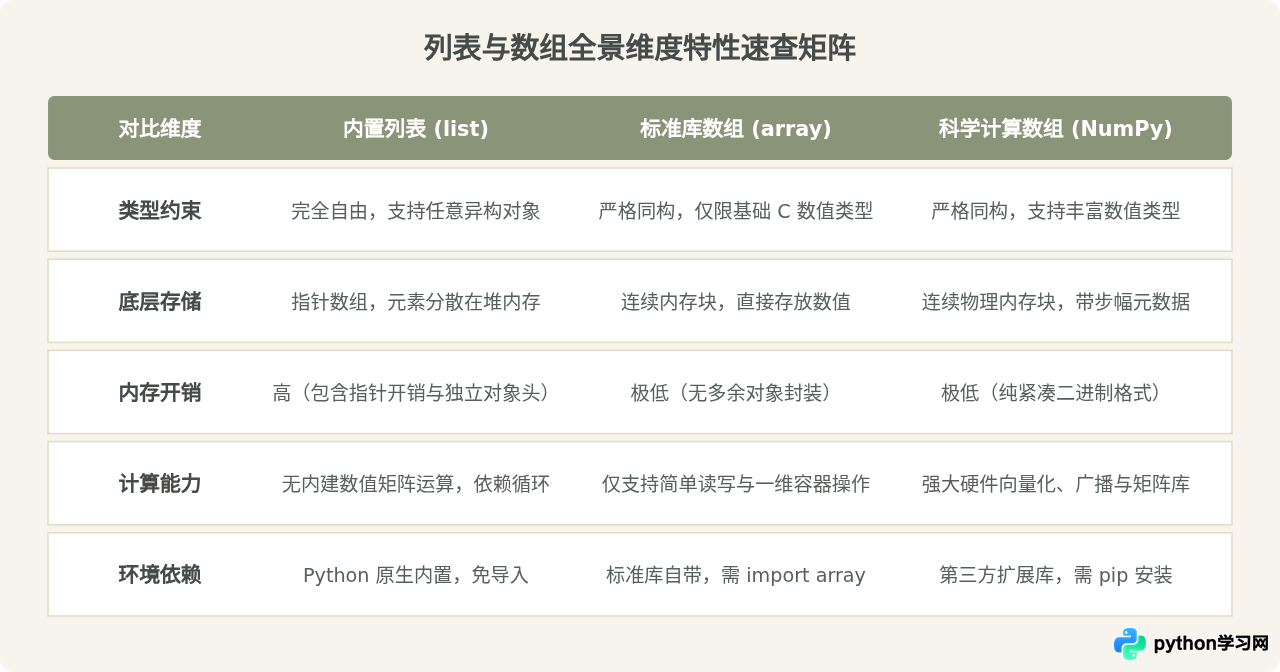
六、全景对比速查表
七、总结
理解 Python 列表与数组的区别,关键在于掌握“通用灵活容器”与“紧凑计算容器”的设计取向:
- 日常软件开发、数据结构组织、灵活对象混合管理,坚决使用 Python 原生列表;
- 无外部依赖限制但需要极度压缩同构数值内存时,使用 标准库
array.array; - 涉及高频科学计算、图像数据、多维矩阵或数据建模任务时,毫无疑问采用 NumPy 数组。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















