


Python自学路线图:从基础语法到项目实战的完整规划
本文梳理一份清晰可执行的Python自学路线图,从环境搭建、基础语法、进阶机制,到工程化实战项目分层开发与方向选择,提供明确的学习步骤与验收标准。
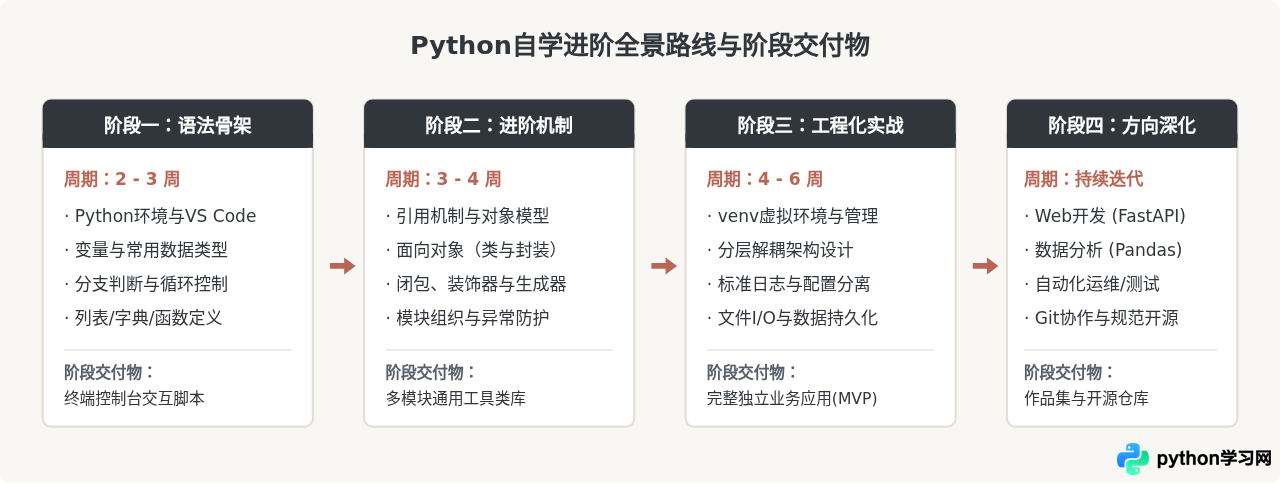
自学Python最常见的失败方式,不是学不会语法,而是在孤立的基础语法练习中反复打转,始终无法独立做出解决实际问题的完整项目。要跨越从“看懂教程代码”到“独立编写项目”的断层,学习者必须遵循清晰的阶段目标、明确的交付物验收标准以及严谨的工程化方法。本文提供一条从零搭建环境、掌握语法骨架、理解底层运行逻辑,直至完成分层工程实战的完整规划路线。
第一阶段:基础语法骨架与环境准备
自学的第一步是建立干净、标准的本地运行环境。初学者切忌一开始就安装过于复杂的商业开发套件或第三方发行版,直接前往Python官方网站下载最新的稳定版(如Python 3.11或3.12版本即可)。编辑器首选轻量且扩展丰富的VS Code,搭配官方Python插件,即可获得代码补全与调试断点功能。
在语法层面,第一阶段的重点在于掌握程序控制的基本逻辑单元,而不是死记硬背所有内置函数:
- 数据类型与变量:熟练掌握整数(int)、浮点数(float)、字符串(str)与布尔值(bool)。理解类型转换规则以及字符串格式化输出(重点掌握f-string用法)。
- 流程控制:掌握
if / elif / else条件分支逻辑,以及for与while循环语句,重点理解break、continue与循环中的边界控制。 - 四种核心数据容器:列表(list,有序可变)、字典(dict,键值对映射)、元组(tuple,有序不可变)与集合(set,去重无序)。熟练进行增删查改和循环遍历。
- 函数基础:掌握函数定义
def、形参与实参传递、默认参数、关键字参数以及return返回机制。
第一阶段验收标准:脱离教程与AI辅助,独立编写一个控制台交互式小工具(例如简易待办事项管理器或学生成绩统计算法)。程序能够接收用户终端输入、根据条件处理字典与列表数据,并在控制台整齐输出运算结果。
第二阶段:核心运行机制与进阶语言特性
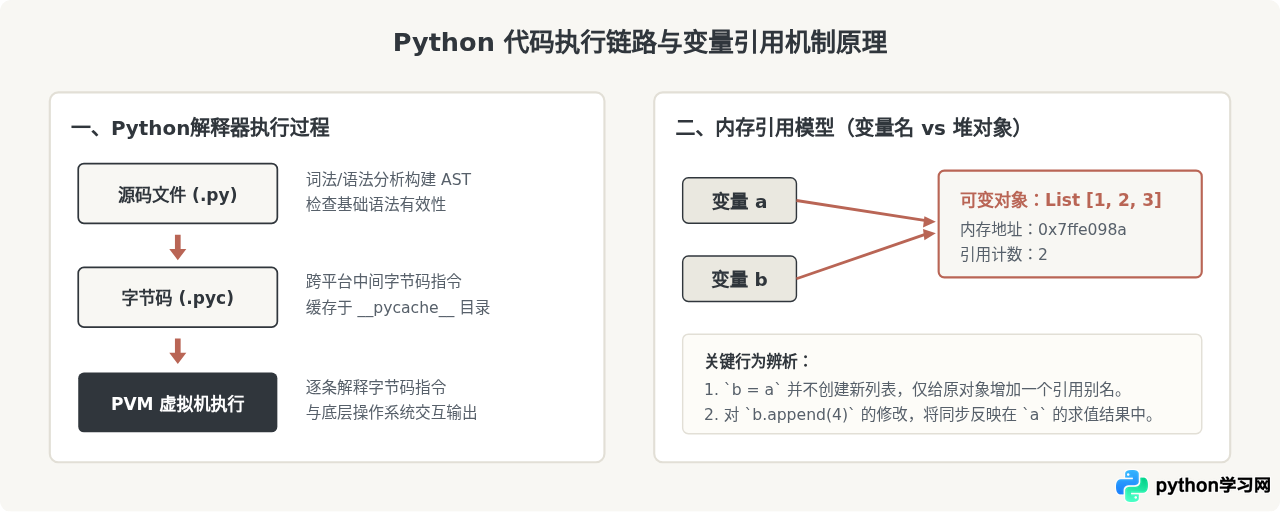
掌握了基本语法之后,很多学习者会遇到瓶颈:能读懂单行代码,但写多模块联动时经常出现意料之外的变量变异或逻辑错误。其根本原因是没有理解 Python 的对象模型与内存运行原理。
1. 变量是标签,对象存在于堆中
在 Python 中,变量并非存储具体值的“盒子”,而是贴在内存对象上的“名字标签”。赋值操作 a = [1, 2] 是在堆内存中创建了一个列表对象,并让名字 a 指向该对象的内存地址。当执行 b = a 时,并没有复制列表内容,而是让 b 引用了同一个对象。理解这一机制是防范可变对象(列表、字典)产生意外修改副作用的关键:
# 引用与浅拷贝的区别示例
original_list = [1, 2, [3, 4]]
reference_list = original_list         # 仅传递引用,指向同一地址
shallow_copy = original_list.copy()    # 复制顶层列表,但内部嵌套对象仍为同一引用

original_list[0] = 99
print(reference_list[0])  # 输出 99(同一对象)
print(shallow_copy[0])    # 输出 1 (顶层未受影响)
2. 面向对象编程与封装
不要在初期就死磕抽象的多重继承或元编程,重点掌握类的核心三要素:通过 __init__ 构造器初始化实例属性、通过实例方法封装行为、使用私有命名约定(单下划线前缀)区分内部状态与对外接口。优先采用“对象组合”而非“深度继承”,这能大幅度降低后续实战代码的耦合度。
3. 进阶核心语法工具
熟练使用列表推导式、生成器表达式与上下文管理器(with 语句)。列表推导式应保持在一层循环和简单过滤条件以内,若逻辑过于复杂则应拆回传统 for 循环以保证可读性。with open(...) as f: 能够确保即使在读取出错时系统文件描述符也能被正确释放。
第三阶段:突破“教程陷阱”,工程化实战五步法
很多自学者学完基础语法后去 GitHub 找开源项目,往往一行行照抄代码,结果是“敲的时候好像全懂,关掉窗口一行写不出”。这种现象被称为“教程陷阱”。要摆脱这一状态,必须采用工程化拆解法,从零构建独立项目。
1. 规范的项目工程目录
一个标准的 Python 实用项目不应只有一个 main.py 堆砌所有代码。建立规范的目录结构是代码解耦的第一步:
project_root/
│
├── .venv/                   # 虚拟环境目录(不提交至代码仓库)
├── config/                  # 配置文件与环境变量
│   └── settings.py
├── data/                    # 本地数据输入与输出存储
├── src/                     # 核心业务源码
│   ├── __init__.py
│   ├── fetcher.py           # 数据采集或数据源接入模块
│   ├── processor.py         # 核心业务逻辑与数据清洗
│   └── storage.py           # 文件持久化或数据库交互
├── tests/                   # 单元测试用例
├── .gitignore               # 过滤临时文件与虚拟环境
├── requirements.txt         # 第三方依赖版本清单
├── main.py                  # 统一调度运行入口
└── README.md                # 项目运行说明文档
2. 实战项目分层解耦五步法
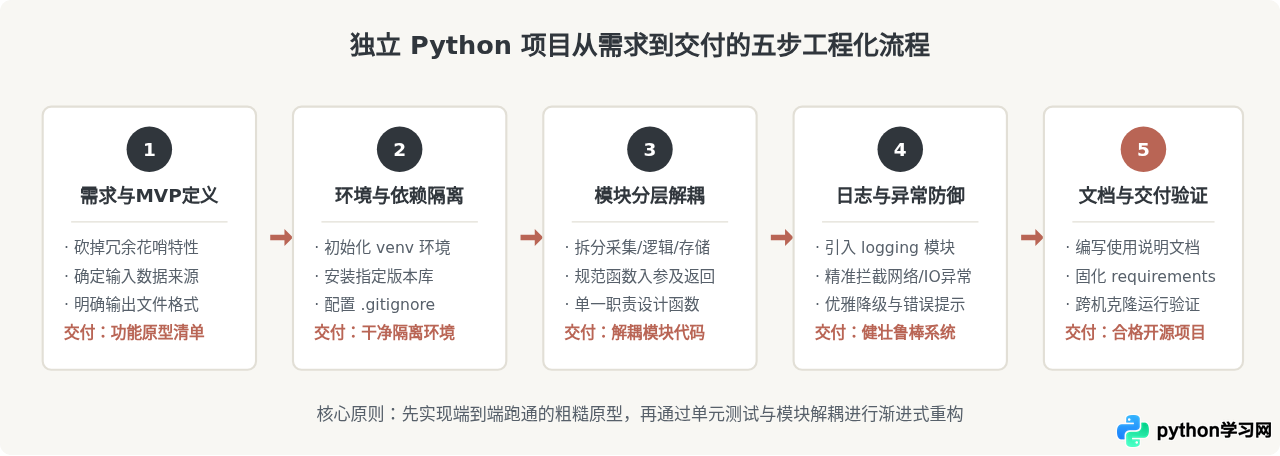
无论开发网页抓取器、数据清洗分析脚本,还是自动化办公小工具,都可以遵循以下标准步骤完成研发:
- 明确最小可行产品(MVP):只设定一个核心功能。例如“抓取某电商页面的商品标题与价格,保存为 CSV 文件”,不要在第一天就设想分布式爬虫或复杂的界面。
- 环境隔离与依赖控制:在项目目录运行
python -m venv .venv创建专属虚拟环境,使用pip install安装第三方库,并使用pip freeze > requirements.txt锁定版本。 - 职责分层编码:将数据获取(fetcher)、数据清洗(processor)、结果导出(storage)分别写在独立文件中,函数间只通过标准数据结构(字典或列表)传递数据。
- 结构化日志与异常防护:杜绝在生产代码中滥用
print(),统一引入logging模块记录 INFO 与 ERROR。在网络请求与文件读写环节使用精细化try-except捕获异常,给出明确排查提示。 - 命令行参数封装与交付验证:使用标准库
argparse接收命令行参数,确保代码在不同参数配置下均可独立复现。
第四阶段:专业方向选择与项目矩阵
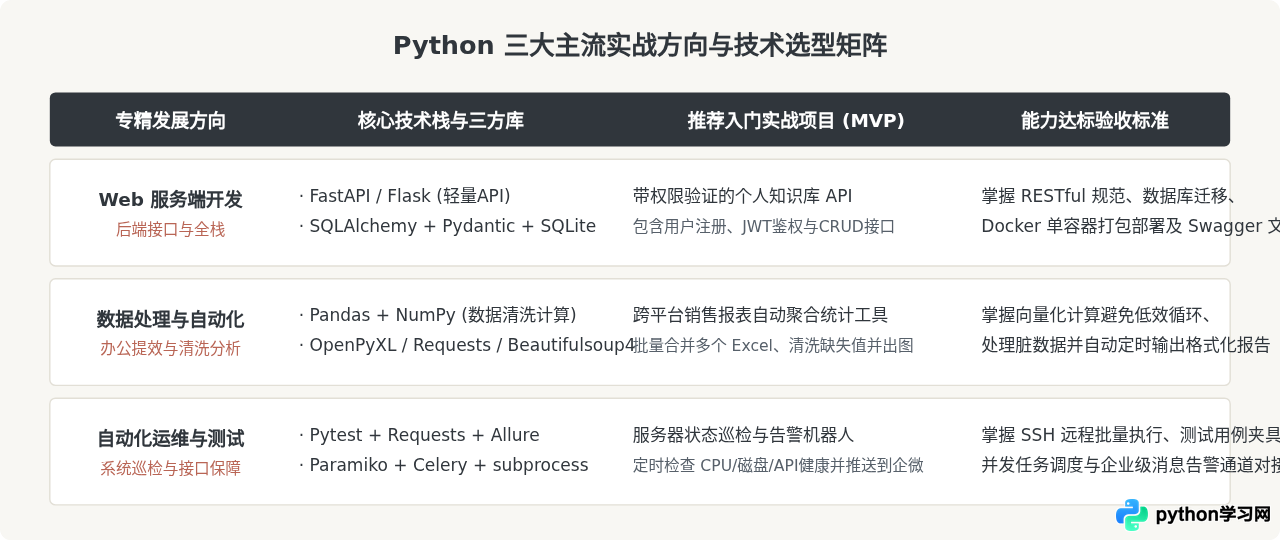
完成通用基础与工程化训练后,学习者不应漫无目的地学习更多零散语法,而应根据自身的职业目标或业务痛点,选择一个特定的应用领域深入突破。不同方向所依赖的第三方生态库与项目复杂度有明显差异:
自学过程中的关键避坑原则
在按照上述四个阶段推进的过程中,学习者若能主动规避以下三个高频误区,可以节约大量无效耗时:
- 严禁“只看视频不动手”:被动观看视频教程会产生“我已经听懂了”的虚假认知。必须坚持“看一段、敲一段、改一段”的原则,尝试修改教程中的参数甚至故意制造异常,观察终端报错。
- 学会阅读 Traceback 报错调用栈:初学者遇到报错往往第一反应是慌张,甚至立刻把整段代码扔给搜索工具。其实 Python 的报错信息极度友好,直接看输出的最后一行(异常类型与描述),倒数第二行通常就是引发错误的具体文件名和行号。养成从下往上看调用栈的习惯,80% 的初级 Bug 都能在两分钟内定位。
- 尽早建立版本管理习惯:进入实战阶段后,必须使用 Git 管理代码。每一次完整功能的添加都提交一个 Commit,写清 Commit Message。这不仅能避免代码改崩后无法回滚,更是日后求职或展示成果时最真实、最具说服力的工程能力证明。
掌握 Python 并不需要通读厚重的大部头字典,也不需要死记每一个不常用的冷门模块。按照“搭建骨架 -> 掌握机制 -> 工程解耦 -> 方向深耕”的节奏,以最终交付可用作品为导向,任何自学者都能踏实完成从语法新手到合格开发者的进阶。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















