


Python scipy非参数检验结果解读:统计量、p值与效应量计算
深入讲解如何使用Python scipy.stats进行非参数检验,详细解读统计量、p值统计学意义,并提供效应量(r、η²)计算代码与规范汇报指南。
在数据分析与实验评估中,当数据不满足正态分布或样本量较小时,参数检验(如t检验、ANOVA)的结论往往不再可靠。Python 中的 scipy.stats 模块提供了丰富的非参数检验函数,但其默认输出仅包含统计量和 p 值,既没有自动汇报分布形状,也缺少衡量实际差异大小的效应量。本文直接面向实际应用,系统讲解常用非参数检验的选择依据、scipy 输出结果中统计量与 p 值的统计学含义,并给出计算效应量(Effect Size)的完整代码与规范汇报方式。
一、非参数检验适用场景与方法选型
非参数检验(Non-parametric Tests)不依赖总体服从特定分布(如正态分布)的假定,通常基于样本数据的“秩次”(Ranks)进行推断。当遇到严重偏态数据、等级有序数据(如李克特五级量表)或小样本极端值时,非参数检验是保持统计推断稳健性的首选方案。
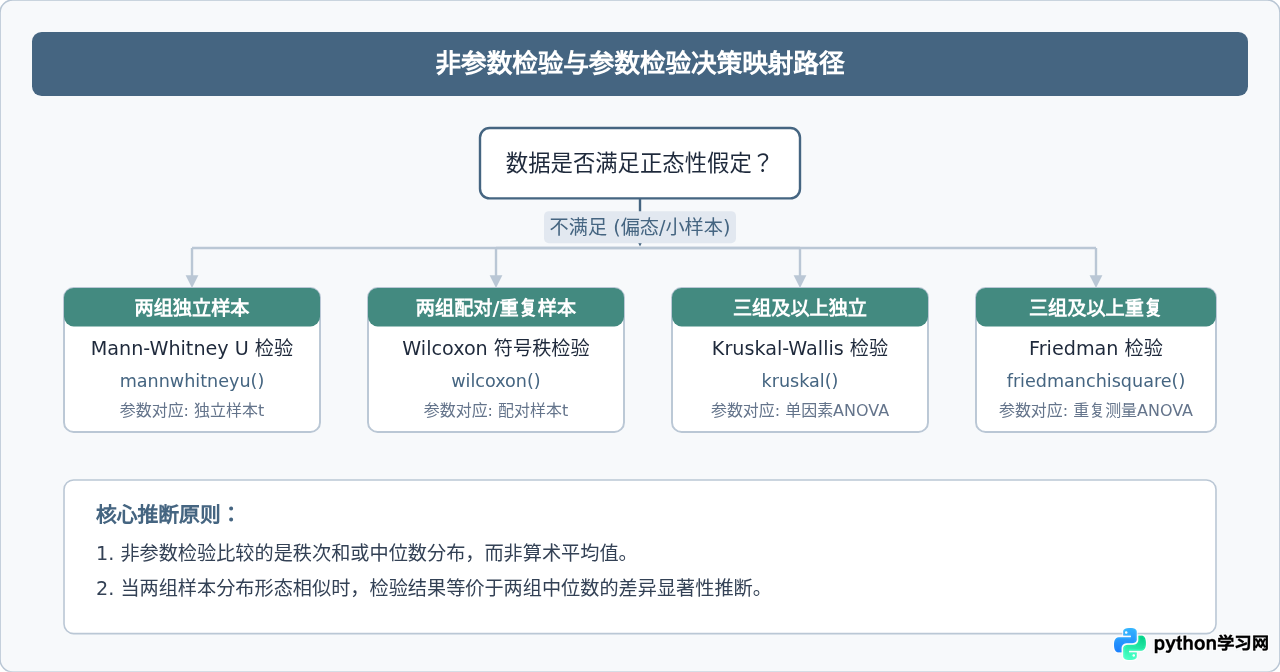
在选择具体方法时,核心依据包括样本组数(两组或多组)以及样本设计类型(独立样本还是配对样本)。下表梳理了常见非参数检验与其对应的参数检验关系:
| 数据设计场景 | 参数检验(对比基准) | 非参数检验方法 | scipy.stats 对应函数 |
|---|---|---|---|
| 两个独立样本 | 独立样本 t 检验 | Mann-Whitney U 检验(曼-惠特尼) | mannwhitneyu(x, y) |
| 两个配对样本 | 配对样本 t 检验 | Wilcoxon 符号秩检验 | wilcoxon(x, y) |
| 三组及以上独立样本 | 单因素方差分析(One-way ANOVA) | Kruskal-Wallis H 检验 | kruskal(*samples) |
| 三组及以上重复测量 | 重复测量方差分析 | Friedman 检验 | friedmanchisquare(*samples) |
二、标准操作流程与 scipy 代码实现
一次规范的非参数检验不应仅停留在调用单个函数,而应遵循涵盖数据准备、假设检验、结果提取与效应量计算的标准分析流。
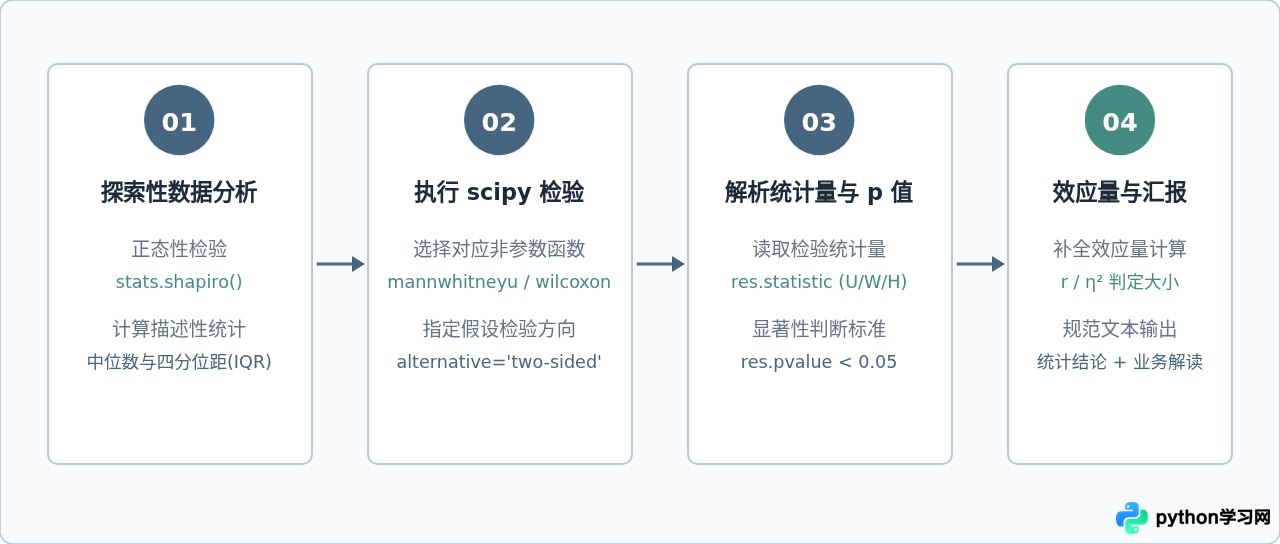
下面给出完整的 Python 代码示例,展示如何生成偏态模拟数据,并使用 scipy.stats 执行 Mann-Whitney U 检验与 Wilcoxon 符号秩检验:
import numpy as np
from scipy import stats

# 1. 模拟生成两组偏态数据(例如某网站A/B版本用户的页面停留时间,单位:秒)
np.random.seed(42)
group_a = np.random.exponential(scale=30.0, size=50)  # 指数分布,强偏态
group_b = np.random.exponential(scale=45.0, size=55)  # 试验组,均值更高

# 2. 检查正态性(Shapiro-Wilk检验)
p_a = stats.shapiro(group_a).pvalue
p_b = stats.shapiro(group_b).pvalue
print(f"Group A 正态性检验 p-value: {p_a:.4e} (p < 0.05 表明偏离正态)")
print(f"Group B 正态性检验 p-value: {p_b:.4e}")

# 3. 执行独立两样本非参数检验:Mann-Whitney U 检验
# alternative 可选 'two-sided', 'less', 'greater',默认为 'two-sided'
u_res = stats.mannwhitneyu(group_a, group_b, alternative='two-sided')
print("\n--- Mann-Whitney U 检验输出 ---")
print(f"检验统计量 (Statistic U): {u_res.statistic:.2f}")
print(f"显著性 p 值 (p-value):    {u_res.pvalue:.4e}")

# 4. 执行配对非参数检验:Wilcoxon 符号秩检验
# 模拟配对样本(如同一批用户优化前后的操作耗时)
before = np.random.exponential(scale=60.0, size=40)
after = before - np.random.normal(loc=8.0, scale=4.0, size=40)

w_res = stats.wilcoxon(before, after, alternative='two-sided')
print("\n--- Wilcoxon 符号秩检验输出 ---")
print(f"检验统计量 (Statistic W): {w_res.statistic:.2f}")
print(f"显著性 p 值 (p-value):    {w_res.pvalue:.4e}")
三、统计量与 p 值的统计学含义与解读
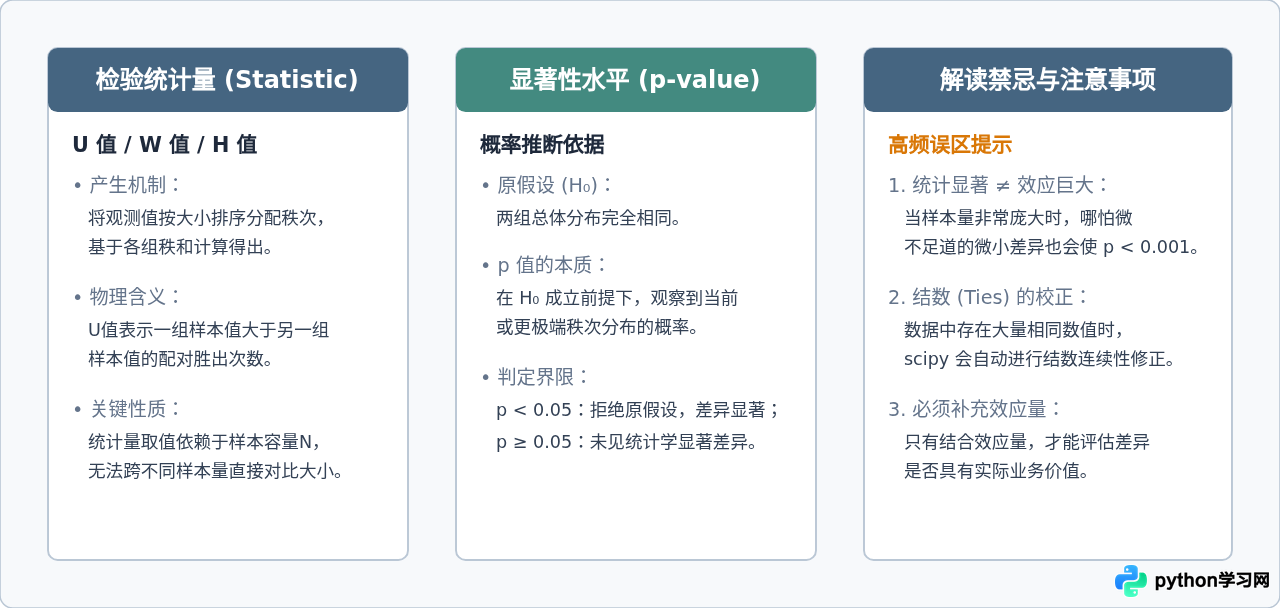
scipy.stats 返回的对象通常包含两个核心属性:statistic 和 pvalue。正确理解这两个数值是得出严谨结论的前提。
1. 统计量(Statistic)的具体含义
- Mann-Whitney U 统计量:代表两组数据相互配对比较时,第一组样本大于第二组样本的次数总和(并计入平局赋予的0.5)。两组各自的 U 值满足关系式:
U1 + U2 = n1 * n2。在 scipy 的较新版本中,默认返回的是较小的 U 值或指定假设方向下的 U 值。 - Wilcoxon 符号秩检验 W 统计量:代表配对差值中正差(或负差)所对应的秩次和。如果两组没有差异,正负秩次和应当大致相等。
- Kruskal-Wallis H 统计量:类似于方差分析中的 F 比率,它衡量各组平均秩次偏离总体平均秩次的加权方差,在大样本下近似服从自由度为
k - 1的卡方分布。
2. p 值的判断标准与单双侧选择
默认情况下,应始终指定 alternative='two-sided' 进行双侧检验,除非在实验设计阶段已有充分理论支持预先确立单向假设(如改版后耗时必然缩短):
alternative='two-sided':检验两组总体的分布是否存在差异。alternative='greater':检验第一组的取值倾向于大于第二组(随机优势)。alternative='less':检验第一组的取值倾向于小于第二组。
四、效应量(Effect Size)计算与 Python 实现
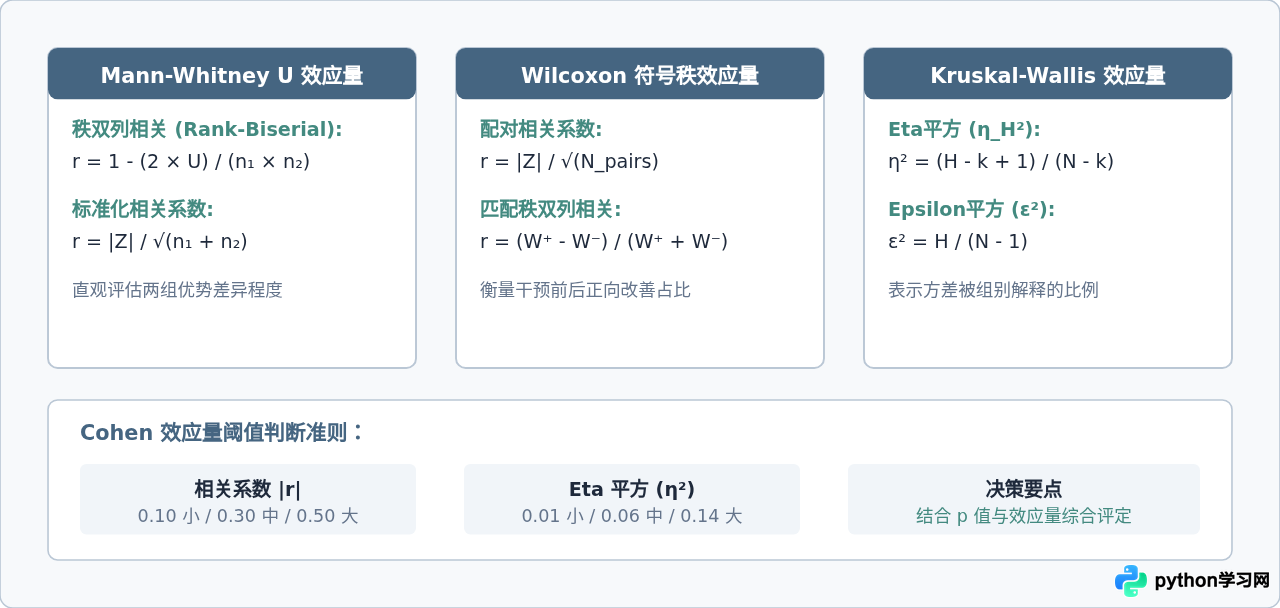
由于 p 值严重受到样本量 $N$ 的影响,仅报告 p 值并不完整。效应量是一个与样本容量解耦的无量纲指标,用于量化差异的实际强度。针对非参数检验,常用的效应量包括:
- 秩双列相关系数(Rank-Biserial Correlation, $r_{rb}$):主要用于 Mann-Whitney U 检验,衡量两组比较时的优势优势差。计算公式为:
r_{rb} = 1 - (2 * U) / (n1 * n2),取值范围在 -1 到 1 之间。 - 标准化效应量($r$):利用标准正态渐近分布的 $Z$ 统计量与总样本量 $N$ 计算:
r = |Z| / sqrt(N),适用于 Mann-Whitney U 与 Wilcoxon 符号秩检验。 - Epsilon 平方($\epsilon^2$)或 Eta 平方($\eta_H^2$):用于 Kruskal-Wallis 检验,反映组间因素解释的秩次方差百分比:
\eta_H^2 = (H - k + 1) / (N - k),其中 $H$ 为统计量,$k$ 为组数,$N$ 为总样本量。
效应量计算的通用 Python 函数
为便于在工程中直接复用,以下编写了一套涵盖 Mann-Whitney U 与 Kruskal-Wallis 检验的效应量自动化计算工具函数:
import numpy as np
from scipy import stats

def calc_mannwhitney_effect_size(group1, group2):
    """
    计算 Mann-Whitney U 检验的统计量、p值及效应量 (r 与 rank-biserial)
    """
    n1 = len(group1)
    n2 = len(group2)
    res = stats.mannwhitneyu(group1, group2, alternative='two-sided')
    u_stat = res.statistic
    p_val = res.pvalue

    # 计算秩双列相关系数 (Rank-Biserial Correlation)
    r_rb = 1.0 - (2.0 * u_stat) / (n1 * n2)

    # 基于 p 值反推渐近标准正态分位数 Z (双侧)
    # 当样本量较大时,可通过 scipy.stats.norm.ppf 精确近似
    z_score = stats.norm.ppf(1.0 - p_val / 2.0)
    r_z = z_score / np.sqrt(n1 + n2)

    # 评定大小级别
    abs_r = abs(r_z)
    if abs_r < 0.3:
        level = "小效应 (Small)"
    elif abs_r < 0.5:
        level = "中等效应 (Medium)"
    else:
        level = "大效应 (Large)"

    return {
        "statistic_U": u_stat,
        "p_value": p_val,
        "rank_biserial_r": r_rb,
        "r_z": r_z,
        "effect_level": level
    }

def calc_kruskal_effect_size(*groups):
    """
    计算 Kruskal-Wallis H 检验的统计量、p值及 Eta平方 (η²)
    """
    k = len(groups)
    n_total = sum(len(g) for g in groups)
    res = stats.kruskal(*groups)
    h_stat = res.statistic
    p_val = res.pvalue

    # 计算 eta_squared_H
    eta_sq = (h_stat - k + 1) / (n_total - k)
    eta_sq = max(0.0, min(1.0, eta_sq))  # 截断在 0~1 之间

    if eta_sq < 0.06:
        level = "小效应 (Small)"
    elif eta_sq < 0.14:
        level = "中等效应 (Medium)"
    else:
        level = "大效应 (Large)"

    return {
        "statistic_H": h_stat,
        "p_value": p_val,
        "eta_squared": eta_sq,
        "effect_level": level
    }

# 测试调用
sample_a = [12, 15, 18, 22, 29, 35, 41]
sample_b = [25, 29, 38, 42, 51, 65, 78]
report = calc_mannwhitney_effect_size(sample_a, sample_b)

print("--- Mann-Whitney 效应量计算结果 ---")
for k, v in report.items():
    if isinstance(v, float):
        print(f"{k}: {v:.4f}")
    else:
        print(f"{k}: {v}")
五、规范汇报格式与关键注意事项
在向团队或学术期刊汇报非参数检验结果时,应避免只写一句“两组差异具有显著性(p < 0.05)”。标准的汇报规范要求同时列出描述性统计指标(中位数与四分位距 IQR)、检验统计量及自由度、精确 p 值以及效应量大小。
标准汇报模版示例:
针对方案 A(中位数 = 22.0 秒, IQR = 13.5)与方案 B(中位数 = 42.0 秒, IQR = 26.0)的用户停留时长进行了 Mann-Whitney U 检验。结果显示,方案 B 的停留时长显著高于方案 A(U = 6.00, p = 0.0175),且效应量达到较大水平(r = 0.63, rrb = 0.755),表明改版方案对提升用户参与度具有实质性影响。
常见误区提醒:
1. 不要汇报均值与标准差:偏态数据下,均值容易受到极值拉扯失去代表性,必须汇报中位数(Median)与四分位距(IQR, 25%分位数到75%分位数)。
2. 注意数据中存在结数(Tied Ranks):若数据包含大量重复值,统计量方差需要调整,scipy 内部已自动处理结数修正,但过度离散或类别过少的数据建议改用精确置换检验或卡方检验。
3. 警惕大样本下的“伪显著”:当样本量达数十万时,哪怕中位数仅相差 0.001,p 值也会高度显著(p < 0.0001)。此时必须以效应量(r 或 η²)作为决策核心,防止将无业务意义的细微扰动误判为有效突破。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















