


Python处理GB级大文件词频统计的内存优化方案
在Python中处理体积达数十吉字节(GB)的文本文件并进行词频统计时,最常遭遇的技术瓶颈是物理内存耗尽(OOM)。当文件体量超过机器物理RAM,任何将全文一次性读入内存的常规操作都会导致进程被操作系统强行终止;即使采用逐行读取降低输入开销,如果文件中存在海量不重复词汇,存储键值对的哈希字典本身也会迅速膨胀直至压垮内存。解决这一问题的核心路径分为两层:一是构建基于生成器与受控缓冲区的流式分块读取管道,彻底解除文件体积对内存的绑定;二是结合内存阈值监控与外部多路归并(External Merge Sort),将超量统计分批溢写至磁盘临时文件并完成有序合并,从而在512MB以内的固定内存限制下稳定处理任意规模的数据。
一、内存溢出的根源剖析
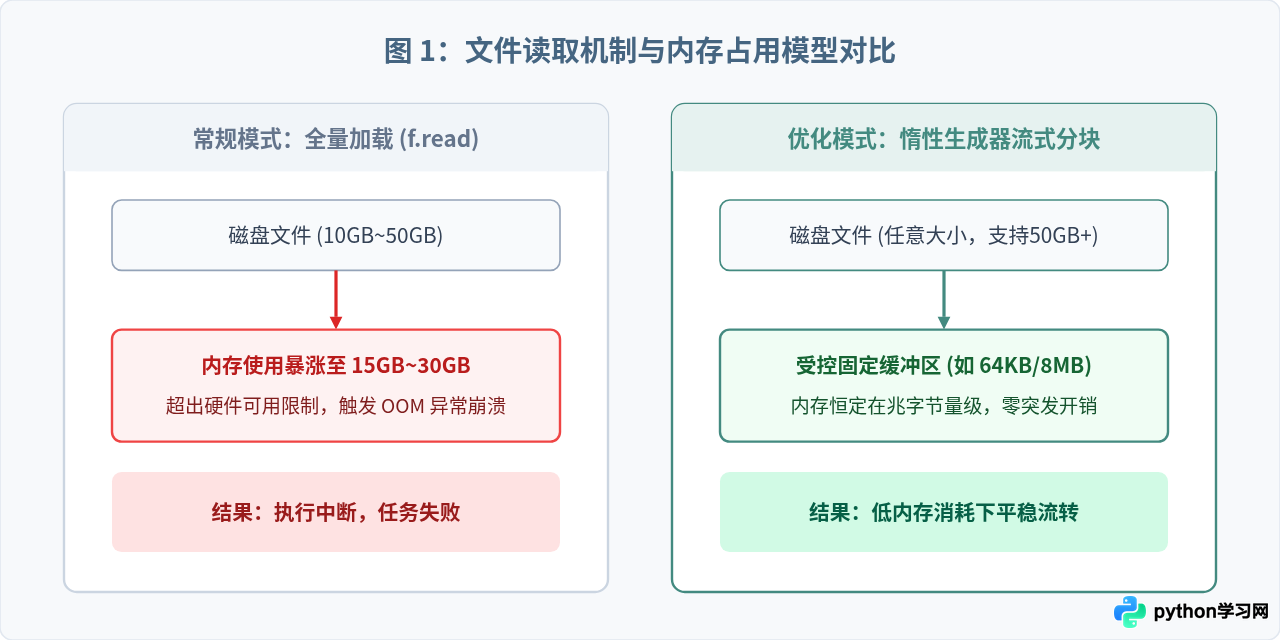
常规文本处理代码通常依赖 f.read() 或 f.readlines(),其执行逻辑是将文件全部内容以字符串或字符串列表的形式直接载入进程地址空间。一个10GB的纯文本文件在被载入Python解释器后,由于字符串对象的包装开销、元数据以及内存页对齐,实际占用的堆内存往往会达到15GB至25GB,远超普通工作站的物理承受极限。
除了读取阶段的数据堆积,词频统计本身的中间数据结构同样隐藏着严重的内存陷阱。Python内置的 dict 和 collections.Counter 是高度优化的散列表,但在维护数千万乃至数亿个独立词汇时,哈希桶的扩容机制与字符串对象的内存开销极为可观。假设文本中包含5000万个平均长度为10字节的独立词汇,单个字典对象的净内存消耗可轻易突破4GB。因此,内存优化的关键在于同时切断“文件内容全量驻留”与“全局词频表无界膨胀”两条链路。
二、第一阶段优化:流式分块与跨块分词安全
解除读取阶段内存压力的基础是利用Python文件对象自身的迭代器协议。文件对象在底层通过缓冲I/O逐行提取数据,语法形如 for line in file_obj:。这种方式能保证单次仅保留当前行在内存中。然而在工程实际中,直接按行遍历存在一个致命盲区:大文件可能由于序列化缺陷或单行超长(例如单行包含数百万字符的无换行日志或JSON字符串),导致这一行读取直接演变为巨型字符串加载,进而诱发OOM。
更加鲁棒的解法是按照固定字节块(Chunk)进行二元或文本流读取。但固定块读取会引入新挑战:词元切分截断。固定长度的块边界极有可能落在某个单词的正中间,例如将“dictionary”切分为前一个块尾部的“dict”与后一个块头部的“ionary”。如果不妥善处理,会导致原有词汇统计被错误拆解并产生大量虚假单词。
正确的做法是在内存中维护一个轻量的残存词元缓冲区(Token Fragment Buffer)。当读取当前Chunk时,以空白字符或标点符号切分词元后,最后一个未被明确分隔的片段不计入当前统计,而是暂存至缓冲区,在下一个Chunk读取完毕后拼接到其首部再进行分词。在文件结束读取时,缓冲区中的最后一个残存片段才作为独立单词计入。
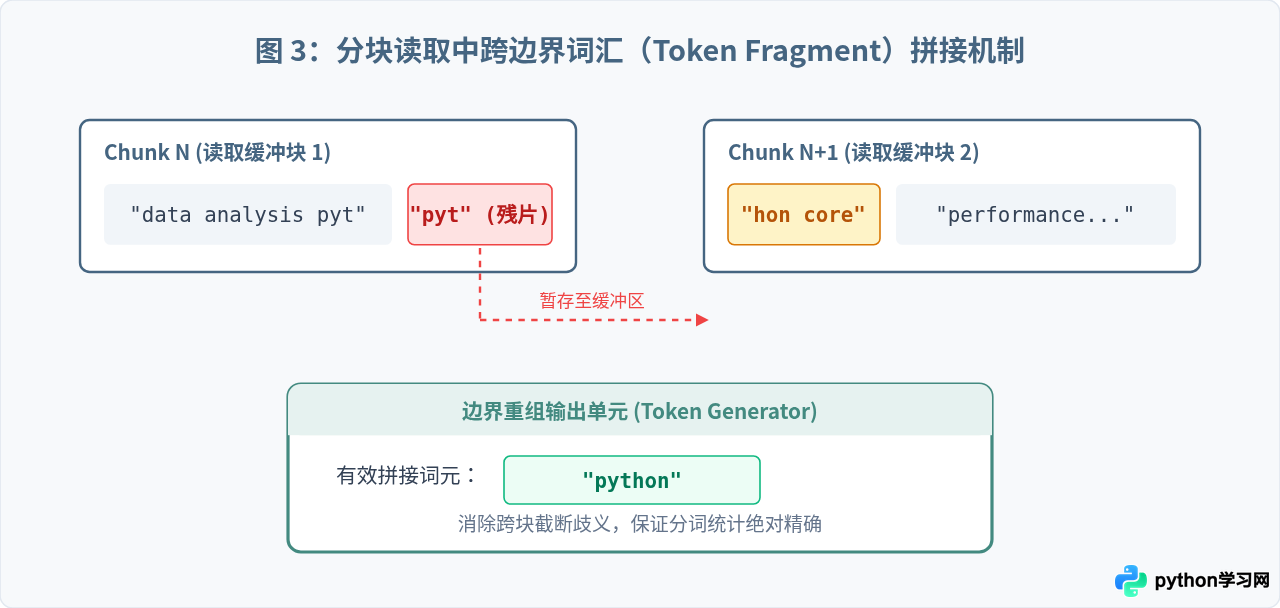
以下是具备防截断能力的生成器函数实现,通过设定受控的 chunk_size(例如 8MB),确保无论单行多长,内存消耗始终严格维持在常数级:
import re

def safe_word_stream(file_path, chunk_size=8 * 1024 * 1024):
    """
    流式分块读取大文件并逐个产出清洗后的单词。
    内存占用恒定受限于 chunk_size,自动处理跨块词汇截断。
    """
    token_pattern = re.compile(r'\b[a-zA-Z0-9_-]+\b')
    remainder = ""

    with open(file_path, 'r', encoding='utf-8', errors='replace') as f:
        while True:
            chunk = f.read(chunk_size)
            if not chunk:
                break

            # 将前一块末尾未切完的字符拼接到当前块头部
            content = remainder + chunk

            # 如果当前块末尾字符不是空格或分隔符,可能包含被切断的词
            if not content[-1].isspace():
                # 寻找最后一个空白或标点分割点
                last_space_idx = max(content.rfind(' '), content.rfind('\n'), content.rfind('\t'))
                if last_space_idx != -1:
                    remainder = content[last_space_idx + 1:]
                    content = content[:last_space_idx]
                else:
                    # 整块均为连续无空格文本,整体作为残余留存
                    remainder = content
                    content = ""
            else:
                remainder = ""

            # 使用正则从当前清洗块中产出词汇
            for match in token_pattern.finditer(content):
                yield match.group(0).lower()

    # 产出文件最后遗留的单字片段
    if remainder:
        for match in token_pattern.finditer(remainder):
            yield match.group(0).lower()
三、第二阶段优化:统计字典的内存控制与分治溢写
若文本词汇的基数具有强重复性(例如自然语言词汇总量通常稳定在数万至数十万之间),仅靠上述生成器配合标准 collections.Counter 即可满足要求。但在真实工程场景中(如URL访问日志、带哈希ID的机器生成文本、混淆代码或基因序列分析),不重复词汇数量可能高达数千万。此时内存危机转移到了计数结构本身。
当词频字典容纳的词项数量逼近内存上限时,最成熟稳健的工业级方案是分治与外部排序归并(External Merge Sort)。具体步骤如下:
- 内存阈值批次计数:维持一个局部
Counter对象。当局部词条数量达到设定的阈值(例如50万条)时,暂停读取。 - 排序并溢写临时文件:将当前批次的词项按字母顺序排序,写入磁盘上的临时文本文件(格式如
word\tcount\n),随后立即释放内存中的局部字典,触发垃圾回收。 - 多路流式归并:在全部文件扫描完成后,磁盘上存在若干个按词序排好序的小文件。利用 Python 的
heapq.merge工具对这些小文件的有序行进行多路归并,以流的方式实时累加相同词项的频次,最终将汇总结果写入目标输出。
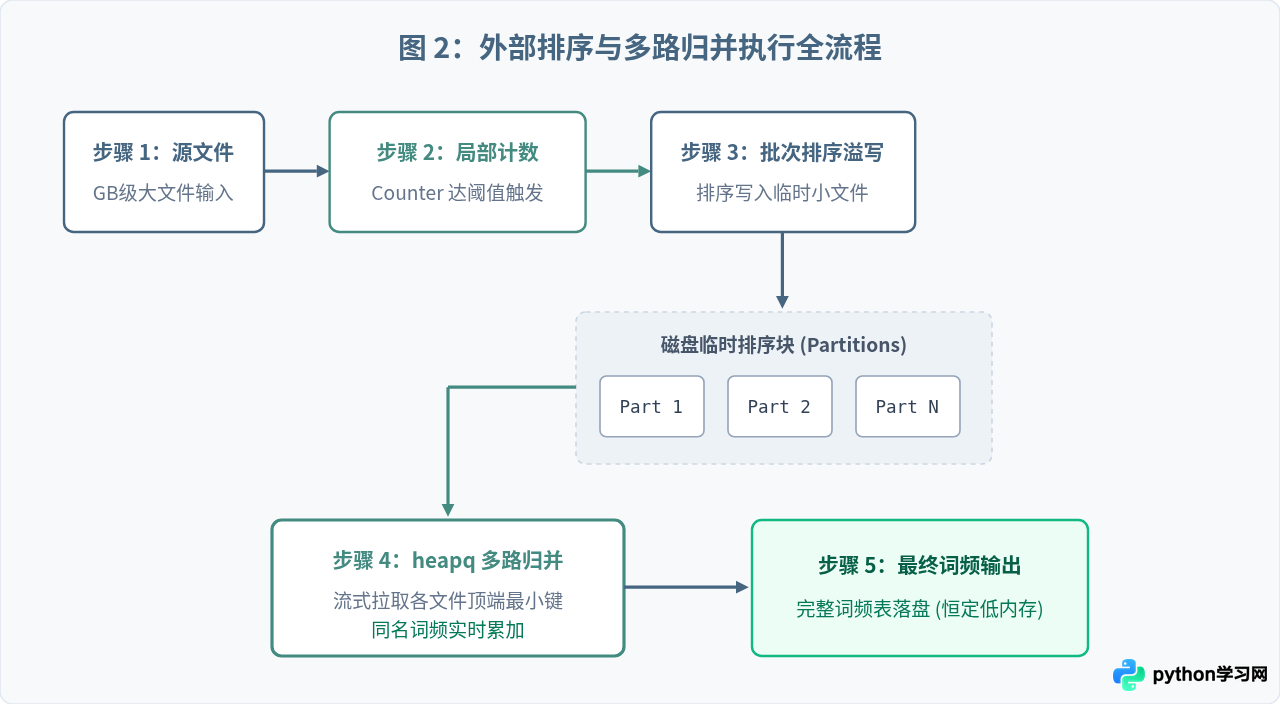
这种设计在数学上具备严密的复杂度保证:无论总词量有多庞大,内存中仅需驻留与临时文件数量相等的迭代指针。以下为完整的外部多路归并统计实现:
import os
import tempfile
import heapq
from collections import Counter

def external_word_count(input_file, output_file, batch_limit=500000):
    """
    外部排序多路归并词频统计。
    在受限内存下稳定完成海量独立词汇的精确聚合。
    """
    temp_dir = tempfile.mkdtemp(prefix="word_count_temp_")
    temp_files = []

    current_counter = Counter()
    batch_idx = 0

    # 阶段 1:分批读取并溢写排序中间文件
    for word in safe_word_stream(input_file):
        current_counter[word] += 1

        if len(current_counter) >= batch_limit:
            temp_path = os.path.join(temp_dir, f"batch_{batch_idx}.txt")
            with open(temp_path, 'w', encoding='utf-8') as tf:
                # 必须按词名有序写出,以便后续流式归并
                for w in sorted(current_counter.keys()):
                    tf.write(f"{w}\t{current_counter[w]}\n")
            temp_files.append(temp_path)
            current_counter.clear()
            batch_idx += 1

    # 写入最后一批残留数据
    if current_counter:
        temp_path = os.path.join(temp_dir, f"batch_{batch_idx}.txt")
        with open(temp_path, 'w', encoding='utf-8') as tf:
            for w in sorted(current_counter.keys()):
                tf.write(f"{w}\t{current_counter[w]}\n")
        temp_files.append(temp_path)
        current_counter.clear()

    # 生成器:逐行解析临时文件的 (word, count)
    def parse_temp_file(file_obj):
        for line in file_obj:
            line = line.strip()
            if line:
                w, c = line.split('\t')
                yield (w, int(c))

    # 阶段 2:多路归并聚合
    open_files = [open(p, 'r', encoding='utf-8') for p in temp_files]
    file_iterators = [parse_temp_file(f) for f in open_files]

    # heapq.merge 合并多个有序迭代器
    merged_stream = heapq.merge(*file_iterators, key=lambda item: item[0])

    with open(output_file, 'w', encoding='utf-8') as out_f:
        current_word = None
        current_total = 0

        for w, c in merged_stream:
            if w == current_word:
                current_total += c
            else:
                if current_word is not None:
                    out_f.write(f"{current_word}\t{current_total}\n")
                current_word = w
                current_total = c

        if current_word is not None:
            out_f.write(f"{current_word}\t{current_total}\n")

    # 清理阶段:关闭句柄并删除临时文件
    for f in open_files:
        f.close()
    for p in temp_files:
        os.remove(p)
    os.rmdir(temp_dir)
四、极值场景优化:仅需Top-K高频词的剪枝方案
在大量实际业务中,我们并不需要保存全量低频词的精确计数值,而仅仅关注频次最高的前K个词(如 Top-100 或 Top-1000)。如果在海量唯一词场景下依然执行全量归并,会产生不必要的磁盘I/O。
对于Top-K场景,可使用周期性剪枝(Periodic Pruning)与最小堆维护。在内存字典达到阈值(如100万项)时,直接剔除频次处于极低梯度的长尾词(例如剔除只出现1次的冷门词),或者通过最小堆(Min-Heap)仅锁定当前最高频候选集。由于高频词汇符合齐普夫定律(Zipf's Law),头部极少数词汇占据了绝大多数词频出现次数,剪枝操作能在保持最终Top-K高准确率的前提下,使内存开销减少80%以上。
五、方案选型与工程实践指南
选择何种内存优化方案应根据数据规模与词汇分布特征动态权衡。在构建生产级脚本时,还需遵守以下工程实践:
- 编码容错:大文件读取必须明确指定
encoding='utf-8'并设置errors='replace'或errors='ignore'。若遇到不可解码字符,默认的抛错退出会导致数小时计算付诸东流。 - 垃圾回收协助:在批次数据写入磁盘后,显式调用
current_counter.clear(),在某些高频内存波动场景下,可适时调用gc.collect()促使底层堆内存归还操作系统。 - 临时文件路径选择:执行外部排序时,大量写盘操作会对I/O吞吐造成压力。确保
tempfile指定的目录位于SSD挂载盘或专用高速临时盘,避免将I/O等待转嫁为系统CPU负载。
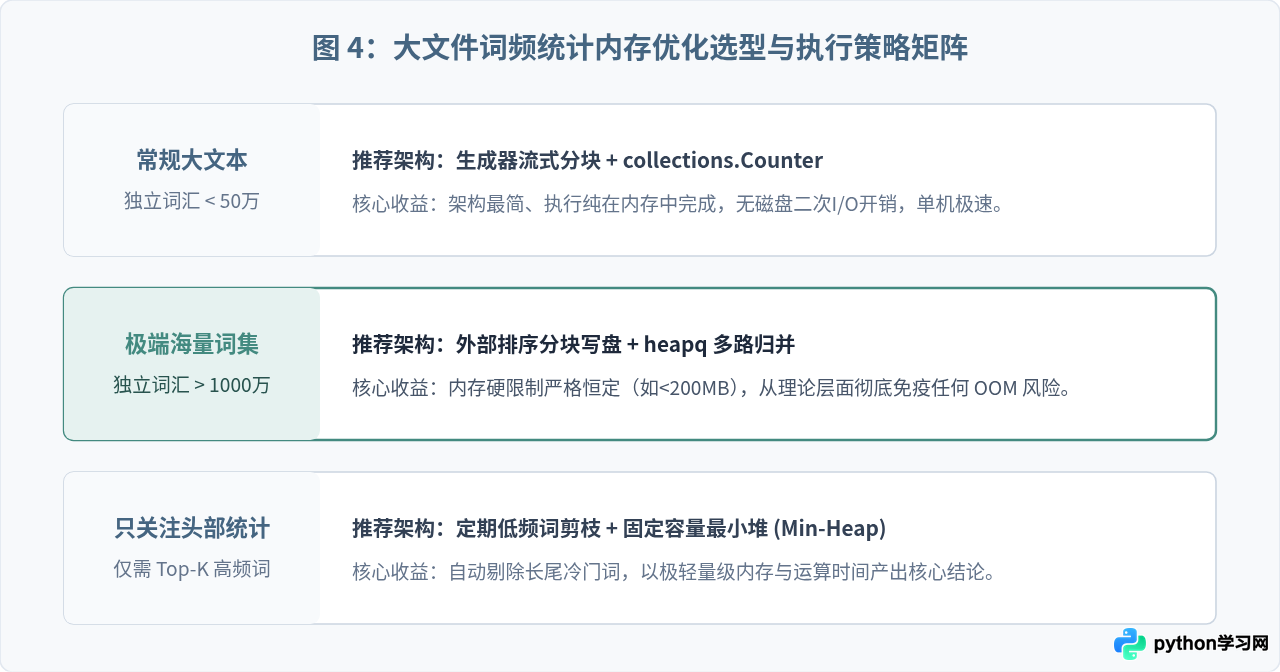
通过合理结合流式防截断生成器与外部多路归并策略,开发者可以在低配单机环境中从容统计数百吉字节体量的文本,既保证了统计结果的数学精度,又彻底解除了内存溢出风险。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















