


Python subprocess 实战:自动化调用 Git 与系统工具
深入讲解 Python 标准库 subprocess 的实战用法,涵盖 subprocess.run 核心参数、Git 自动化脚本编写、系统工具调用、shell=True 与 shell=False 安全对比及常见异常排查。
在编写自动化脚本、持续集成流水线或运维工具时,我们经常需要借助外部程序来完成工作。例如操作 Git 仓库检出代码、调用系统打包压缩工具,或是读取系统硬件与网络状态。Python 自 3.5 版本起确立了 subprocess.run 作为调用子进程的高级推荐接口。本文将从执行机制入手,拆解参数配置与安全差异,并通过完整的自动化 Git 与系统工具脚本,展示规范的调用与错误排查方法。
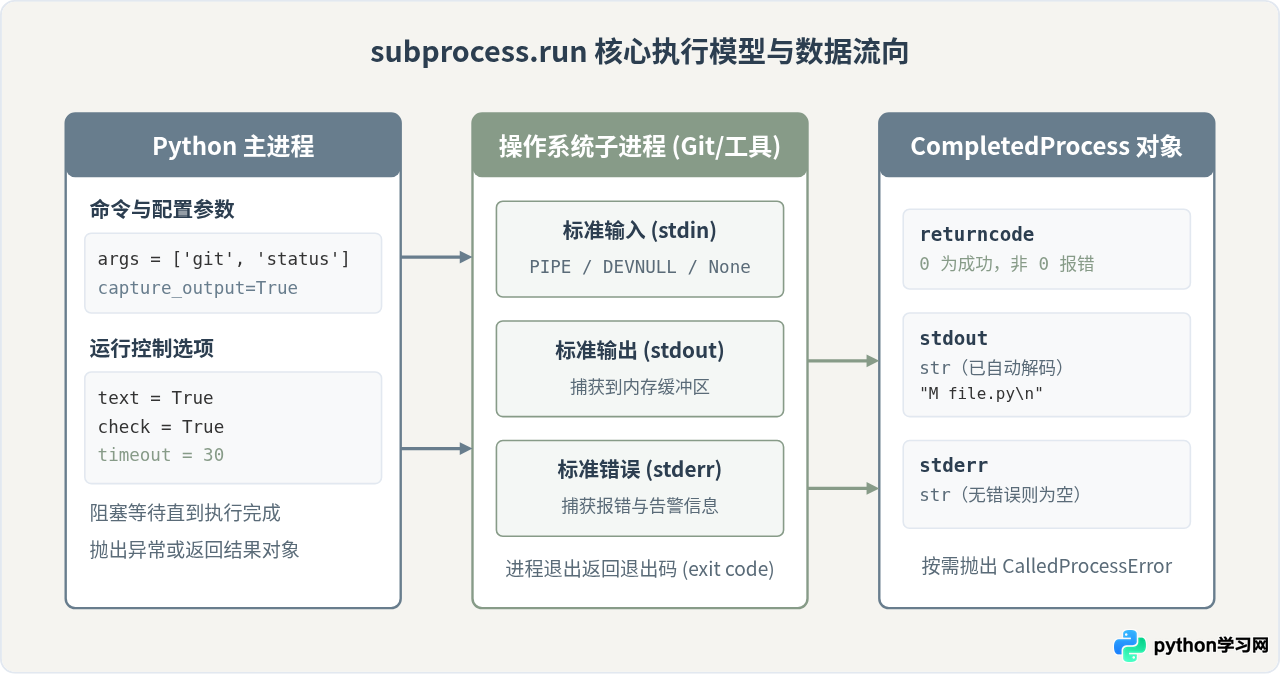
一、subprocess.run 基础语法与核心参数
在早期的 Python 代码中,开发者常使用 os.system、os.popen 或直接创建 subprocess.Popen 实例来运行命令。然而 os.system 无法直接获取命令输出结果且无法精确处理错误,底层 Popen 虽灵活但需要手动处理管道死锁和等待逻辑。现在,绝大多数同步命令调用都应直接使用 subprocess.run()。
调用 subprocess.run 时,通常建议同时指定以下几组核心参数:
args:要执行的命令。应使用字符串列表形式,如["git", "status"],而不是单一整行字符串。capture_output=True:同时捕获子进程的stdout和stderr。若不配置,命令输出将直接打印到当前控制台,代码无法取得输出文本。text=True(或universal_newlines=True):将管道返回的字节流(bytes)按照系统默认或指定编码自动解码为普通字符串(str),省去手动.decode("utf-8")的繁琐步骤。check=True:当外部命令返回非零退出状态码(表示执行出错)时,主动抛出subprocess.CalledProcessError异常,便于在上层进行错误拦截与事务回滚。timeout=N:设置超时上限(单位为秒)。防止某些命令由于交互式提示或网络死锁陷入无限挂起。
下面是一个标准的最小化调用范例:
import subprocess

try:
    result = subprocess.run(
        ["git", "--version"],
        capture_output=True,
        text=True,
        check=True,
        timeout=10
    )
    print("命令执行成功,输出内容:")
    print(result.stdout.strip())
except subprocess.CalledProcessError as e:
    print(f"命令执行失败,退出码:{e.returncode},错误原因:{e.stderr.strip()}")
except subprocess.TimeoutExpired:
    print("命令执行超时!")
二、关键抉择:shell=False 与 shell=True 的机制差异与安全边界
在初学 subprocess 时,许多人喜欢设置 shell=True,因为这样可以直接复制终端里的整行命令(如 git commit -m "init")。但这一参数会从底层改变进程的启动机制,带来截然不同的安全性与执行环境。
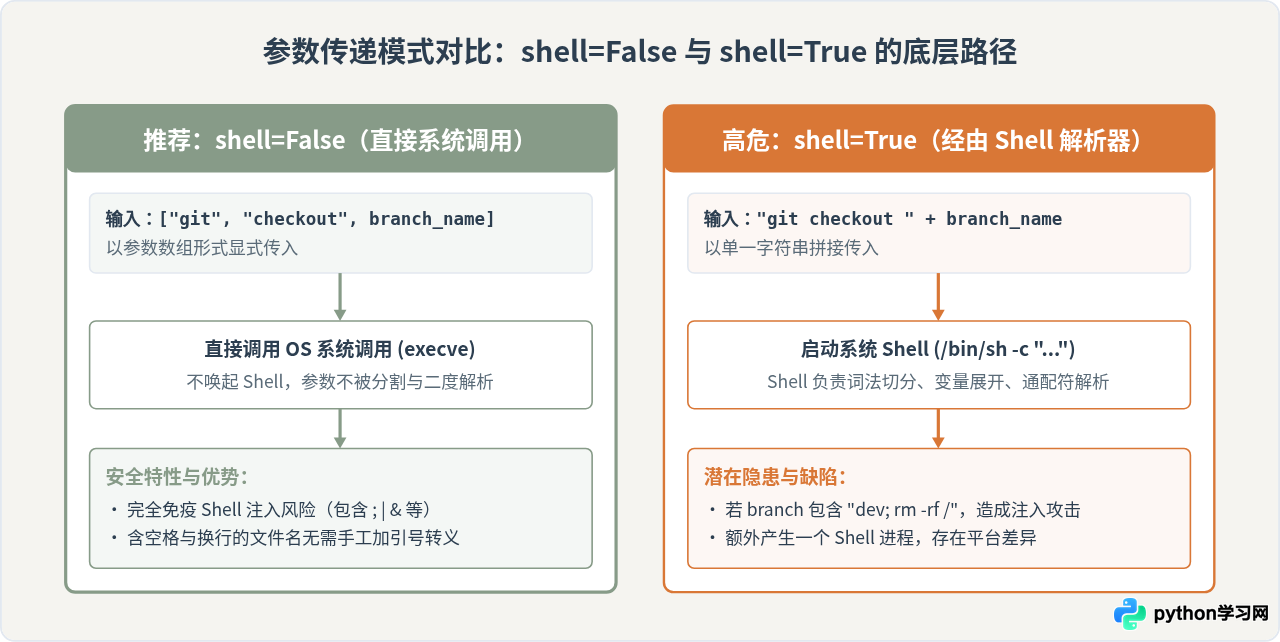
为了直观说明差异,假设有一个文件名中包含空格的文件 my project notes.txt:
- 使用
shell=False时,我们传入["git", "add", "my project notes.txt"]。Python 底层会把第三个元素作为一个整体字面量传给内核execve,Git 接收到的就是确切的文件名,不需要做任何加双引号或反斜杠的转义。 - 而如果使用
shell=True并写入subprocess.run(f"git add {file_name}", shell=True),传递给 Shell 的整串字符串是git add my project notes.txt。Shell 会自动按空格切分为三个不同的文件参数,导致命令找不到目标并报错。
shell=False 并传递列表参数。只有当你明确需要使用操作系统 Shell 的内建特性(如管道符号 |、输入重定向 >、环境变量展开等)时才考虑 shell=True。若必须使用,务必使用 shlex.quote() 对所有动态传入的外部变量进行严格转义。
三、实战案例:自动化 Git 代码提交流水线
在日常项目中,我们经常需要自动化批量操作仓库:检查当前分支是否存在未提交的代码、暂存指定变更、使用规范的前缀生成提交信息,并推送到远端服务器。在脚本中,关键在于把每一个 Git 操作封装为可观察、可拦截异常的步骤。
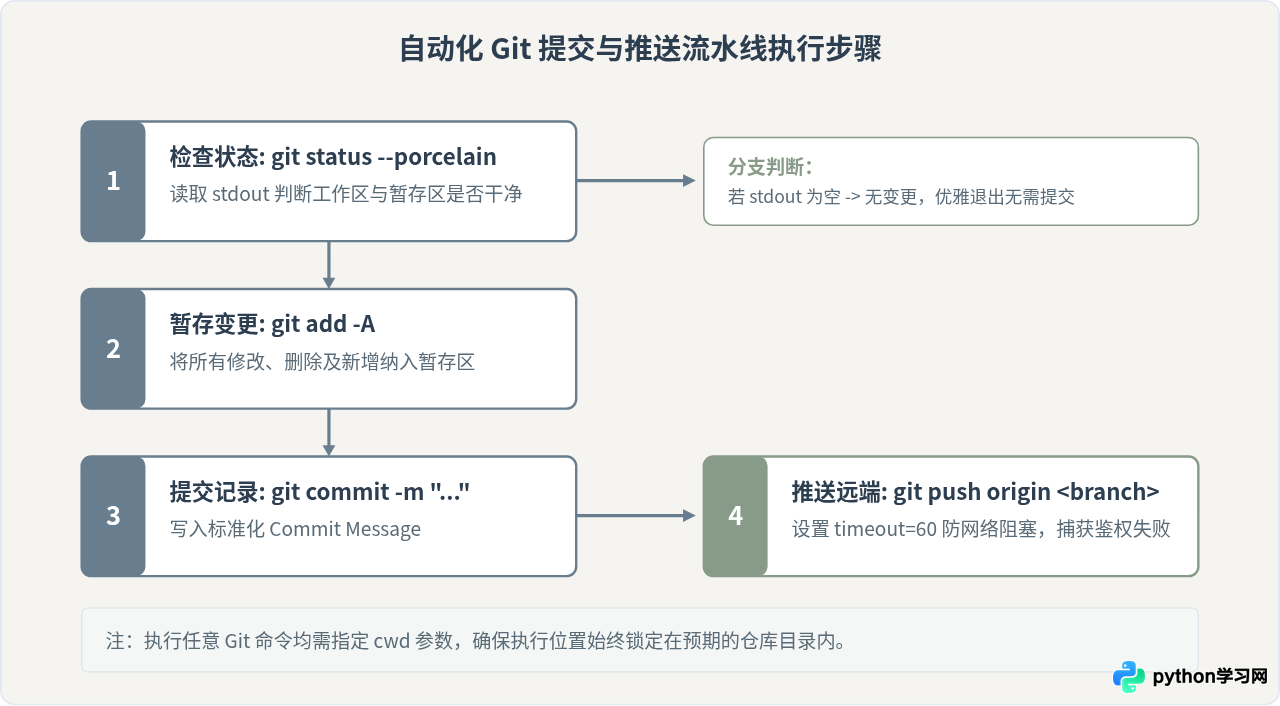
下面是一个经过模块化封装的完整脚本。该脚本提供 run_git() 统一执行入口,并通过 cwd 参数指定执行仓库的物理绝对路径:
import subprocess
import os
from typing import List, Optional

def run_git_command(args: List[str], repo_path: str, timeout: int = 30) -> subprocess.CompletedProcess:
    """
    在指定仓库目录下执行 Git 命令的通用封装函数
    """
    if not os.path.isdir(repo_path):
        raise ValueError(f"指定的目录不存在: {repo_path}")

    # 强制将 git 置于参数首位
    full_cmd = ["git"] + args

    try:
        result = subprocess.run(
            full_cmd,
            cwd=repo_path,          # 锁定执行工作目录
            capture_output=True,    # 捕获 stdout 与 stderr
            text=True,              # 自动转为字符串
            check=True,             # 错误退出时抛出 CalledProcessError
            timeout=timeout,
            encoding="utf-8",
            errors="replace"        # 避免中文输出中的非常规字节导致解码崩溃
        )
        return result
    except subprocess.CalledProcessError as e:
        error_msg = e.stderr.strip() if e.stderr else e.stdout.strip()
        raise RuntimeError(f"Git 命令执行失败 [{' '.join(full_cmd)}]: {error_msg}") from e
    except subprocess.TimeoutExpired as e:
        raise TimeoutError(f"Git 命令执行超时 ({timeout}s): {' '.join(full_cmd)}") from e

def auto_commit_and_push(repo_path: str, commit_message: str, branch: str = "main"):
    print(f"[*] 开始检查仓库: {repo_path}")

    # 1. 检查是否有变动 (porcelain 格式输出紧凑且稳定,专门适配脚本解析)
    status_res = run_git_command(["status", "--porcelain"], repo_path=repo_path)
    if not status_res.stdout.strip():
        print("[+] 工作区干净,没有需要提交的文件变更。")
        return

    print("[*] 检测到文件改动,执行暂存...")
    run_git_command(["add", "-A"], repo_path=repo_path)

    print(f"[*] 提交修改: {commit_message}")
    run_git_command(["commit", "-m", commit_message], repo_path=repo_path)

    print(f"[*] 推送至远端分支 {branch}...")
    run_git_command(["push", "origin", branch], repo_path=repo_path, timeout=60)
    print("[+] 提交流水线执行完毕!")

if __name__ == "__main__":
    # 示例调用(请根据实际路径测试)
    TARGET_REPO = os.path.abspath(".")
    try:
        auto_commit_and_push(
            repo_path=TARGET_REPO,
            commit_message="chore: 自动同步配置文件与更新文档",
            branch="main"
        )
    except Exception as err:
        print(f"[!] 自动化流程异常中断: {err}")
四、实战案例:调用系统工具并解析结构化输出
除版本管理外,自动化脚本往往需要读取磁盘空间、网络状态或执行系统级归档。在不同操作系统中,调用原生命令行工具(如 Linux/macOS 的 df、tar、uptime)通常比引入厚重的第三方库更加轻量直接。
场景:定时获取系统磁盘使用率
系统命令 df -k 或 df -h 输出的是多行表格文本。借助 Python 的字符串拆分,我们可以直接将外部命令的输出转化为字典列表:
import subprocess

def get_disk_usage():
    # 使用 -P 选项保证输出为 POSIX 标准单行格式,避免长挂载点换行
    cmd = ["df", "-P", "-k"]
    result = subprocess.run(cmd, capture_output=True, text=True, check=True)

    lines = result.stdout.strip().split("\n")
    headers = lines[0].split()
    disk_info = []

    for line in lines[1:]:
        parts = line.split()
        if len(parts) >= 6:
            filesystem = parts[0]
            total_kb = int(parts[1])
            used_kb = int(parts[2])
            avail_kb = int(parts[3])
            capacity_pct = parts[4]
            mount_point = parts[5]

            disk_info.append({
                "filesystem": filesystem,
                "total_mb": round(total_kb / 1024, 2),
                "used_mb": round(used_kb / 1024, 2),
                "avail_mb": round(avail_kb / 1024, 2),
                "usage": capacity_pct,
                "mount": mount_point
            })
    return disk_info

# 示例解析结果
if __name__ == "__main__":
    disks = get_disk_usage()
    for d in disks:
        if d["mount"] == "/":
            print(f"根分区挂载点: {d['mount']} | 可用空间: {d['avail_mb']} MB | 使用率: {d['usage']}")
五、常见问题排查与避坑指南
-
返回码非零,但 stderr 没有任何信息:
部分系统工具(如
grep在没有匹配到任何行时会返回状态码 1;或者diff发现差异时返回 1)将返回码作为逻辑判断标志,而非程序崩溃。对于这类命令,不应简单开启check=True,而应手动检查result.returncode:res = subprocess.run(["grep", "keyword", "log.txt"], capture_output=True, text=True) if res.returncode == 0: print("匹配成功") elif res.returncode == 1: print("未找到匹配行,属正常业务状态") else: print(f"grep 异常退出: {res.stderr}") -
Windows 与类 Unix 环境的跨平台命令差异:
在 Windows 下,诸如
dir、del、copy并不是可执行文件(.exe),而是cmd.exe的内建命令。直接运行subprocess.run(["dir"])会抛出FileNotFoundError。跨平台脚本应优先使用 Python 标准库函数(如os.listdir、pathlib.Path)代替系统内建命令。 -
中文输出乱码与解码异常:
子进程的编码由当前终端环境的
locale决定。在部分 Windows 机器上,中文输出可能为 GBK,而在 Linux/macOS 上通常为 UTF-8。如果不显式指定编码,Python 使用系统默认的locale.getpreferredencoding()进行解码,容易出现UnicodeDecodeError。
解决方案:在subprocess.run中显式传入encoding="utf-8", errors="replace",或在无法确定编码时使用capture_output=True接收原生字节流(bytes),之后使用chardet判断或按需解码。 -
处理海量输出时的内存与挂起问题:
subprocess.run会在子进程退出前将所有输出缓冲在内存中。如果外部程序产生了数十 GB 的数据流,subprocess.run会直接耗尽系统内存。遇到大规模连续日志输出时,应改用subprocess.Popen配合按行迭代stdout.readline()进行流式消费。
总结
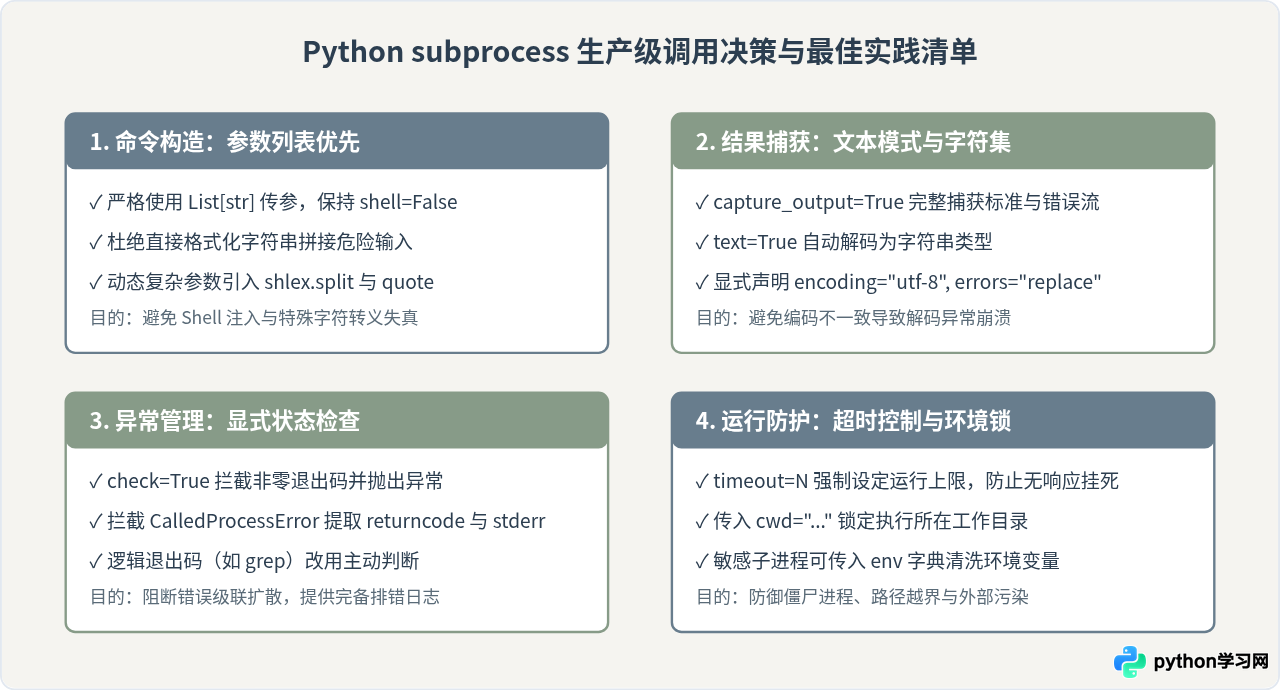
在自动化任务中,正确使用 subprocess.run 可以让我们安全、可控地连接 Python 与外部系统生态。牢记“默认列表传参、坚守 shell=False、显式指定编码与超时、按需处理退出码”的四项准则,即可编写出稳定、高效且兼顾安全性的自动化运维与集成脚本。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















