


怎么用Python strptime解析含中文或非标准格式的日期
详细讲解如何使用 Python 的 datetime.strptime 解析包含中文字符、不规则分隔符以及非标准格式的日期字符串,并提供实用的预处理与异常容错方案。
datetime.strptime 的格式字符串中写入对应的中文字符;对于含有不规则前缀、中文星期、大写数字或混杂样式的非标准输入,则先通过正则表达式提取或建立字典映射将其规整化,再交由 strptime 完成高精度的对象转换。
一、strptime 的核心机制与中文直接匹配
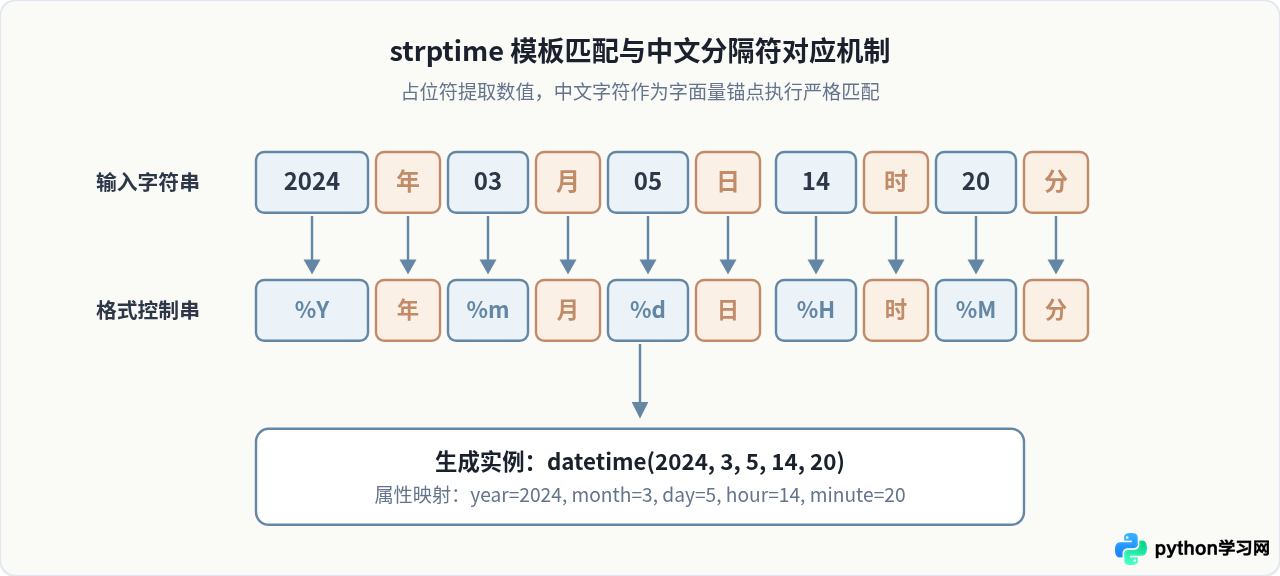
Python 标准库中的 datetime.datetime.strptime() 方法本质上是一个严格的模式匹配引擎。它的两个核心参数是待解析的字符串和格式化控制串。在底层匹配过程中,格式控制串中的每一个占位符(例如 %Y 代表四位年份、%m 代表两位月份)都会捕获对应位置的数字,而占位符之外的所有字符(无论是短横线 -、斜杠 / 还是汉字 年、月、日)都会作为字面量锚点进行精确比对。
这意味着,当遇到形如 "2024年03月05日 14时20分" 的标准中文日期时,并不需要提前剥离汉字,直接将中文字符书写在格式模板中即可:
from datetime import datetime

# 基础中文日期解析
date_str = "2024年03月05日 14时20分30秒"
fmt = "%Y年%m月%d日 %H时%M分%S秒"

dt = datetime.strptime(date_str, fmt)
print("解析结果:", dt)
# 输出:解析结果: 2024-03-05 14:20:30
该方法的解析逻辑清晰直观:%Y 负责解析 2024,随后匹配汉字“年”,紧接着 %m 匹配 03,依此类推。如果文本中的汉字与格式模板中的字符完全对齐,解析过程便能一次性顺利完成。
二、包含中文星期与月份的特殊处理
中文日期中常包含如“星期二”、“周三”或以文本形式表达的月份。在 Python 中,标准指令 %a、%A 用于匹配星期,%b、%B 用于匹配月份名称。但这组占位符在实际运行时有一个关键制约条件:它们依赖操作系统的区域语言设置(Locale)。
1. 系统 Locale 方案及其弊端
在默认情况下,许多运行环境的 Locale 是 C 或 en_US.UTF-8。此时如果直接使用 %A 解析“星期二”,Python 将抛出 ValueError。虽然可以通过调用 locale.setlocale() 切换为中文环境,但这在工程实践中往往带来隐患:
import locale
from datetime import datetime

# 在类 Unix 系统中设置区域
# 注意:在 Windows 系统中,区域名称通常写作 'Chinese (Simplified)_China.936'
try:
    locale.setlocale(locale.LC_TIME, 'zh_CN.UTF-8')
    dt = datetime.strptime("2024年03月05日 星期二", "%Y年%m月%d日 %A")
    print("Locale 解析成功:", dt)
except locale.Error as e:
print("设置区域失败:", e)locale.setlocale() 作用于整个 Python 进程而非单个线程。在一个高并发的 Web 服务中修改全局 Locale,会导致其他线程的时间或货币格式输出发生混乱;此外,Linux、macOS 与 Windows 上的区域标识字符串互不通用,跨平台迁移时极易报错。
2. 推荐实践:正则预剥离与自定义字典替换
由于公历日期中的年、月、日已经能够唯一确定星期几,文本中的“星期二”或“周三”在解析中属于信息冗余。更加健壮且跨平台一致的方案是在解析前通过正则表达式将星期信息剥离,或者使用静态字典进行转换:
import re
from datetime import datetime

raw_date = "2024年03月05日 星期二 16:30"

# 1. 过滤掉常见中文星期信息(星期X 或 周X)
cleaned_date = re.sub(r'(?:星期|周)[一二三四五六日天]', '', raw_date)
# 清理后可能产生多余连续空格,使用正则规整单空格
cleaned_date = re.sub(r'\s+', ' ', cleaned_date).strip()

# 2. 对规整后的文本执行标准 strptime 解析
dt = datetime.strptime(cleaned_date, "%Y年%m月%d日 %H:%M")
print("预处理后解析结果:", dt)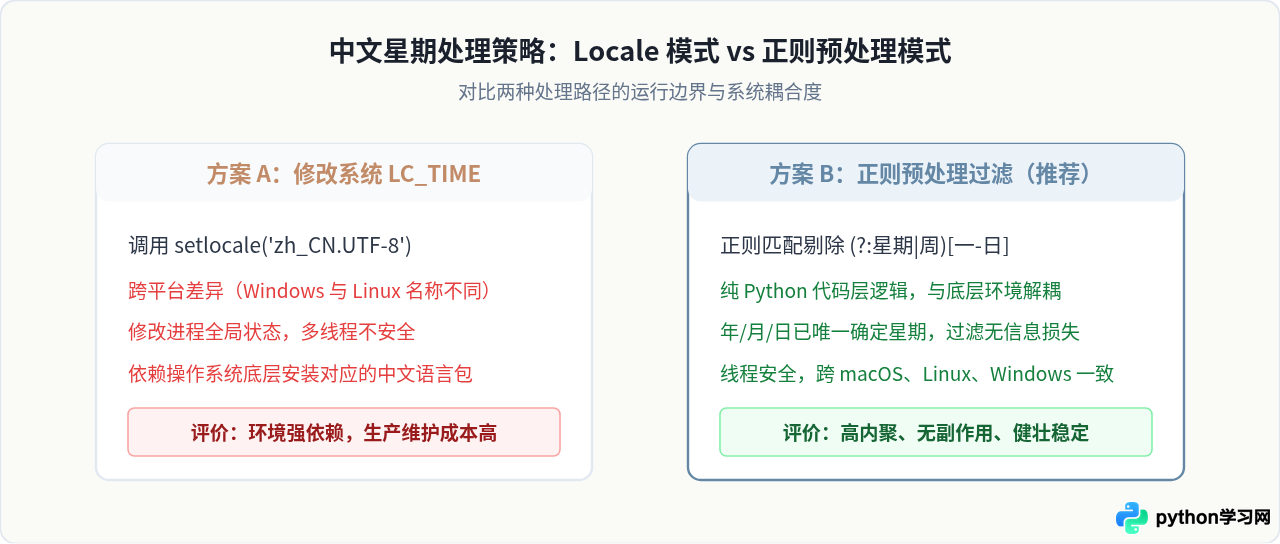
三、解析非标准与异构日期格式的实用方案
在日志挖掘、网页爬取或旧系统数据迁移中,输入的日期格式常常不受控。典型的非标准形式包括:日期嵌在长句中、多源异构的不同分隔符混杂、或者包含中文大写数字(如“二〇二四年三月五日”)。针对这几类场景,应采取对应的标准模式进行规整。
1. 场景一:嵌在非时间文本中的日期抽取
如果输入的字符串包含冗余的前缀或后缀(例如 "数据更新时间:2024-03-05 14:30 来源:自动化任务"),直接使用 strptime 会因为首尾无法匹配而抛出异常。
正确的做法是先利用正则表达式捕获核心日期片段,再交由 strptime 校验并转换为对象:
import re
from datetime import datetime

raw_text = "数据生成于2024年03月05日 14时30分,请核对。"

# 正则表达式抽取核心日期模式
pattern = r'(\d{4}年\d{1,2}月\d{1,2}日\s+\d{1,2}时\d{1,2}分)'
match = re.search(pattern, raw_text)

if match:
    extracted_str = match.group(1)
    # Python 的 %m 和 %d 支持非补零单数字(如 3月 和 03月 均可匹配)
    dt = datetime.strptime(extracted_str, "%Y年%m月%d日 %H时%M分")
    print("抽取并解析:", dt)
else:
    print("未找到有效日期")
2. 场景二:多格式混杂的枚举容错机制
当数据来源于不同业务方,存在 YYYY-MM-DD、YYYY/MM/DD、YYYY年MM月DD日 等多种可能时,维护一个按优先级排列的格式元组,结合 try...except ValueError 循环尝试,是最为稳健的做法:
from datetime import datetime

def parse_heterogeneous_date(date_str):
    # 清洗首尾空白字符
    cleaned = date_str.strip()

    # 定义候选格式清单(按预期出现频率排序)
    candidate_formats = (
        "%Y-%m-%d %H:%M:%S",
        "%Y-%m-%d",
        "%Y年%m月%d日 %H:%M",
        "%Y年%m月%d日",
        "%Y/%m/%d %H:%M:%S",
        "%Y/%m/%d",
        "%d/%b/%Y",
    )

    for fmt in candidate_formats:
        try:
            return datetime.strptime(cleaned, fmt)
        except ValueError:
            continue

    raise ValueError(f"无法使用预设格式解析日期字符串: '{date_str}'")

# 测试不同输入
print(parse_heterogeneous_date("2024-03-05"))
print(parse_heterogeneous_date("2024年03月05日 14:20"))
print(parse_heterogeneous_date("2024/03/05"))
3. 场景三:中文大写数字转标准阿拉伯数字
部分公文、报告或历史文本会采用诸如 "二〇二四年三月五日" 或 "二零二四年零三月零五日" 的写法。strptime 无法原生理解中文数词,必须在进入解析前进行字符映射替换:
from datetime import datetime

def parse_chinese_numeral_date(chinese_str):
    # 构建中文字符映射字典
    mapping = {
        '〇': '0', '零': '0', '一': '1', '二': '2', '三': '3',
        '四': '4', '五': '5', '六': '6', '七': '7', '八': '8',
        '九': '9', '十': '10'
    }

    # 替换中文数字(处理十进制及基础组合)
    s = chinese_str
    # 特殊处理“十”在日/月中的表示
    s = s.replace("二十", "2").replace("三十", "3").replace("十", "1")
    for ch, num in mapping.items():
        s = s.replace(ch, num)

    return datetime.strptime(s, "%Y年%m月%d日")

dt = parse_chinese_numeral_date("二〇二四年三月五日")
print("中文大写转换解析结果:", dt)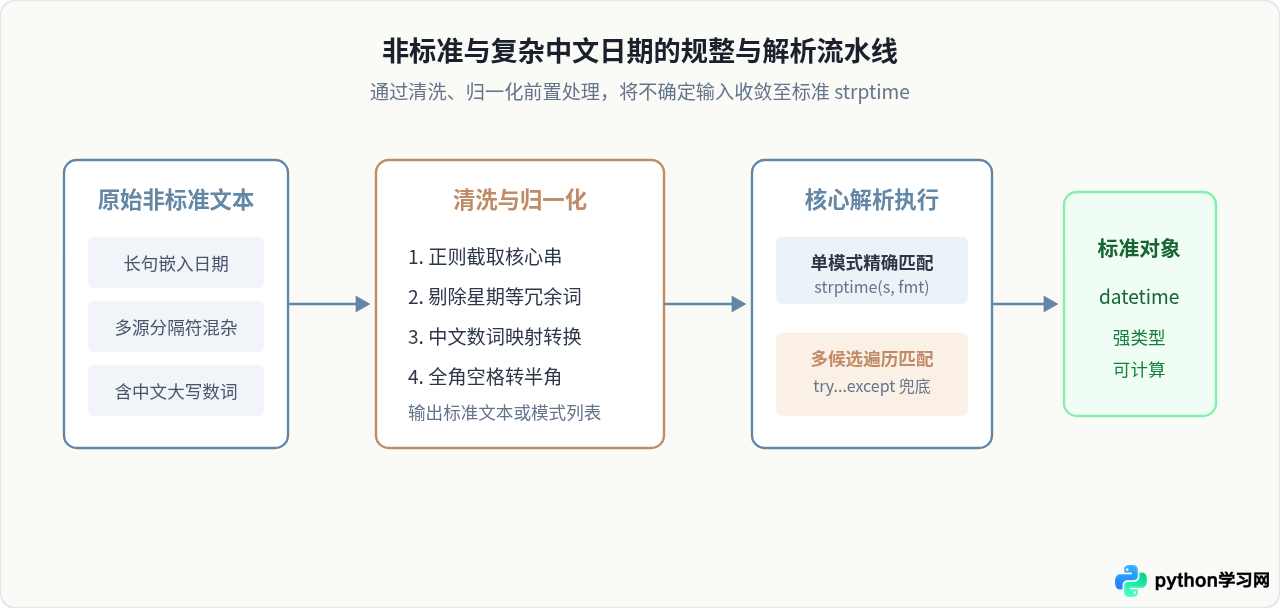
四、常见报错原因与防错排查
在调用 strptime 失败时,几乎无一例外会收到形如 ValueError: time data '...' does not match format '...' 的报错。以下是排查含中文及非标日期时的常见原因与核对清单:
-
不可见空格与全角空白: 从网页或 PDF 中复制的文本可能夹带
\u3000(全角空格)或\xa0(非换行空格)。而格式串中的普通空格" "无法匹配这些特殊字符。应在解析前执行re.sub(r'[\s\u3000\xa0]+', ' ', raw_str)进行归一化。 -
月份与日期的前导零: 在 Python 的标准实现中,
%m与%d在进行strptime输入匹配时,能够宽容解析补零(如"03")或不补零(如"3")的个位数数字。但如果格式串中有多余的空格或字符不匹配,则会导致整体失败。 -
时区偏移量格式: 若日期末尾带有
+08:00,在 Python 3.7 及以上版本可使用%z直接匹配(支持带冒号的 ISO 8601 时区偏移),早期版本则要求偏移量为无冒号的+0800。
五、方案选型与决策总结
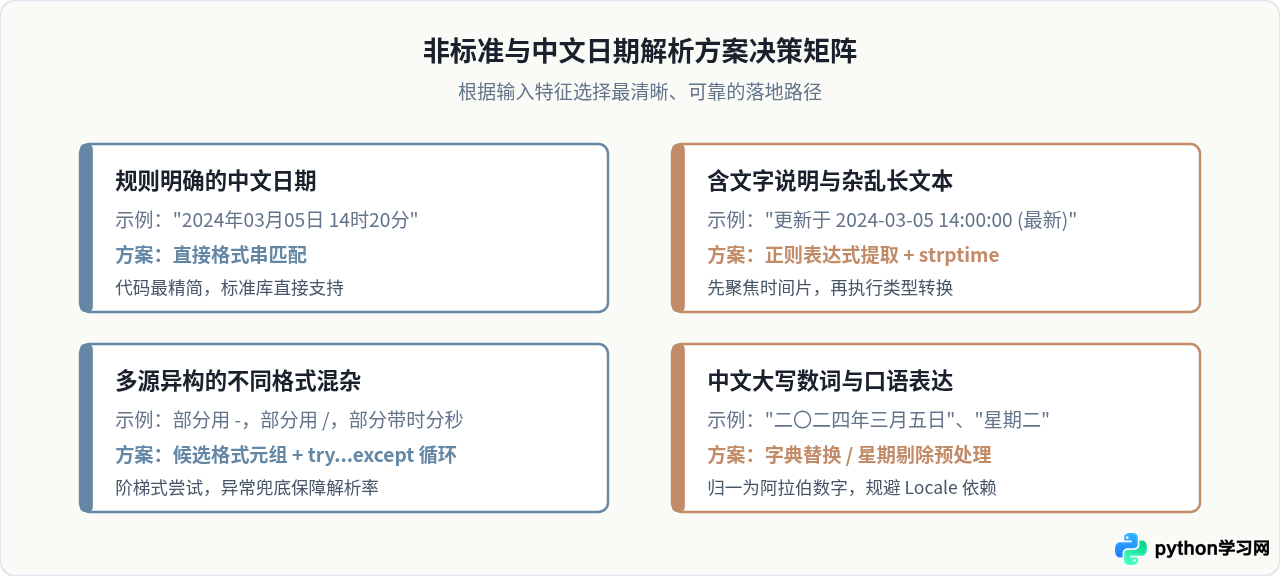
面对不同形态的日期数据,合理选择技术方案能够以最小的代码复杂度获得最高的运行可靠性。下表总结了各种常见场景的特征与推荐处理策略:
| 场景类型 | 输入样例 | 推荐策略 | 核心优势 |
|---|---|---|---|
| 标准固定中文 | 2024年03月05日 14:20 | 直接在格式串嵌入汉字 %Y年%m月%d日 |
无第三方依赖,执行速度最快 |
| 中文带星期 | 2024年3月5日 星期二 | 正则剔除星期字符后交由 strptime | 规避系统 Locale 的跨平台兼容陷阱 |
| 文本内嵌时间 | 发布于 2024-03-05 10:00 | re.search 提取核心时间组后解析 |
隔离前后干扰字符,容错率高 |
| 多来源混合格式 | 2024/3/5 与 2024-03-05 混杂 | 候选格式元组结合 try-except 遍历 |
结构简单,易于扩展新模式 |
| 中文大写数字 | 二〇二四年三月五日 | 字典映射批量替换后 strptime | 彻底将自然语言数值转为机器格式 |
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















