


Python PyMongo使用GridFS存储和读取大文件教程
本教程详细介绍在Python中使用PyMongo配合GridFS存储和读取大文件的完整操作流程,包含底层分块原理、核心代码示例、流式读写与生产环境调优建议。
一、GridFS 核心工作原理与存储结构
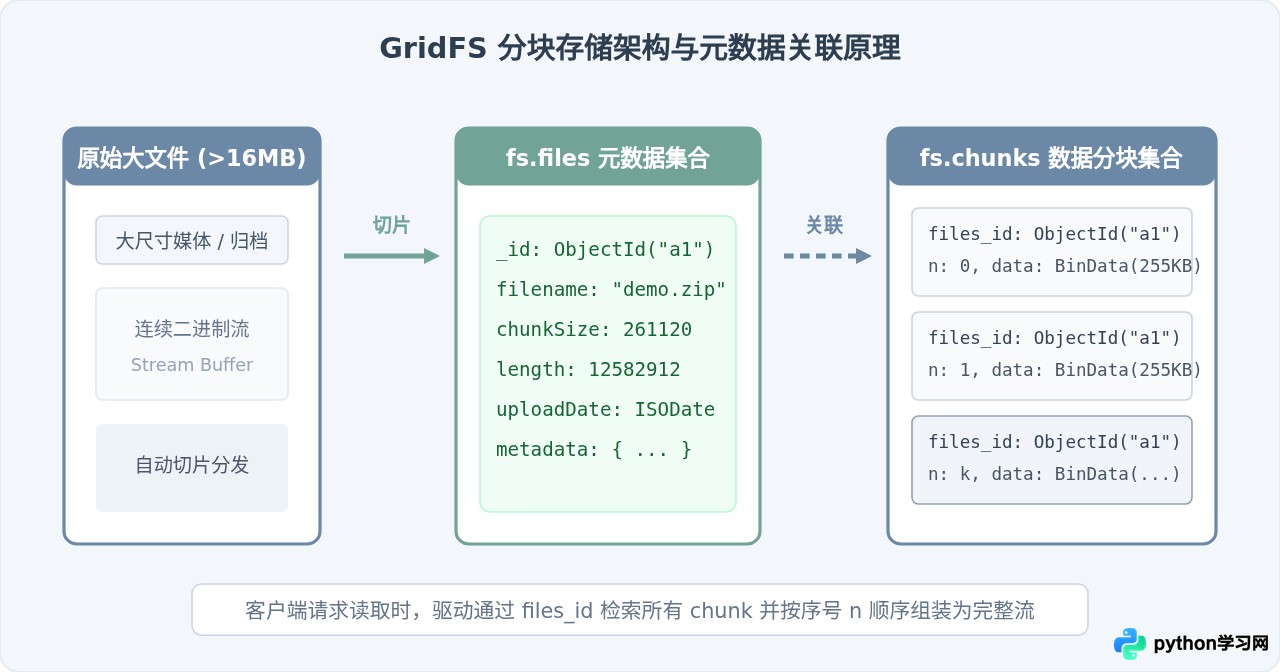
GridFS 并不是一种独立的文件系统,而是建立在 MongoDB 普通集合之上的一套规范。它将大文件切分成固定大小的数据块(默认每个块大小为 255KB),然后分别存储到两个独立的集合中:
- fs.files 集合:存储文件的元数据信息,如文件名(filename)、上传时间(uploadDate)、文件总字节数(length)、分块大小(chunkSize)以及计算出的唯一哈希值或自定义扩展字段。
- fs.chunks 集合:存储具体的二进制分块数据。每个分块包含指向元数据的关联 ID(files_id)、当前分块的序号(n,从 0 开始自增)以及二进制内容(data)。
二、环境安装与基础连接初始化
在 Python 中使用 GridFS 不需要额外安装独立组件,它直接内置于官方驱动 pymongo 中。首先安装 PyMongo:
pip install pymongo连接 MongoDB 并创建 GridFS 对象非常简单。我们先通过 MongoClient 获得数据库实例,然后传入 gridfs.GridFS 构造函数即可:
from pymongo import MongoClient
import gridfs

# 1. 建立 MongoDB 客户端连接
client = MongoClient("mongodb://localhost:27017/")

# 2. 指定目标数据库(例如 my_large_storage)
db = client["my_large_storage"]

# 3. 初始化默认 GridFS 实例(绑定到默认集合 fs.files 与 fs.chunks)
fs = gridfs.GridFS(db)

print("GridFS 初始化成功,当前连接数据库:", db.name)
三、核心操作全流程:存、查、读、删
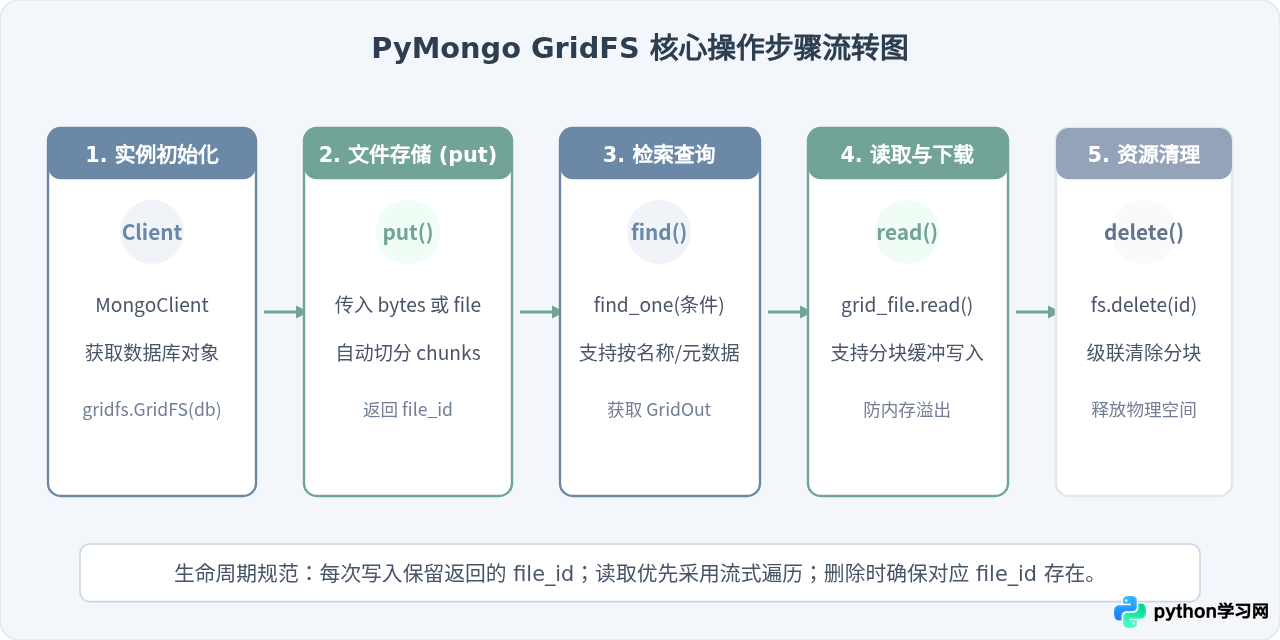
使用 PyMongo 操作 GridFS 的基本生命周期包含五个环节:上传写入、检索元数据、流式下载、按 ID 读取与清理删除。
1. 写入与存储大文件 (put)
fs.put() 方法支持接收二进制字节串(bytes)或任何具备 read() 方法的文件类对象(file-like object)。推荐直接传入打开的文件对象,这样驱动能以流式方式自动切分,避免将全部文件内容载入内存:
# 示例:将本地大文件写入 GridFS 并附带自定义元数据
file_path = "example_video.mp4"

with open(file_path, "rb") as f:
    file_id = fs.put(
        f,
        filename="video_archive_2026.mp4",
        content_type="video/mp4",
        uploader="ops_team",
        project="ku-aifram"
    )

print("大文件写入成功,生成唯一文件 ID:", file_id)
2. 查找与检索文件元数据
通过 fs.find_one() 或 fs.find() 可以检索已上传的文件。它们返回的是 GridOut 对象,该对象既包含元数据属性,也是一个可读的数据流:
# 按文件名查找最近上传的一个文件
grid_out = fs.find_one({"filename": "video_archive_2026.mp4"})

if grid_out:
    print("文件名:", grid_out.filename)
    print("文件大小:", grid_out.length, "字节")
    print("上传时间:", grid_out.upload_date)
    print("自定义项目元数据:", grid_out.project)
else:
    print("未找到指定文件")
3. 安全读取与流式下载
读取文件时有两类典型场景:
- 小文件(几兆至十几兆):可以直接调用
grid_out.read()一次性读取全部字节。 - 超大文件(数百兆或数吉字节):必须采用分段缓冲读取(Chunk-by-chunk streaming),避免内存溢出导致程序崩溃。
# 推荐:流式逐块写入本地磁盘,防止内存暴涨
output_filename = "downloaded_video.mp4"

grid_file = fs.get(file_id)

with open(output_filename, "wb") as local_f:
    # 每次读取 1MB 缓冲区
    while True:
        chunk = grid_file.read(1024 * 1024)
        if not chunk:
            break
        local_f.write(chunk)

print("文件已成功流式下载并保存至本地:", output_filename)
4. 删除文件与资源清理
当文件不再需要时,调用 fs.delete(file_id)。GridFS 会自动将 fs.files 中的元数据记录以及 fs.chunks 中所有对应该 file_id 的数据块全部物理删除:
# 按 ID 删除对应文件及所有关联切片
fs.delete(file_id)
print("文件及关联切片已彻底清理")
四、普通文档与 GridFS 方案对比与选型决策
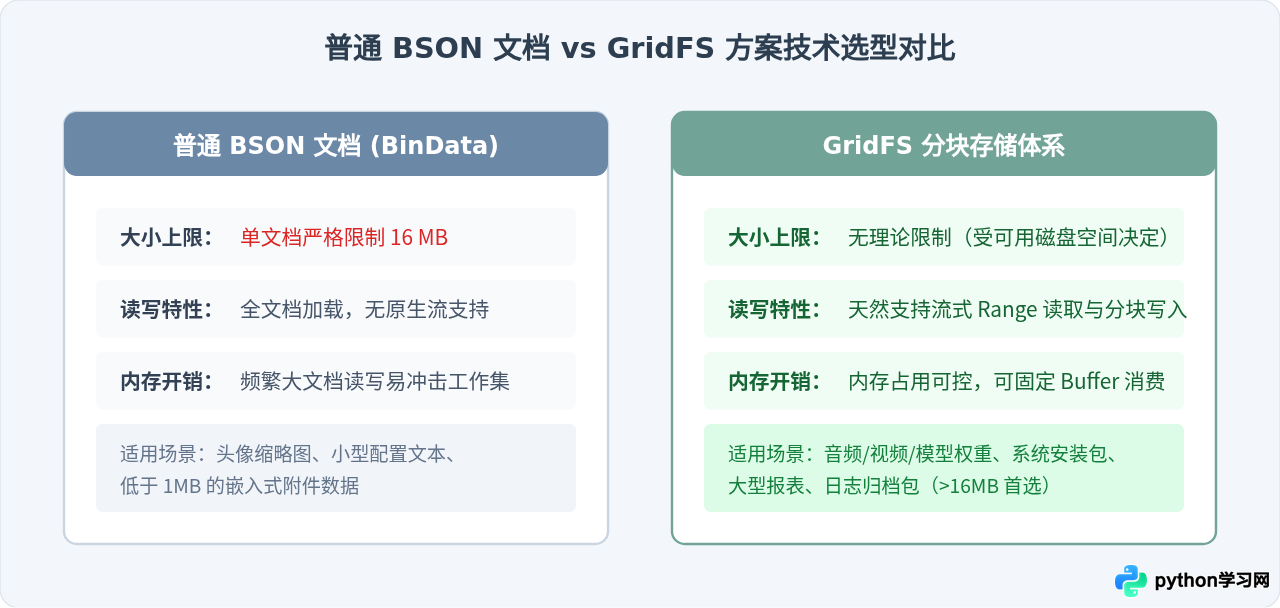
在设计系统存储时,不少开发者会纠结应该直接将二进制数据保存在常规文档中,还是统一接入 GridFS。两者的底层逻辑和适用边界存在明确差异:
五、生产环境核心配置与优化建议
在实际高并发或大吞吐生产环境中,若使用不当可能引发数据库响应变慢或内存激增。以下是经过验证的四项调优建议:
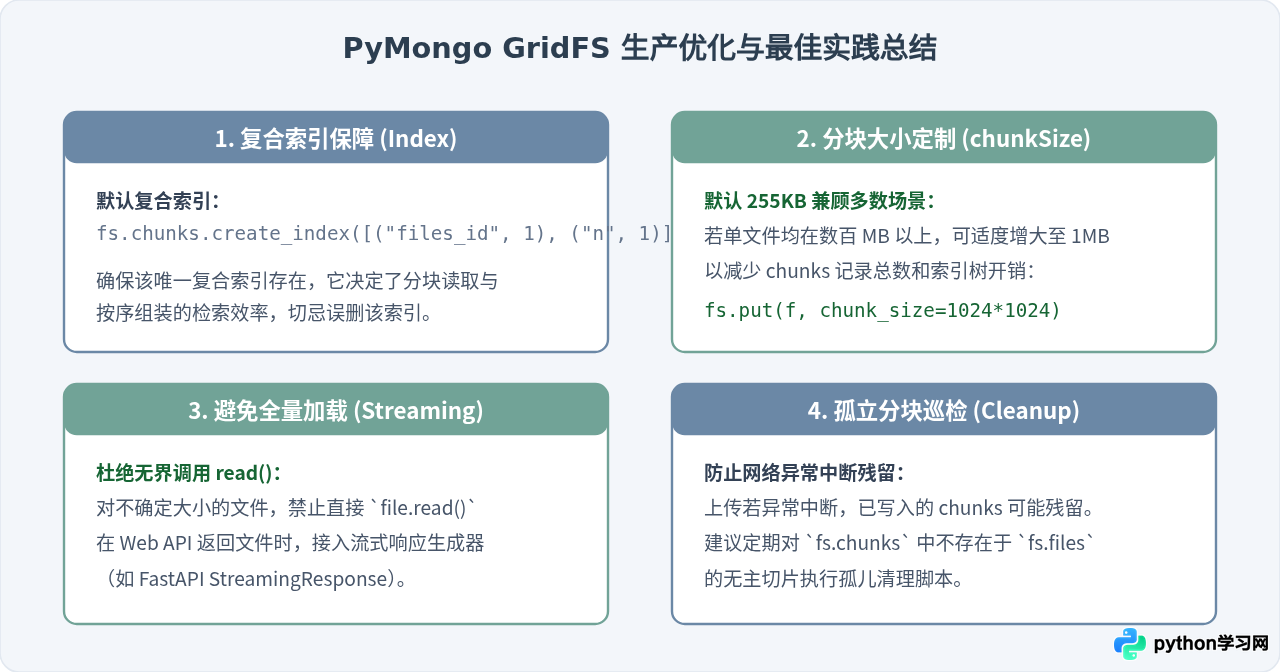
file_id,然后将旧的 file_id 删除,或者利用文件元数据中的版本标识进行历史版本归档。
六、总结
通过本文的讲解与代码实操,我们可以明确:
- GridFS 是解决 MongoDB 16MB 单文档限制的官方标准规范,由
fs.files与fs.chunks两个核心集合构成。 - Python 生态中无需安装额外工具,通过原生
pymongo.gridfs.GridFS即可实现完整的文件存取生命周期。 - 在读写大文件时,务必坚持流式读写(Streaming)原则,结合
files_id + n复合索引以及合理的chunk_size配置,即可构建高稳定、低内存消耗的大文件存储通道。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















