


Python列表推导式与传统for循环的代码对比示例
通过详实的代码示例、执行机制分析与多场景对比,全面解析Python列表推导式与传统for循环的语法映射、性能差异与选型规范。
在日常的 Python 编程中,从现有数据集合中过滤、清洗或转换数据并构建新列表是极其高频的操作。面对这类任务,开发者通常有两种主流实现方式:一种是编写多行传统的 for 循环并在循环体中调用 list.append();另一种则是使用 Python 独具特色的列表推导式(List Comprehension)。列表推导式能够用单行语法声明式地表达集合构建逻辑,不仅减少了样板代码,还在 CPython 解释器底层享有专门的字节码优化。本文将通过详尽的代码对比、结构映射、字节码分析及选型决策树,系统梳理两者的核心差异与适用边界。
一、语法结构映射:从多行控制到单行声明
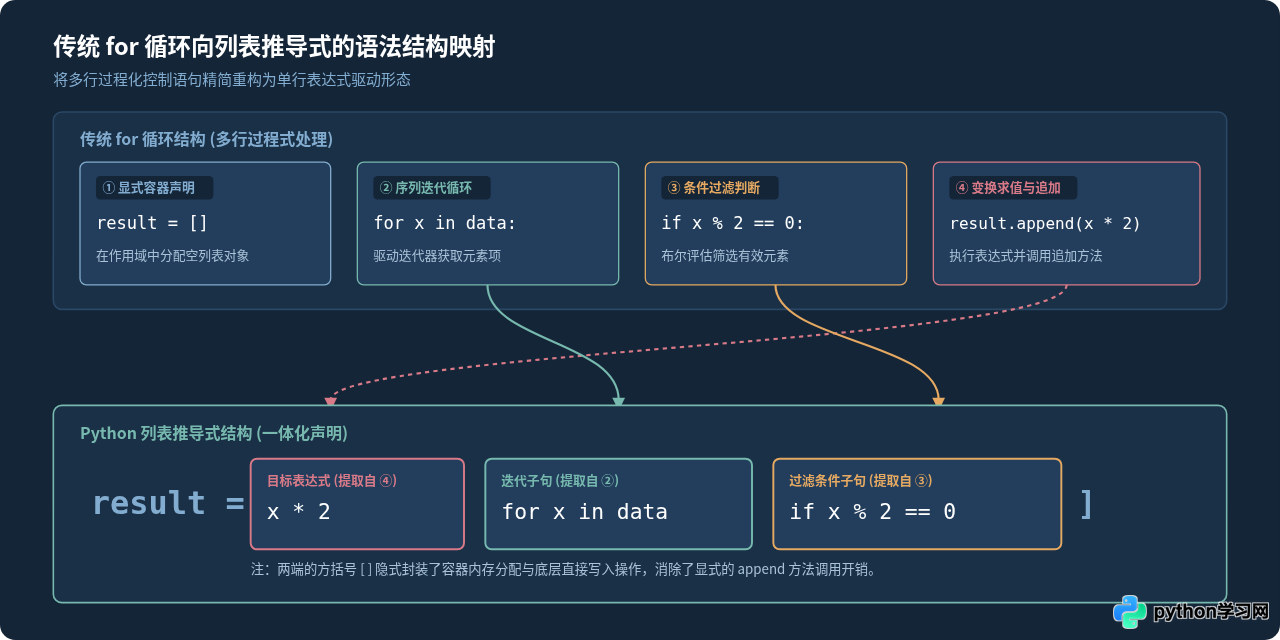
很多初学者在编写列表推导式时感到不习惯,往往是因为不清楚它与传统 for 循环各代码片段之间的直接对应关系。实际上,任何一个标准的基础列表推导式,都可以精准映射为传统 for 循环的四个组成部分:创建结果容器、遍历输入序列、条件过滤判断以及最终的求值与填充。
我们以一个典型的“提取偶数并将其翻倍”的清洗任务为例。在传统语法中,我们需要先在循环外显式声明一个空列表 result = [],随后通过 for x in data: 迭代源数据,在循环体内部利用 if x % 2 == 0: 剔除不符合要求的数据项,最后显式调用 result.append(x * 2) 将计算结果推入列表中。而在列表推导式中,最外层的方括号 [...] 承担了初始化容器与收集结果的双重职责,内部的三个子句则按特定规则重组:最终要计算的表达式被前置到最开头,遍历逻辑紧随其后,过滤条件则置于尾部。
二、四大典型场景代码对比示例
为了直观掌握两者的写法差异,下面针对工程中最常见的四种数据处理模式进行并排代码对比,涵盖基础无条件映射、单侧条件过滤、多维序列扁平化以及双分支三元变换。
场景一:无条件基础映射(Mapping)
任务需求:给定一组整数,生成包含其各自平方数的新列表。
# 传统 for 循环写法
numbers = [1, 2, 3, 4, 5]
squared_traditional = []
for n in numbers:
    squared_traditional.append(n ** 2)

# 列表推导式写法
squared_comprehension = [n ** 2 for n in numbers]

# 示例验证输出
print(squared_traditional)    # 示例输出: [1, 4, 9, 16, 25]
print(squared_comprehension)  # 示例输出: [1, 4, 9, 16, 25]
在基础映射场景下,列表推导式的优势最为明显。传统写法需要 4 行代码,引入了中间状态变量并在循环体内反复调用方法;推导式仅需 1 行,直截了当地表达了“将每个 n 映射为 n ** 2”的意图,语义纯粹且阅读负担极低。
场景二:带单侧条件过滤(Filtering)
任务需求:从原始字符串列表中,过滤出长度大于等于 5 的单词,并全部转换为大写字母。
words = ["python", "go", "rust", "typescript", "c", "javascript"]

# 传统 for 循环写法
filtered_traditional = []
for w in words:
    if len(w) >= 5:
        filtered_traditional.append(w.upper())

# 列表推导式写法
filtered_comprehension = [w.upper() for w in words if len(w) >= 5]

# 示例验证输出
print(filtered_traditional)    # 示例输出: ['PYTHON', 'TYPESCRIPT', 'JAVASCRIPT']
print(filtered_comprehension)  # 示例输出: ['PYTHON', 'TYPESCRIPT', 'JAVASCRIPT']
当推导式中仅包含单侧过滤时,if 子句置于整个语句的最右侧。只有满足布尔条件的项目,才会流向最左侧的 w.upper() 进行表达式求值,不满足条件的项目会被直接略过,不会产生任何多余的对象创建。
场景三:二维嵌套结构扁平化(Flattening)
任务需求:将一个由若干子列表组成的二维矩阵展平成一维列表。
matrix = [
    [1, 2, 3],
    [4, 5, 6],
    [7, 8, 9]
]

# 传统 for 循环写法(双重嵌套循环)
flat_traditional = []
for row in matrix:
    for item in row:
        flat_traditional.append(item)

# 列表推导式写法
flat_comprehension = [item for row in matrix for item in row]

# 示例验证输出
print(flat_traditional)    # 示例输出: [1, 2, 3, 4, 5, 6, 7, 8, 9]
print(flat_comprehension)  # 示例输出: [1, 2, 3, 4, 5, 6, 7, 8, 9]
for 语句的书写顺序与传统多层循环完全相同。最先执行的外层循环 for row in matrix 排在前面,随后的内层循环 for item in row 紧跟其后。不可颠倒两者的先后次序,否则解释器会因无法识别尚未绑定的变量而报错。
场景四:包含双分支的三元条件表达式(Transforming)
任务需求:对一组数值进行奇偶标记,偶数生成字符串 "even",奇数生成字符串 "odd"(全量保留,非丢弃过滤)。
values = [10, 15, 22, 33, 40]

# 传统 for 循环写法
labeled_traditional = []
for v in values:
    if v % 2 == 0:
        labeled_traditional.append("even")
    else:
        labeled_traditional.append("odd")

# 列表推导式写法(结合 if-else 三元表达式)
labeled_comprehension = ["even" if v % 2 == 0 else "odd" for v in values]

# 示例验证输出
print(labeled_traditional)    # 示例输出: ['even', 'odd', 'even', 'odd', 'even']
print(labeled_comprehension)  # 示例输出: ['even', 'odd', 'even', 'odd', 'even']
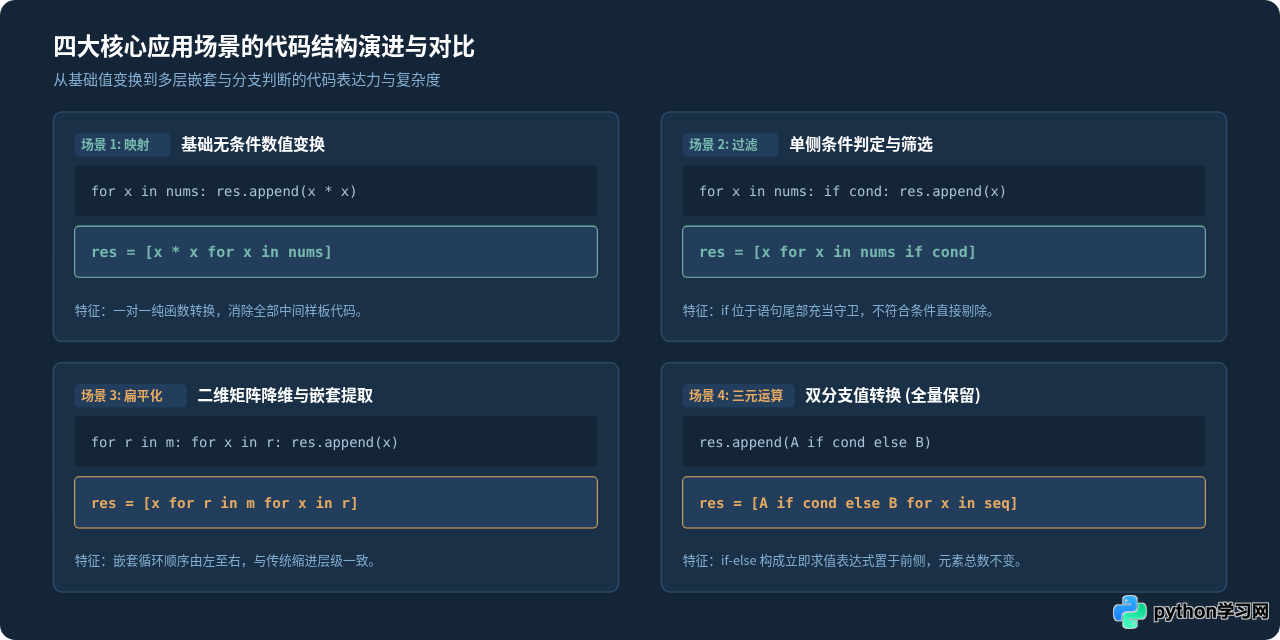
初学者极易混淆场景二与场景四中的 if 位置。核心判别标准在于:如果你希望过滤丢弃部分元素,if 放在 for 的右侧作为守卫;如果你希望转换所有元素的值(比如偶数转 A,奇数转 B),则必须使用完整的 A if condition else B 三元表达式,且必须放置在 for 的左侧。
三、底层执行机制与性能差异剖析
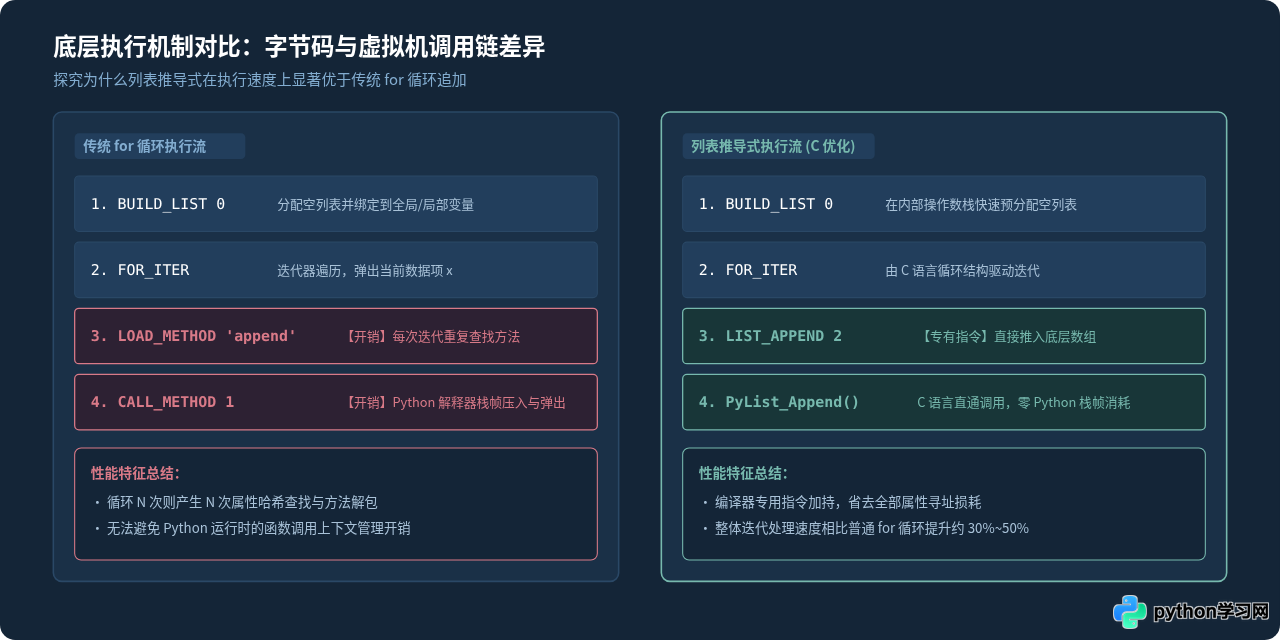
许多开发者知道列表推导式通常比传统 for 循环更快,但往往将其误解为“编译器宏展开”或“某种黑魔法”。通过 Python 内置的 dis 模块反编译两者的字节码,我们可以清晰地揭示其执行效率差距的真正根源。
以下是使用 dis.dis 对两种写法生成的字节码指令简化对比:
# 传统 for 循环反编译片段
  2           0 BUILD_LIST               0
              2 STORE_FAST               1 (result)
  3           4 LOAD_FAST                0 (data)
              6 GET_ITER
        >>    8 FOR_ITER                16 (to 26)
             10 STORE_FAST               2 (x)
  4          12 LOAD_FAST                1 (result)
             14 LOAD_METHOD              0 (append)  # <-- 核心损耗点 1: 运行时属性查询
             16 LOAD_FAST                2 (x)
             18 CALL_METHOD              1           # <-- 核心损耗点 2: Python 级别函数调用帧
             20 POP_TOP
             22 JUMP_ABSOLUTE            8

# 列表推导式反编译片段
  2           0 BUILD_LIST               0
              2 LOAD_FAST                0 (data)
              4 GET_ITER
        >>    6 FOR_ITER                 8 (to 16)
              8 STORE_FAST               1 (x)
             10 LOAD_FAST                1 (x)
             12 LIST_APPEND              2           # <-- 核心优化点: 专门的 C 级指令直推
             14 JUMP_ABSOLUTE            6
通过字节码对比可以清楚看到,传统 for 循环在每一次迭代过程中,都必须执行 LOAD_METHOD 与 CALL_METHOD 指令。这意味着 Python 虚拟机每次都要在列表对象的属性字典中检索 append 方法,为其在解释器栈上建立调用上下文,并在调用完成后弹出栈帧。当循环执行数十万次时,这部分属性查询与函数调用开销将极其庞大。
而在列表推导式中,CPython 编译器能识别出该结构是在构建新列表,因此直接生成了专用的 LIST_APPEND 字节码。该指令由 C 语言底层编写的虚拟机内部直接处理,直接向底层的 PyListObject 缓冲区末尾写入指针并递增长度,完全绕过了 Python 层面的方法查找与函数调用栈开销。因此在纯 Python 解释器环境下,列表推导式的执行耗时通常比传统 for 循环减少 30% 到 50%。
四、工程选型指南与使用边界
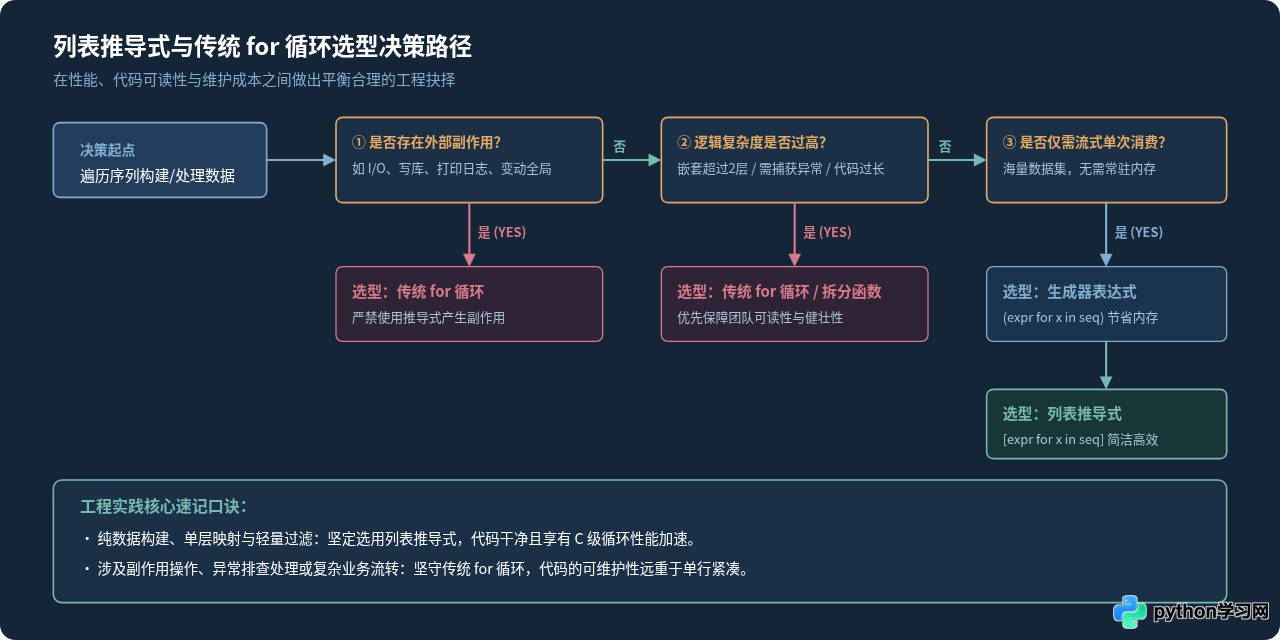
尽管列表推导式在代码简洁度与底层性能上表现优异,但在实际工程协作中,并不意味着应该盲目把所有 for 循环都替换成推导式。编写代码的首要目标是清晰可读和便于维护,过度追求将复杂逻辑压缩进一行推导式,往往会演变成反模式。
1. 什么时候必须放弃推导式,退回传统 for 循环?
- 包含外部副作用(Side Effects):如果循环体的主要目的是向磁盘写入文件、打印日志、发起网络请求或修改外部全局状态,而不是为了生成一个新列表,严禁使用列表推导式。例如
[print(x) for x in data]是一种极度糟糕的反模式,它不仅白白在内存中构建了一个充满None的无用临时列表,还混淆了表达意图。 - 超过 2 层的复杂嵌套:虽然 Python 语法允许编写三重甚至四重嵌套的列表推导式,但超过两层后,团队成员几乎无法在一瞥之间看懂循环嵌套顺序与变量依赖,此时必须回退为清晰的传统多层
for循环,或封装为生成器函数。 - 需要异常处理(try-except):列表推导式内部无法内嵌
try...except语句块。如果迭代转换过程中某些项可能抛出异常(例如类型转换错误或网络解析失败),必须使用传统for循环进行精确的捕获与降级处理,或者单独定义捕获异常的独立辅助函数。 - 单行长度过长、包含过多复杂子条件:当一行推导式需要跨多行折行、包含多个
and/or判断与复杂的内联计算时,其可读性已经远低于排版规范的过程化for循环。
2. 内存敏感场景:列表推导式 vs 生成器表达式
列表推导式会在内存中一次性分配并实例化整个列表。如果源数据集包含数千万条记录(例如读取大体积日志文件),列表推导式会导致瞬时内存占用暴增甚至引发 MemoryError。若后续业务只需对结果进行单次流式消费,应将外层方括号 [...] 替换为圆括号 (...),改用生成器表达式(Generator Expression)进行惰性按需求值。
五、全维度对比总结
综合以上对语法机制、运行性能与工程场景的探讨,我们将 Python 列表推导式与传统 for 循环的核心属性汇总如下表:
| 对比维度 | 传统 for 循环 + append | Python 列表推导式 |
|---|---|---|
| 语法风格 | 过程式控制,依赖多行缩进与显式状态变量 | 声明式表达,单行聚焦于“输入序列到输出结果”的映射 |
| 底层虚拟机指令 | LOAD_METHOD + CALL_METHOD(动态寻址与调用帧) |
LIST_APPEND(CPython 底层专有 C 级追加指令) |
| 运行性能 | 基准耗时(包含方法查询与 Python 栈帧开销) | 通常比传统方式快 30% 到 50% |
| 异常捕获能力 | 支持在循环体内部直接使用 try...except 块 |
不支持内部直接捕获异常,需依赖外部预定义包装函数 |
| 副作用(Side Effects) | 天生适合执行文件写入、日志打印、网络交互等操作 | 反模式,严禁用于执行非纯函数式的副作用操作 |
| 多层嵌套表达 | 多层缩进结构清晰,易于单步断点调试与排查 | 超过 2 层嵌套后可读性急剧恶化,难以维护 |
| 惰性求值扩展 | 可改写为包含 yield 的独立生成器函数 |
直接将 [...] 替换为 (...) 即可无缝转换为生成器表达式 |
通过本文的代码示例与深入拆解,我们可以建立一个清晰的认知:列表推导式不是为了彻底取代 for 循环,而是为集合转换这一高频场景提供了更高阶、更富表现力且底层经过高度优化的专门语法工具。理解它们的底层差异与适用边界,能够帮助我们在日常编码中游刃有余地写出既优雅又高效的 Python 代码。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















