


在线运行Python代码超时或报错怎么解决
针对网页端在线Python运行工具出现的Timeout超时与各类运行报错,系统梳理问题原因、排查路径、算法优化方案与环境适配技巧,帮助开发者快速定位并解决代码执行故障。
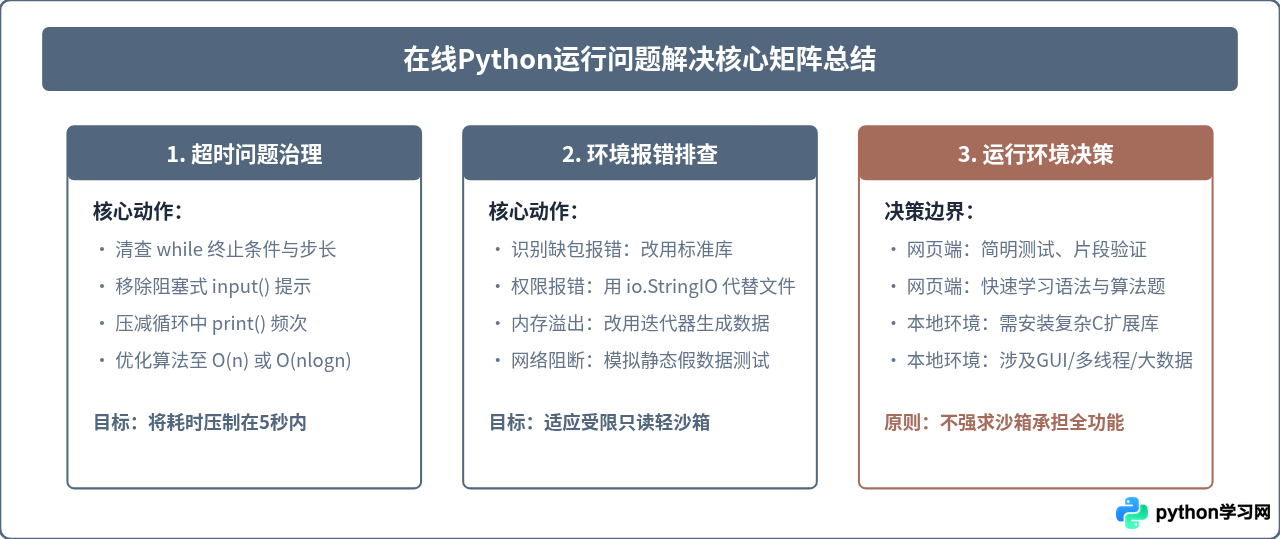
在网页端在线运行Python代码时遭遇“超时(Execution Timeout)”或“报错(Runtime Error / Sandbox Error)”,其核心症结在于在线沙箱所施加的受限资源配额(CPU执行时长上限通常为5至15秒、内存常限制在128MB至512MB以内、且禁止本地文件持久化与任意网络连接)与用户代码的计算特征之间产生了冲突。解决这一问题的标准路径包括:首先检查代码是否存在死循环与阻塞式标准输入,其次降低算法时间复杂度与精简内存占用,最后排查受沙箱机制禁止的文件及网络操作,并针对无法绕过的算力限制合理切换至本地终端执行。
一、认识在线运行环境的约束机制
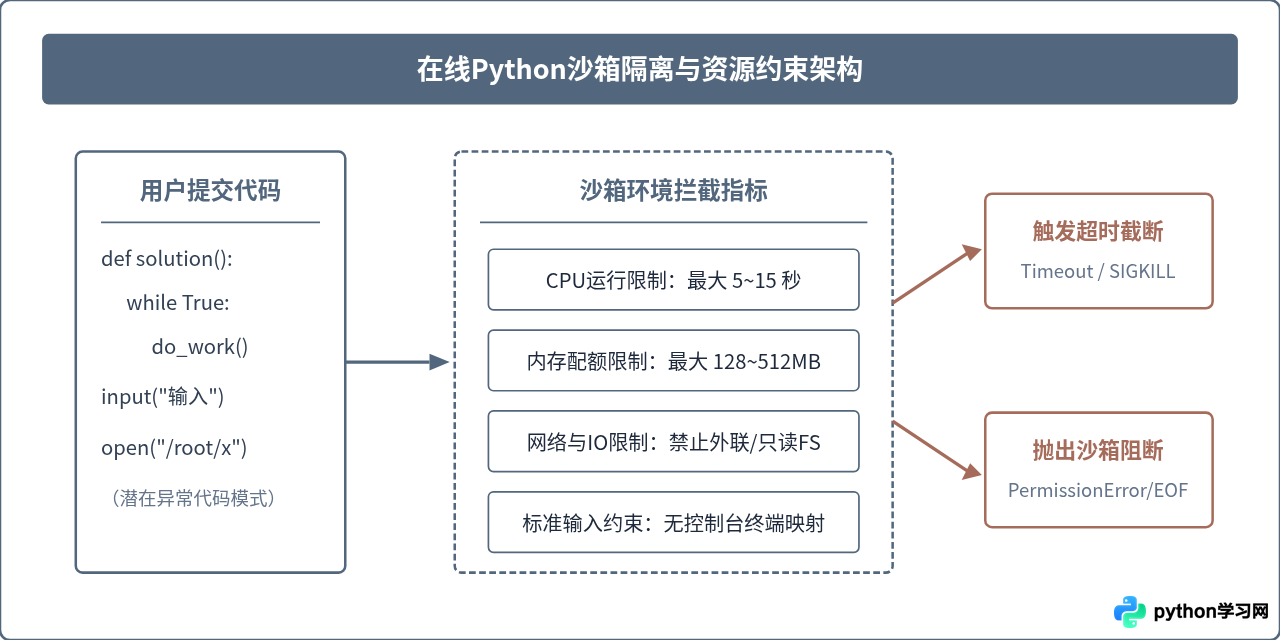
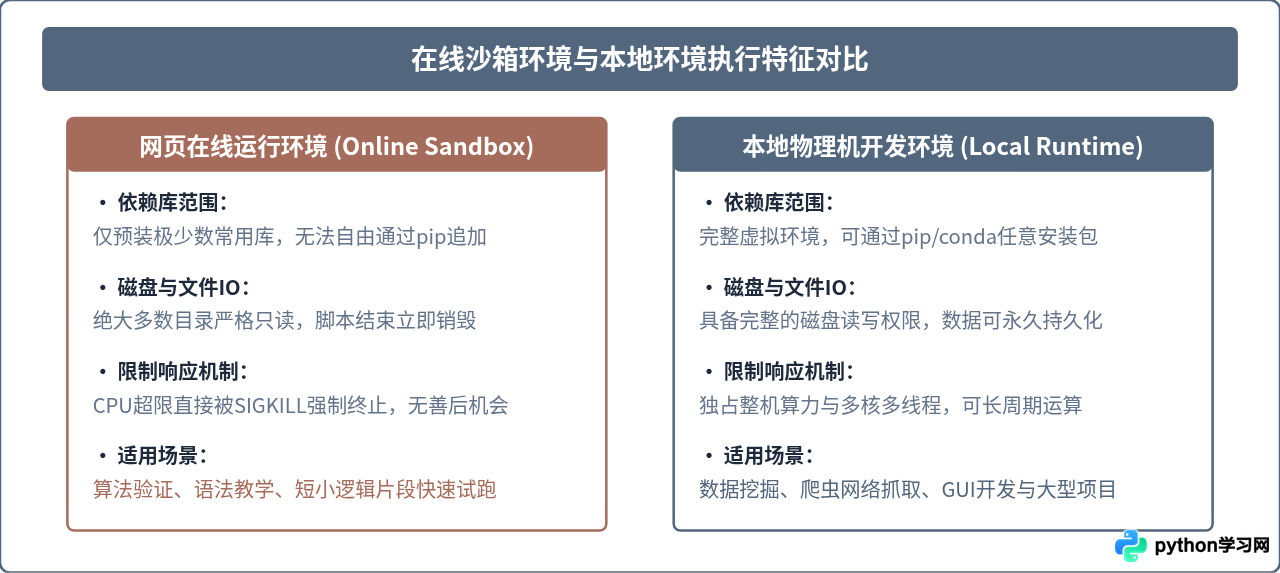
不同于拥有完整操作系统权限与可扩容硬件资源的本地电脑,诸如菜鸟教程在线工具、LeetCode演习场、Jupyter Lite或各类云端编程沙箱,均运行于高密度的轻量化容器(如Docker或WASM沙箱)中。服务端为了保障多租户系统的稳定与防范恶意攻击,会对执行环境施加严格的边界策略:
- CPU单次执行时长阈值:多数在线服务严格设定了5到15秒的硬性超时(Wall-clock或CPU Time)。一旦超出限额,守护进程将直接向进程发送
SIGKILL终止信号。 - 无阻塞交互支持:大量在线IDE不支持实时的键盘标准输入(
input()),若代码停在输入流等待状态,将直接挂起直至超时触发。 - 系统调用与网络拦截:利用沙箱的安全机制(如Linux seccomp或ptrace),阻断
socket网络连接、底层系统派生进程(os.fork、subprocess)以及对只读根目录的写入操作。 - 严格的内存天花板:内存使用量越界将直接引发
Memory Limit Exceeded报错并强制退出。
二、超时(Timeout)问题的针对性排查与解决步骤
执行超时并不一定代表代码计算量巨大。根据实际调试经验,超过八成的在线运行超时是由低级逻辑陷阱引起的。请按照以下步骤自查:
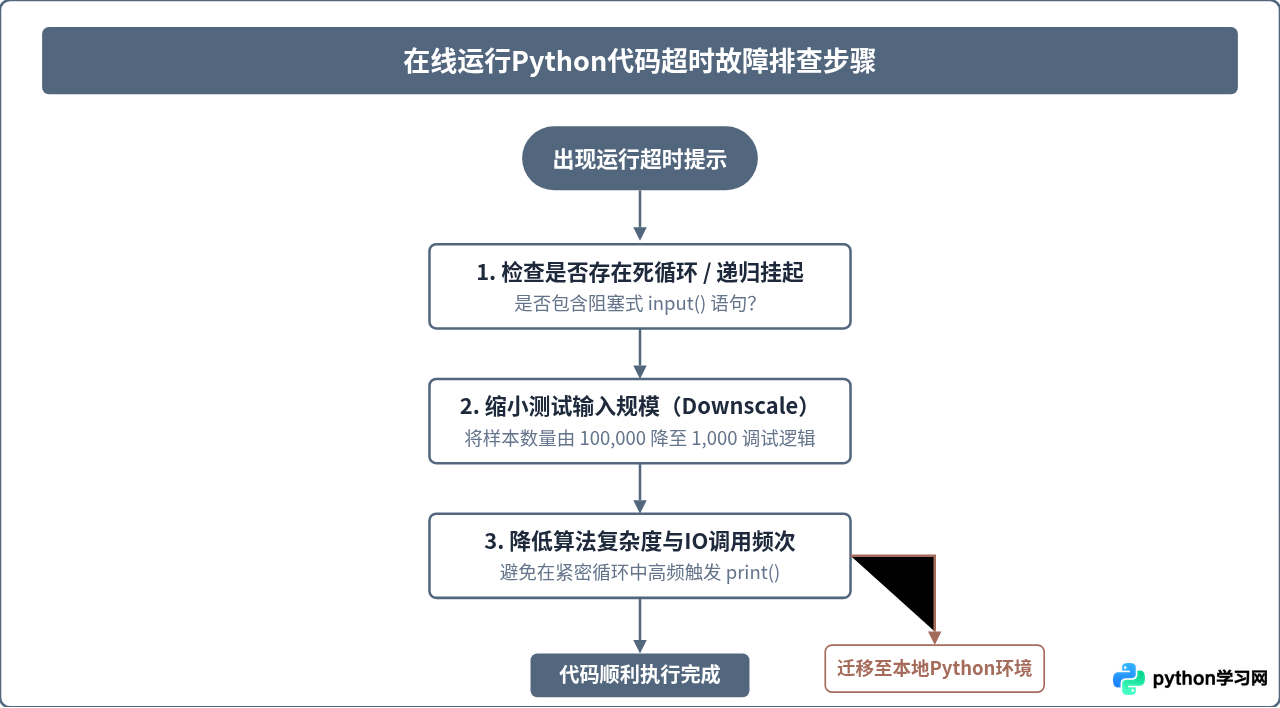
步骤1:排查死循环与递归终止条件
检查所有 while 循环是否有明确递增的步进条件,以及递归函数中是否存在可抵达的基础退出用例(Base Case)。
# 常见错误:循环步长漏写或条件始终成立导致超时
i = 0
while i < 100:
    # 漏写 i += 1 导致死循环
    pass

# 修复方案:确保迭代有严格边界,或改用 for 循环
for i in range(100):
    pass
步骤2:剔除阻断式 input() 调用
部分基础在线评测平台无法提供标准输入交互界面,调用 input() 时,程序会无限期挂起等待缓冲区,最终由守护计时器强制掐断。在在线运行前,应当用写死参数或虚拟数据代替动态输入:
# 不推荐在线运行模式:
# user_data = input("请输入数据:")

# 推荐在网页环境调试时直接硬编码参数:
user_data = "sample_test_payload"
步骤3:优化时间复杂度过高的高阶算法
如果计算数据规模在 \(10^5\) 级别,嵌套的双重循环(复杂度为 \(O(n^2)\))运算量将达到 \(10^{10}\) 次操作,在Python单线程解释器下通常需要数十秒以上,必然被在线环境强制截断。使用字典或集合将查找复杂度由 \(O(n)\) 降至 \(O(1)\) 是最直接的优化手段。
三、常见运行报错分类诊断与解决
除了超时之外,在线运行时捕获的错误通常伴随着详细的回溯栈(Traceback)。理解常见错误类型有助于快速对症下药:
| 报错类型 | 典型触发场景 | 直接修复方案 |
|---|---|---|
ModuleNotFoundError |
在未预装对应包的网页环境中执行 import requests 或 pandas |
改用标准库(如 urllib.request)或在支持的环境中使用 !pip install 安装。 |
EOFError: EOF when reading a line |
网页端后台未接入标准输入流,执行 input() 直接读取到文件终止符 |
直接在代码变量区赋初始值,移除所有 input() 语句。 |
PermissionError / OSError |
尝试在系统根路径或未挂载目录创建持久化文件 | 将写入路径切换至系统临时目录 /tmp/,或改用内存流 io.StringIO。 |
MemoryError |
创建了超出数百兆的超大列表或一次性读取海量文本 | 改用生成器(yield)迭代,或分块流式解析数据。 |
四、两类典型问题代码的重构范例
范例一:降低高频输出与减少字符串拼接损耗
很多初学者喜欢在深层循环中频繁调用 print() 来观察进度。在浏览器端,每一次打印都意味着后端服务需要缓冲或通过 WebSocket 推送至前端 DOM 进行渲染。数万次控制台打印足以将网页卡死或撑爆后端网络缓冲队列造成超时。
# 导致超时的低效写法:频繁IO打印 + 低效字符串累加
text = ""
for i in range(100000):
    text += str(i)
    if i % 1000 == 0:
        print(f"进度: {i}")  # 高频IO在网页沙箱中极易诱发超时

# 优化后的高效写法:批量拼接 + 聚合输出
chunks = [str(i) for i in range(100000)]
final_text = "".join(chunks)
print("任务执行完毕,结果长度为:", len(final_text))
范例二:规避无权限文件操作,改用内存流
很多数据处理教程会指导读者使用 open("data.csv", "w")。在多数在线工具中,只读文件系统会直接抛出 PermissionError。若仅需验证CSV输出逻辑,可以使用Python自带的标准库 io.StringIO 将数据在内存中虚拟化为文件对象:
import io
import csv

# 内存虚拟文件对象,完全规避沙箱磁盘权限阻断
virtual_file = io.StringIO()
writer = csv.writer(virtual_file)
writer.writerow(["id", "name", "score"])
writer.writerow([1, "Alice", 95])
writer.writerow([2, "Bob", 88])

# 检验数据生成结果
virtual_file.seek(0)
print(virtual_file.read())
五、在线运行代码排查与总结体系
当遇到在线运行不可用的情况时,可以建立起一套固定的判断清单:
- 先语法后逻辑:确认代码本地是否有语法错误(
SyntaxError),优先保证基础语法正确。 - 除掉输入交互:将所有
input()替换为预置变量。 - 剪裁运算规模:将循环次数、数组长度人为压缩至原来的 1% 验证算法流程。
- 去除外联与磁盘动作:移除爬虫抓取(
requests.get)、GUI窗口渲染(matplotlib.pyplot.show()、tkinter)以及物理文件写入。 - 果断转移至本地:对于涉及大型第三方库(如 PyTorch、OpenCV)或长耗时计算任务,在线网页环境本质上并非合适载体,及时转向本地安装的 Python 解释器或配置完整的 VS Code / PyCharm 开发环境才是根本解决方案。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















